Blog/MI-ágensek
Egy senior MI-ügynökökkel vagy egy csapattal: mit mondanak a bizonyítékok
A METR, DORA, Microsoft és GitHub kutatásai az MI-kódolóeszközökről, azok korlátai, és egy break-even modell: senior, csapat vagy ügynökség?
Balázs Csorba··11 perc olvasás
- AI coding agents
- Developer productivity
- Engineering economics
- Team cost
- GDPR
A lényeg röviden
- A tanulmányok ellentmondanak egymásnak, és a minta hasznos: egy 2025-ös kísérletben a tapasztalt fejlesztőknek ismerős kódbázisokon 19%-kal tovább tartottak a feladatok MI-vel, míg egy 2023-as kísérletben egy jól körülhatárolt feladat a Copilottal 55,8%-kal kevesebb időt vett igénybe.
- Mérd a nettó nyereséget végponttól végpontig, a tickettől az élesítésig, azonos minőségen. A vázlatnál szerzett időnyereséget a review, az újramunka és az incidensek felemészthetik.
- A break-even egyszerű: a nettó nyereségnek meg kell haladnia a tool-, review- és minőségi költségeket, a teljes terhelt költség arányában kifejezve.
- Egy senior ügynökökkel a kockázatot egy személyre és egy szolgáltatóra koncentrálja. A döntés előtt tervezz be egy második átnézőt, írásos runbookot és tartalékot.
- Kössél adatfeldolgozási szerződést, és írásban erősítsd meg a tanítást és a feldolgozás helyét, mielőtt ügyféladat kerül egy promptba, ahogy a GDPR 28. cikke az adatfeldolgozóknál előírja.
Ha te a mérnökséget vagy a pénzügyeket vezeted, hamarosan felmerül a kérdés: el tud-e végezni egy senior fejlesztő kódoló ügynökökkel egy csapat vagy egy ügynökség munkáját? Ezt az összehasonlítást senki nem mérte közvetlenül. A létező tanulmányok a részeit mérik, és néhány eredmény meglepte azokat, akik elvégezték őket. A válaszom nem ítélet, hanem egy break-even teszt. Egy senior ügynökökkel csak akkor nyer, ha a nettó produktivitásnövekedés a te munkádon meghaladja az eszközök, a review és a minőség költségeit, a fejlesztő teljes terhelt költségének arányában kifejezve.
Mit mértek a tanulmányok
A legnagyobb nyereséget mutató kontrollált kísérletek kódkiegészítő asszisztenseket mértek jól körülhatárolt feladatokon. A 2025-ös kísérlet Claude-modelleket használó MI-kódszerkesztővel dolgozott valós hibajegyeken. A saját kimenetüket tervező, parancsokat futtató és ismétlően javító ügynököket kevésbé vizsgálták. Ezért minden számot úgy olvasd, mint egy adott eszköz, egy adott év és egy adott feladattípus pillanatfelvételét.
A kísérlet, amely lassulást talált
A METR, egy non-profit szervezet, amely MI-rendszereket értékel, 2025 elején randomizált kísérletet futtatott 16 tapasztalt nyílt forráskódú fejlesztővel. Ők 246 valós hibajegyen dolgoztak érett tárolókban. Minden hibajegyről véletlenszerűen döntöttek, hogy szabad-e rajta MI-t használni. A kísérlet előtt a fejlesztők azt várták, hogy az MI 24%-kal csökkenti az idejüket. Utána 20%-os csökkenést becsültek. A mért idő az ellenkező irányba mozdult: az MI-vel végzett feladatok 19%-kal tovább tartottak, a konfidenciaintervallum +2% és +39% között volt.
Két tanulság következik ebből. A fejlesztők tévedtek a saját sebességükről, ezért az, hogy az emberek mennyire gyorsnak érzik magukat, nem mérés. A minta kicsi, az eszközök 2025 eleji modellek voltak, és a kód ismerős volt a dolgozók számára. A szerzők a kísérleti beállítás 20 tulajdonságát ellenőrizték, és azt találták, hogy a lassulás minden elemzésükben megmaradt. Úgy gondolják, hogy az MI máshol hasznos lehet, például kevésbé tapasztalt fejlesztőknél vagy ismeretlen kódbázisokban.
A folytatás, amely semmit sem döntött el
A METR második kísérlete 2025 augusztusában indult, 57 fejlesztővel, 143 tárolóval és több mint 800 feladattal. 2026 februárjában a szerzők megbízhatatlan jelnek nevezték az adatokat. Azok a fejlesztők, akik nem akartak MI nélkül dolgozni, úgy döntöttek, nem vesznek részt, ami valószínűleg lefelé torzítja a becslést. A díjazás is 150 dollárról 50 dollárra csökkent óránként, ami befolyásolhatta, kik csatlakoztak. A szerzők szerint a fejlesztők valószínűleg gyorsabbak most, de az adataik nagyon gyenge bizonyítékot jelentenek e nyereség mértékére, és a konfidenciaintervallumok tartalmazzák a nullát.
Kontrollált kísérletek nagy nyereséggel
Egy 2023-as GitHub-kísérletben 95 fejlesztőt véletlenszerűen egy Copilot-csoportba és egy kontrollcsoportba osztottak, és mindenkit arra kértek, hogy a lehető leggyorsabban építsen egy HTTP-szervert JavaScriptben. A Copilot-csoportnak átlagosan 71 percre volt szüksége 161 perc helyett, ez 55,8%-os csökkenés, 95%-os konfidenciaintervallum 21% és 89% között. Csak mintegy 35 fejlesztő fejezte be a feladatot, a sikerességi arány különbsége pedig nem volt statisztikailag szignifikáns. Több szerző a GitHubnál vagy a Microsoft Research-nél dolgozik, így a tanulmány nem független a szolgáltatótól.
A listában szereplő legnagyobb minta három cégtől származik. A Microsoft, az Accenture és egy névtelen Fortune 100-as cég kutatói a normál működés közben véletlenszerűen kiválasztott fejlesztőcsoportoknak kódkiegészítő MI-asszisztenst adtak. A 4 867 fejlesztőt összevonva a szerzők a befejezett feladatok 26,08%-os növekedését becsülik, 10,3%-os standard hibával. A kevésbé tapasztalt fejlesztők többet nyertek, ezért egy senior valószínű nyeresége az átlag alatt van.
Mit mondanak a felmérések a bizalomról és a kiadásokról
A Google Cloud 2024-es DORA-jelentése korrelációs, ezért összefüggésként olvasd, nem okként. Az MI-használat 25%-os növekedése együtt járt a kódminőség 3,4%-os és a kódreview sebességének 3,1%-os javulásával, de a kiadási áteresztőképesség 1,5%-os és a kiadási stabilitás 7,2%-os csökkenésével is. A válaszadók 39%-ának kevés vagy nincs bizalma az MI által generált kódban. A 2025-ös jelentés, amely közel 5000 technológiai szakembert kérdezett meg, élesebben fogalmaz: az MI felerősíti azt, amit egy szervezet már jól vagy rosszul csinál.
A Stack Overflow 2025-ös fejlesztői felmérése ugyanezt a feszültséget mutatja az egyéneknél. A válaszadók 84%-a használ MI-eszközöket, vagy tervezi, hogy használni fogja őket, a szakmai fejlesztők 51%-a pedig naponta használja őket. Mégis 46% nem bízik az MI-eszközök pontosságában, szemben a 33%-kal, aki megbízik bennük. A leggyakoribb bosszúságot, amelyet 66% nevezett meg, az jelenti, hogy a kimenet majdnem jó, de nem egészen, és 45% szerint ezek hibakeresése több időt vesz igénybe.
Az 1. táblázat a főbb eredményeket a korlátaikkal együtt mutatja.
| Tanulmány | Mit mértek | Fő eredmény | Amit nem mutat |
|---|---|---|---|
| METR, 2025 | 16 tapasztalt fejlesztő, 246 valós hibajegy | 19%-kal tovább tartottak MI-vel | 2025 végi eszközök, más kódbázisok |
| METR, 2026 február | 57 fejlesztő, 800+ feladat | A konfidenciaintervallumok tartalmazzák a nullát | Megbízható sebességnövekedési szám |
| GitHub, 2023 (Peng et al.) | 95 véletlenszerűen kiosztott fejlesztő, egy HTTP-szerver feladat | 55,8%-kal kevesebb idő | Karbantartási munka vagy hosszú projektek |
| Microsoft, Accenture, Fortune 100-as cég | 4 867 fejlesztő három terepkísérletben | +26,08% befejezett feladat | Ügynökök, vagy a minőség az összevonás után |
| DORA, 2024 | IT-szakemberek felmérése | Használat 25%-os növelésenként: −1,5% áteresztőképesség, −7,2% stabilitás | Ok-okozati viszony (korrelációs) |
| Stack Overflow, 2025 | Fejlesztői attitűdök | 46% nem bízik az MI pontosságában, 33% bízik | A tényleges produktivitás |
| Google, migrációk, 2025 | 39 kódmigráció, 595 változtatás | A változtatások 74,45%-át LLM generálta | Új funkciók; a nagyjából felényi megtakarítás becslés |
| Meta, TestGen-LLM, 2024 | Egységtesztek az Instagram Reels és Stories számára | 75% épült, 57% megbízhatóan lefutott | A tesztcsomagokon kívüli kód |
Hol térül meg az ügynök, és hol nem
A minta meglehetősen következetes. A nyereség akkor jelentkezik, ha a feladat körülhatárolt, egy automatikus ellenőrzés dönti el, hogy az eredmény helyes-e, és egy embernek csak el kell olvasnia a kimenetet. A nyereség csökken, ha a munka a kódon kívüli kontextustól függ, vagy ha a kódbázis olyan nagy és ismerős, hogy minden változtatást sorról sorra kell ellenőrizni.
- Tesztek egy szűrő mögött. A Meta TestGen-LLM-je csak olyan jelölteket javasol, amelyek átmennek az automatikus ellenőrzéseken, és mérhető javulást hoznak. Az Instagram Reels és Stories felületén a tesztesetei 75%-a sikeresen lefordult, 57%-a megbízhatóan lefutott, és 25%-kal nőtt a lefedettség. A mérnökök a javaslatainak 73%-át elfogadták.
- Migrációk. A Google 39 migrációjáról szóló beszámolójában a beküldött változtatások 74,45%-a és a szerkesztések 69,46%-a LLM által generált volt. A mérnökök becslése szerint az összes idő nagyjából a felével csökkent. Ez becslés, nem mérés.
- Jól körülhatárolt feladatok egyértelmű céllal. A GitHub-kísérlet 55,8%-os nyeresége pontosan ilyen feladatból származott.
- Ismeretlen kód és kevésbé tapasztalt fejlesztők. A terepkísérletekben a legnagyobb nyereség a kevésbé tapasztalt fejlesztőknél jelentkezett, a METR pedig az ismeretlen kódbázisokat nevezi meg olyan helyként, ahol az MI segíthet.
- Ismerős, érett kód. A METR kísérletében az olyan tárolókban lévő feladatok, amelyeket a fejlesztők jól ismertek, 19%-kal tovább tartottak, amikor az MI engedélyezett volt.
- Nem egyértelmű követelmények. A tanulmányok ezt nem mérik. Az én olvasatom szerint a költség a review-nál jelentkezik: az ügynök a kapott követelményre hihető kódot állít elő, a seniornak pedig ellenőriznie kell, hogy a helyes követelményt kapta-e.
- Review és újramunka. A majdnem jó, de nem egészen jó kimenet a Stack Overflow-felmérés legnagyobb bosszúsága. A GitClear, amely kódváltozási adatokat elemez, szerint a refaktorált sorok aránya a változtatott sorokon belül 2021-ben 25% volt, 2024-re pedig 10% alá esett, miközben a másolt-beillesztett sorok aránya 8,3%-ról 12,3%-ra nőtt. Ez az összefüggés nem bizonyíték az okra. A review oldalához lásd a jegyzetemet: Az MI-kód-review mára szűk keresztmetszet.
- Tudás a tárolón kívül. Az árazási szabályok, a szabályozási logika és az ügyfelek sajátosságai nincsenek azokban a fájlokban, amelyeket az ügynök olvas, és ennek a kontextusnak az összeírása a senior idejét viszi el.
Az összehasonlítás, amelyet senki nem mért
Nem találtam olyan tanulmányt, amely egy senior fejlesztőt ügynökökkel egy csapattal vagy egy ügynökséggel hasonlítana össze ugyanazon a hatókörön, minőségi mércén és ugyanazon az ügyfélen. Az összehasonlítást mért részekből kell összeállítani: a senior nettó nyereségéből, a beállítás által a senior saját idején túl okozott költségekből, valamint az alternatíva árából és tempójából. A lenti költségmodell egy helyre hozza őket. Ez a te számaidra használható módszer, nem előrejelzés.
Az alternatívák másképp buknak el. Egy csapat több embert jelent, de több ember ismeri a rendszert, és képes review-t végezni és kiadni, amit egyetlen senior nem nyújt. Egy ügynökség napidíjban adja el a kapacitást, és ez az ár a saját rezsijét és haszonkulcsát fedezi. Napjai csak akkor hasonlíthatók össze, ha az ajánlat ugyanazt a munkát tartalmazza: felmérés, tesztek, telepítés és átadás.
Egy költségmodell, amelyet kitölthetsz
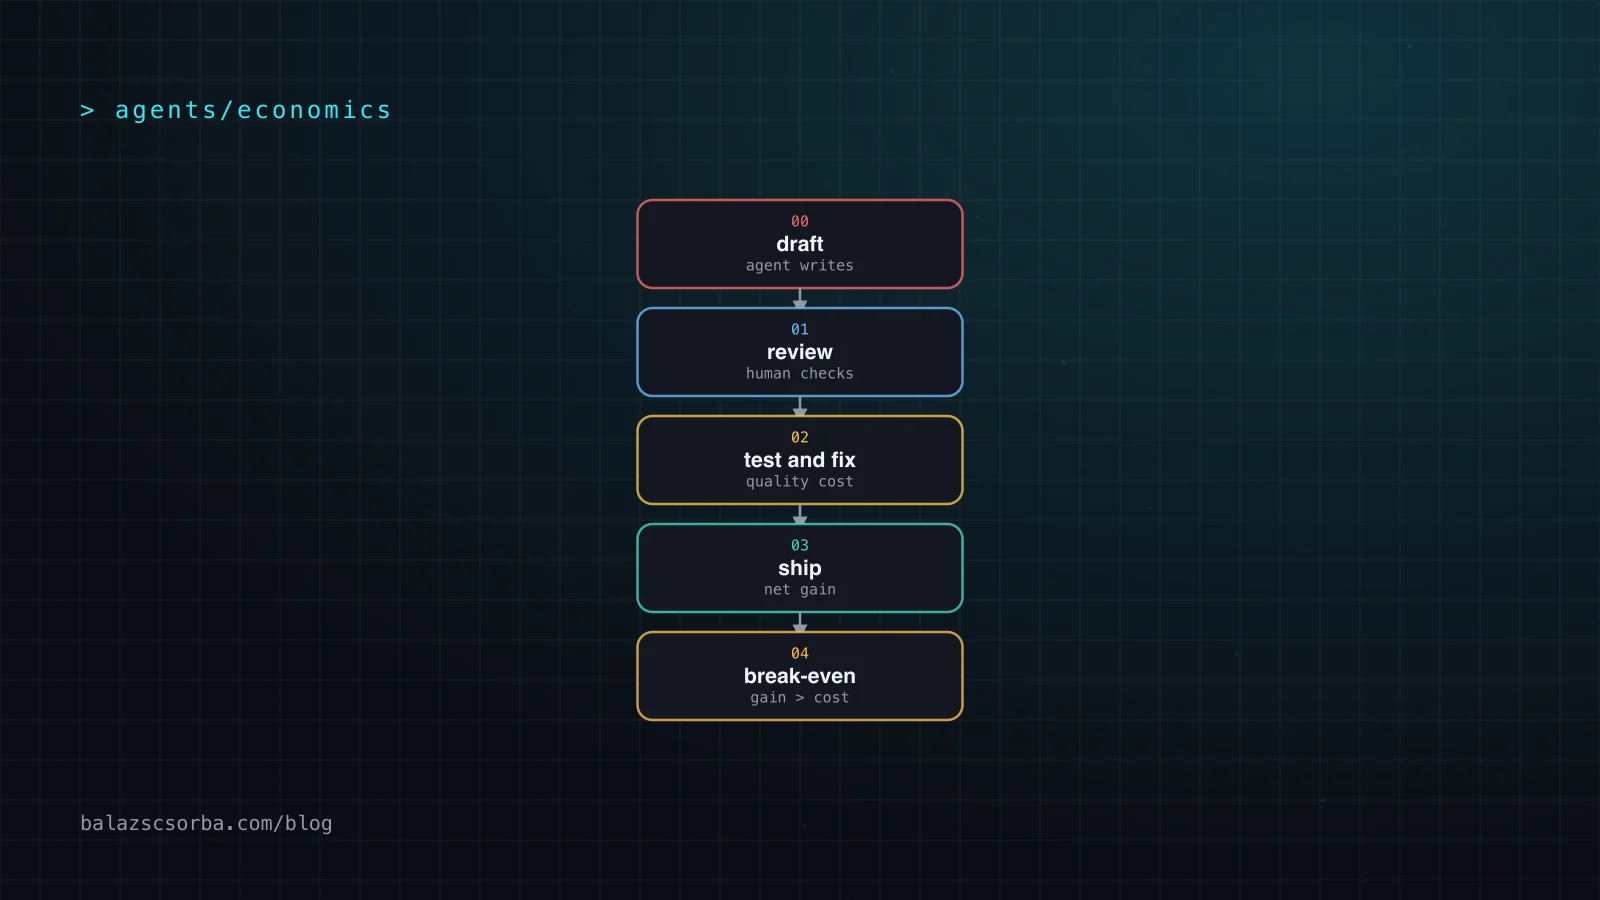
Minden lehetőségnél használj egy hatókört, egy időszakot és egy minőségi mércét. Az ábra megmutatja, hol kell a nyereségnek kiállnia, a táblázat pedig meghatározza a bemeneteket.
| Bemenet | Mit kell beírni | Honnan származik |
|---|---|---|
| L, teljes terhelt költség | A senior havi költsége: bér, munkáltatói költségek, eszközök, rezsi | Bérszámfejtés és pénzügy |
| T, eszközköltség | Felhasználói helyek, a csomagon túli használat, API-költés, az ügynökök hosztolása | A szállítók számlái |
| V, review-költség | Azok óraszáma, akik az ügynök kimenetét átnézik és javítják, szorozva az óradíjukkal | Pull request-ek időnaplói |
| Q, minőségi költség | Az incidensek, az újramunka és az ügyfél-jóváírások várható havi költsége | Incidens- és hibanapló |
| B, kiindulási alap | Hány nap meghatározott munkát szállítanak havonta MI nélkül | Három hónapos nyilvántartás |
| g, nettó nyereség | A mért nyereség a ticket-től az élesítésig, azonos minőségen, törtként: a 0,10 jelentése 10% | Pilot, nem felmérés |
| D és Sa, ügynökség | Az ügynökség napidíja és az a napszám, amelyet ugyanarra a hatókörre megad | Írásos ajánlat |
cost per scope day, no agents      = L / B
cost per scope day, with agents    = (L + T + V + Q) / (B × (1 + g))
break-even net gain                = (T + V + Q) / L
senior with agents, scope S days   = (L + T + V + Q) × S / (B × (1 + g))
agency, same scope                 = D × Sa
Ezt a számot vidd magaddal a megbeszélésre. Az eszköz-, review- és minőségi költség minden egyes százalékpontját, a teljes terhelt költséghez mérve, mért nettó nyereségként kell visszaszerezni. Ha ezek a költségek együtt a terhelt költség 10%-át teszik ki, akkor a 10% alatti nettó nyereség minden szállított napot drágábbá tesz, mint korábban. Csapat esetén add össze a terhelt költségeket, és a csapat mért kimenetét használd.
Az eszközsor a legkönnyebben becsülhető és a legkevésbé stabil. 2026 októberében a Claude Pro éves előfizetéssel havi 17 dollár, havi számlázással 20 dollár. A Claude Team standard felhasználói helye éves számlázással havi 20 dollár, a prémium hely éves számlázással havi 100 dollár, a Claude Max pedig havi 100 dollártól kezdődik. A GitHub Copilot Pro havi 10 dollár, a Pro+ 39 dollár, a Max 100 dollár. Használati korlátok vonatkoznak rá, és az Anthropic szerint az árak és a csomagok a saját belátása szerint változhatnak.
Hasonlítsd össze a lehetőségeket ugyanazon a hatókörön. Az ügynökség oldala az ügynökség napidíja szorozva az ajánlott napjainak számával, a senior oldala pedig a hatókör-képlet. A válasz kétféleképpen fordulhat: vagy nagy a mért nyereség és alacsony a review-költség, vagy az ügynökség sokkal több napot ajánl, mint amennyit a munka igényel. Mielőtt összehasonlítanád a számokat, kérj mindkét oldaltól ugyanazokat a szállítandókat.
Három kockázat, amelyet a táblázat nem mutat
Egyetlen hibapont
Egy senior busz-faktora egy, és az ügynökök ezt a függőséget elmélyítik, mert a tudás most a promptokban, a skillekben és a konfigurációban is ott van, nem csak egy fejben. Tartsd az ügynök-konfigurációt, a specifikációkat és a review-szabályokat a tárolóban. Nevezz meg egy második személyt, aki review-t tud végezni és kiadni, és előre egyezz meg abban, mi történik betegség vagy szabadság idején. A szállító a második egyetlen hibapont, ezért készíts tartalékot, például egy ügynökségi keretszerződést, és ne feltételezd, hogy a mai ár marad.
Minőségi adósság
A minőségi adósság később érkezik, és nem jelenik meg a kódolási időben. A DORA alacsonyabb stabilitással való összefüggése a figyelmeztetés: a kód gyorsabban érkezhet, mint ahogy a rendszer be tudja fogadni. A védelem a pipeline-ba tartozik, nem a promptba. Tedd az összevonást olyan ellenőrzések feltételévé, amelyeket az ügynök nem írhat át (a beállítást a jegyzetemben írom le: harness engineering kódoló ügynökökhöz), minden változtatáshoz kérj emberi jóváhagyást, és kövesd az újramunkát, például azokat a változtatásokat, amelyeket egy rögzített időablakon belül visszavontak vagy újranyitottak.
Adatvédelem
A GDPR 28. cikke akkor érvényes, ha egy szolgáltató a megbízásodból személyes adatokat dolgoz fel. Az adatfeldolgozónak írásos szerződés kell, amely rögzíti a feldolgozás tárgyát és időtartamát, jellegét és célját, valamint a személyes adatok típusát. Másik adatfeldolgozót csak a te előzetes írásos engedélyeddel vehet igénybe, akár konkrét, akár általános engedélyről van szó. Kösd az MI-szolgáltatót ehhez a szerződéshez, mielőtt személyes adat kerül egy promptba. Ide tartoznak a hibajegyekben szereplő nevek, az ügyféladatok a tesztadatokban és a személyes adatok a naplókban.
A szolgáltatói feltételek is számítanak. Az Anthropic kereskedelmi feltételei szerint nem taníthat modelleket a szolgáltatásaiból származó ügyféltartalmakon, a Team csomagnál pedig alapértelmezés szerint nincs modelltanítás a te tartalmaidon. Az EGT-ben, Svájcban vagy az Egyesült Királyságban lévő ügyfelek az Anthropic Ireland-del kötnek szerződést. Az Anthropic adatlokalizációs dokumentációja az USA-ra korlátozott következtetést (inference) a standard ár 1,1-szeresén írja le, egyébként a globális útválasztás a standard áron történik. Az általam olvasott oldalon nem találtam kizárólag EU-s lehetőséget, ezért kérd azt írásban. A GDPR és LLM API-k adatlokalizációja jegyzetem részletesebben foglalkozik az EU-s lehetőségekkel.
Mikor elég egy senior ügynökökkel
Ökölszabályom az alábbi lánc. Dolgozd végig sorrendben, és az első nemnél állj meg. Az első három kérdés dönti el, hogy a beállítás biztonságosan futtatható-e. Az utolsó dönti el, hogy olcsóbb-e.
Mit tennék először
- Írd le a kiindulási alapot. Három hónapon át rögzítsd, hány nap meghatározott munkát szállít az illető, és mennyi idő telik el a tickettől az élesítésig.
- Indíts egy kéthetes pilotot egy jól körülhatárolt projekten ügynökökkel, és a kiindulási alaphoz mérd a végponttól végpontig tartó nyereséget, ne a sebesség érzetét.
- Töltsd ki a költségmodellt valós számokkal, és hasonlítsd össze egy írásos ügynökségi ajánlattal ugyanarra a hatókörre.
- Írd alá az adatfeldolgozási szerződést, és erősítsd meg írásban a tanítást, a megőrzést és a feldolgozás helyét, mielőtt ügyféladat kerül bármilyen promptba.
- Nevezz meg egy második személyt, aki ellenőrzi és kiadja az ügynökök munkáját, és írd le, mi történik, ha a senior távol van.
- Negyedévente mérj újra. Az eszközök gyorsabban változnak, mint a tanulmányok, a METR folytatása pedig megmutatja, mennyire nehéz pontosan megmondani a számot.
Ehhez nincs szükség platformra. Szükség van kiindulási alapra, mért nyereségre és aláírt szerződésre, ebben a sorrendben.
Források
- METR: MI és tapasztalt nyílt forráskódú fejlesztők, 2025 eleje
- Becker et al.: arXiv 2507.09089
- METR: a fejlesztői produktivitási kísérlet felépítése, 2026 február
- Peng et al.: kontrollált kísérlet a GitHub Copilot-tal, arXiv 2302.06590
- Cui et al.: három terepkísérlet szoftverfejlesztőkkel
- DORA: State of AI-assisted Software Development 2025
- Google Cloud: a 2024-es DORA-jelentés főbb megállapításai
- Stack Overflow: Developer Survey 2025, MI
- Ziftci et al.: Migrating Code At Scale With LLMs At Google
- Alshahwan et al.: Automated Unit Test Improvement using Large Language Models at Meta
- GitClear: AI Copilot Code Quality: 2025 Look Back at 12 Months of Data
- GDPR, 2016/679/EU rendelet, 28. cikk
- Anthropic: Commercial Terms of Service
- Claude: árazás
- Claude Platform: adatlokalizáció
- GitHub Copilot: csomagok és árazás
Gyakori kérdések
Gyorsabbá teszik a tapasztalt fejlesztőket a kódoló ügynökök?
A bizonyítékok nem döntik el. A METR 2025-ös randomizált kísérlete szerint a tapasztalt nyílt forráskódú fejlesztők feladatai 19%-kal tovább tartottak azokon a feladatokon, ahol az MI engedélyezett volt, miközben úgy hitték, az MI 20%-kal gyorsabbá tette őket. A METR 2026 februári folytatása olyan becsléseket adott, amelyek konfidenciaintervallumai tartalmazzák a nullát, a szerzők pedig nagyon gyenge bizonyítéknak nevezték az adatokat. Mérd meg a saját csapatodat, mielőtt döntesz.
Mekkora a break-even produktivitásnövekedés egy MI-kódolási beállításnál?
Add össze a havi eszközköltséget, a többiek által az MI-kimenet átnézésére fordított időt és a minőségi problémák várható havi költségét. Ezt az összeget oszd el a fejlesztő teljes havi terhelt költségével. Az eredmény az a minimális nettó nyereség, végponttól végpontig mérve, amelynek a beállításnak el kell érnie ahhoz, hogy éppen megtérüljön.
Küldhetek ügyfélkódot vagy személyes adatot kódoló ügynöknek a GDPR szerint?
Csak olyan írásos szerződés alapján, amely megfelel a 28. cikknek, a szolgáltató adatfeldolgozóként. Írásban ellenőrizd, hogy a szolgáltató nem tanít a tartalmaidon, mit őriz meg, és hol történik a feldolgozás. Egyes üzleti csomagok, például a Claude Team, alapértelmezés szerint nem tartalmaznak modelltanítást, de a szerződésnek akkor is léteznie kell.
Olcsóbb egy senior ügynökökkel, mint egy ügynökség?
Lehet, de a válasz a mért nyereségtől, az ügynökség napidíjától és attól függ, hány napot igényel ugyanaz a munka. Ugyanarra a hatókörre és minőségi mércére tedd fel mindkét lehetőséget, és az egy szállított napra eső költségeket hasonlítsd össze. Olyan nyilvános tanulmányt, amely a kettőt közvetlenül összehasonlítaná, nem találtam.