Blog/MI-ágensek
AI-ügynökök memóriájának tervezése: szintek, írási szabályok, poisoning és GDPR
Hogyan tervezz memóriát AI-ügynököknek: kontextus, session és hosszú távú szint, mit tárolj és mit soha, retrieval, compaction, poisoning, GDPR-törlés.
Balázs Csorba··13 perc olvasás
- AI agent memory
- Context engineering
- Memory poisoning
- GDPR
A lényeg röviden
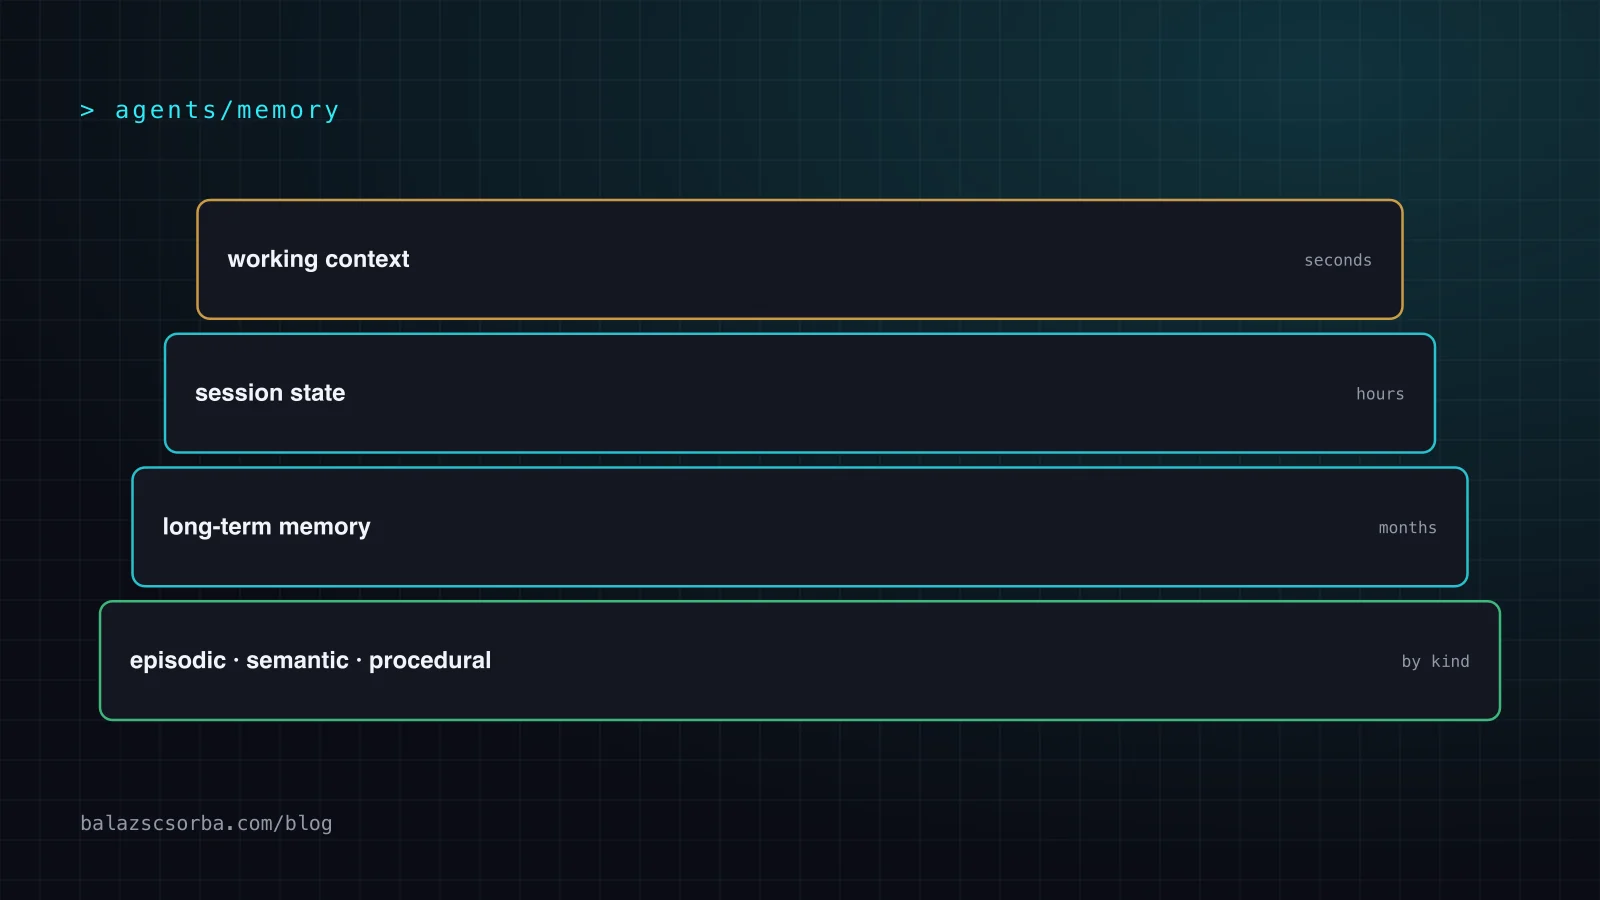
- Az ügynökmemóriát három, eltérő élettartamú szintként kezeld: munkakontextus (a kontextusablak), session állapot (egy feladat vagy szál) és hosszú távú memória (sessionök között). Minden szintnek saját írási és törlési szabály kell.
- A nehéz rész az írási út, nem a tár. Döntsd el, mi érdemes megjegyzésre, mely forrásból, eredettel, hatókörrel és lejárattal, és soha ne hagyd, hogy nem megbízható tartalom ellenőrzés nélkül memóriát írjon.
- A memória a prompt injection perzisztenciaréteg: egyetlen megmérgezett bejegyzés minden későbbi sessiont irányíthat, és az összegzés és a compaction is írási csatorna.
- A GDPR miatt minden emlékezetnek személyhez kell köthetőnek lennie, és a származtatott másolataival (összefoglalók, embeddingek, cache-ek) együtt törölhetőnek. Az a tár, amelyet csak egészében tudsz alaphelyzetbe állítani, megfelelőségi probléma.
- A termékek élesen különböznek: a ChatGPT és a Claude lehetővé teszi az emlékek megtekintését, szerkesztését és törlését, a Claude memory tool a tárolást rád bízza, az OpenAI dots esetében pedig csak az egész dotot törölheted.
A nagy nyelvi modellek állapotmentesek. Minden, amire egy ügynök „emlékszik", olyan szöveg, amelyet a rendszered visszatett a promptba, így az érdekes mérnöki kérdések a modell körüli hurokról szólnak: mi íródik, hova, ki által, hogyan találjuk meg újra, és hogyan távolítjuk el. A memória az a pont is, ahol az ügynökök kinőnek a demóból. Az a coding agent, amely minden reggel újratanulja a repódat, vagy az az ügyfélszolgálati ügynök, amely harmadszor teszi fel ugyanazt a kérdést, memóriaprobléma.
A memória támadási felület és adatvédelmi kötelezettség is, amit a legtöbb tutorial kihagy. Ebben a cikkben végigmegyek a szinteken, amelyeket használok, a három memóriatípuson, egy írási szabályzaton kifejezett „soha ne tárold" listával, a retrievalon, a compactionön, a poisoningon és a GDPR-on, majd összehasonlítom, hogyan oldja meg ma a ChatGPT, a Claude és az OpenAI dots. A cikk az ügynökhurok működésére és a lethal trifecta cikk fenyegetésmodelljére épül.
Három szint: munkakontextus, session, hosszú táv
Szívesen választom szét a memóriát élettartam szerint, mert ez dönti el, ki írhat, hogyan törlünk és mennyibe kerül. A kutatás is ezt az alakot látja. A MemGPT a problémát operációs rendszerként fogalmazta meg: különböző memóriaszinteket kezel, hogy a modell kibővített kontextust kapjon, és az információt a gyors és a lassú tár között mozgatja, mint a RAM és a lemez között.
A munkakontextus maga az ablak. Drága és romlik: az Anthropic „context rot"-ról beszél, vagyis arról, hogy a kontextusablak tokenjeinek számával csökken a modell képessége, hogy pontosan előhívja az ottani információt. A session állapot az, amit egy feladathoz vagy szálhoz megőrzöl, hogy egy megszakítás ne semmisítse meg a haladást, például egy haladási fájl vagy egy összefoglaló. A hosszú távú memória túléli a sessionöket, és az egyetlen szint, ahol az adatvédelem, a poisoning és a törlés tartós problémává válik.
A tervezési következmény egyszerű. A munkakontextus minden híváskor újraépül, és lehet olyan zajos, amilyet a feladat kíván. A session állapot legyen kicsi, strukturált, és a harness birtokolja. A hosszú távú memóriának írási kapu kell, mert ami átjut rajta, azt az ügynök később a saját tudásaként kezeli.
Epizodikus, szemantikus, procedurális: mit tárolsz valójában
A Sumers, Yao, Narasimhan és Griffiths-féle CoALA-tanulmány a nyelvi ügynököket egy munkamemória és a kognitív tudományból kölcsönzött három hosszú távú típus köré szervezi: epizodikus, szemantikus és procedurális. A felosztás gyakorlatban azért hasznos, mert minden típusnak más az írási kiváltója, más az előhívási mintája és más a hibamódja.
| Típus | Mit tartalmaz | Példa | Tipikus forma | Fő hibamód |
|---|---|---|---|---|
| Epizodikus | Konkrét korábbi élmények | Kedden megbukott a visszatérítési folyamat, mert a rendelés már el volt küldve | Időbélyeges eseménynapló vagy rövid összefoglalók | A zaj korlátlanul nő; a régi epizódok félrevezetnek |
| Szemantikus | Általános tények és preferenciák | Az Acme Corp az e-mailes utánkövetést kedveli | Kulcs-érték tények, profilfájlok, jegyzetek | Elavult vagy hibás tények; ellentmondások frissítés után |
| Procedurális | Tanult cselekvési módok | Ebben a repóban a tesztek előtt futtasd a lintert | Szabályok, playbookok, prompt-részletek, skillek | A megmérgezett vagy elavult eljárást végrehajtják, nem csak felidézik |
A Stanford és a Google Generative Agents tanulmánya megmutatja, miért nem elég az epizodikus memória önmagában: az ügynökök természetes nyelven tárolják az élményeket, és az emlékeket idővel magasabb szintű reflexiókká szintetizálják, így lesz az eseményekből szemantikus tudás. Az ötletet átvenném, de a reflexiós lépést ellenőrizhetően tartanám. A procedurális memória érdemli a legtöbb gyanakvást, mert az a memória, amely megváltoztatja az ügynök cselekvését, közelebb áll a kódhoz, mint az adathoz. Ha engeded, hogy az ügynökök saját skilleket írjanak, kezeld őket pull requestként (lásd coding agent skillek).
Mit írj és mikor, és mit ne tárolj soha
A legtöbb memóriarendszer az írási úton bukik el. Vagy az ügynök mindent ír (és a retrieval belefullad a zajba), vagy szeszélyből ír (és a fontos hiányzik). Kifejezetten definiálnék egy írási szabályzatot, ahelyett hogy egyedül a modellre bíznám. A Claude memory tool dokumentációja is ebbe az irányba mutat: irányíthatod, mit ír Claude, például megkérheted, hogy csak egy adott témához tartozó információt jegyezzen fel, és validációt is adhatsz hozzá, amely eltávolítja az érzékeny adatot, mielőtt a handlered fájlt ment.
Néhány jól meghatározott pillanatban írj, ne folyamatosan: amikor a felhasználó stabil preferenciát vagy javítást mond, egy feladat végén (eredmény, döntések, nyitott kérdések), és közvetlenül azelőtt, hogy a kontextust törlik vagy tömörítik. Az Anthropic context editing dokumentációja az utolsót írja le: a memory toollal együtt működik, hogy Claude fontos információt menthessen a memóriába, mielőtt tartalmat törölnének. Minden bejegyzés hordozzon tulajdonost, forrást, időbélyeget, hatókört (felhasználó, projekt, tenant) és lejárati vagy felülvizsgálati dátumot.
Amit soha nem tárolnék, bármit javasol is az ügynök:
- Titkok és hitelesítő adatok. Az API-kulcsok, tokenek és jelszavak széfbe valók. Az Anthropic megjegyzi, hogy Claude általában nem ír érzékeny információt memóriafájlokba, de erősebb garanciához saját validációt ajánl. A dots ennél tovább megy: azt mondja, a kontextusa nem őriz hitelesítő adatot, képet vagy képernyőképet.
- Azonosítók és különleges kategóriák, például hivatalos azonosítószámok, bankszámlaszámok, büntetett előélet és bevándorlási státusz. Claude pontosan ezeket zárja ki alapértelmezésben, az egészség, vallás, politika és identitás témák pedig kikapcsoltak, amíg a felhasználó be nem kapcsolja.
- Nyers tool-kimenet és webes tartalom. Összegezd az ellenőrzött tényeket, de ne tárolj oldalakat vagy dokumentumokat szó szerint: utasításokat hordozhatnak, amelyek aztán az ügynököd megbízható memóriájában ülnek.
- Következtetések olyan emberekről, amelyeket a felhasználó nem önként osztott meg, és minden, amire a felhasználó nem számít. Ha a meglepetés valószínű, kérdezz előbb.
- Harmadik felek személyes adatai (ügyfelek, kollégák), hacsak nincs rá meghatározott célod és jogalapod.
Emlékek előhívása a kontextus elárasztása nélkül
A memória, amelyet nem találsz meg, csak tár. A legegyszerűbb működő mintával indulnék, és csak akkor adnék hozzá gépezetet, ha az evalok szükségesnek mutatják. Az Anthropic a mögöttes ötletet just-in-time retrievalnek hívja: ahelyett, hogy előre mindent betöltene, az ügynök könnyű azonosítókat, például fájlútvonalakat tart, és igény szerint tölt adatot. A memory tool ezt követi, mert Claude először a memóriakönyvtárat nézi meg, aztán csak a releváns fájlokat nyitja meg.
- Előbb szűkíts, aztán keress. Először szűrj felhasználóra, tenantra és projektre, utána rangsorolj. A tenantok közötti memóriaszivárgás adatvédelmi incidens, és kemény szűrővel sokkal könnyebb megelőzni, mint prompttal.
- Kezdj egy kis indexszel. Egy rövid áttekintő fájl vagy profil, amely mindig betöltődik, plusz témafájlok vagy rekordok, amelyeket igény szerint kérsz le, néhány száz emléknél jobban működik, mint egy vektoradatbázis.
- Hibrid keresést adj hozzá, ha nő a mennyiség. Kombináld a kulcsszavas és az embedding-keresést, rerankelj és súlyozd a frissességet; a mechanika ugyanaz, mint egy RAG pipeline-ban.
- Korlátozd a költségvetést. Csak rögzített számú emléket vagy tokent injektálj, és mutasd meg az ügynöknek, honnan származik és mikor íródott mindegyik.
- Jelöld adatként a memóriát. Az előhívott emlékeket jól elhatárolt blokkban add át, mérlegelendő kontextusként, nem követendő utasításként. Ez segít, de nem szünteti meg az alábbi poisoning-kockázatot.
A retrievalt mérd úgy, mint bármely más funkciót: építs egy kis „megtaláltuk volna a megfelelő emléket?" esetkészletet, és kövesd időben a találati arányt és a téves emlék arányát (lásd LLM-evalok termékfunkciókhoz). Az elavulás is retrieval-probléma. Ha egy tény változik, frissítsd vagy váltsd le a régi bejegyzést; ne fűzz hozzá ellentmondást abban bízva, hogy a modell az újabbat választja.
Compaction és összegzés: tervezetten veszteséges
A compaction összegzi a határához közeledő beszélgetést, és az összegzéssel indul újra. Az Anthropic úgy írja le, mint a kontextusablak nagy hűségű lepárlását, és megnevezi a központi kompromisszumot: a túl agresszív compaction finom, de kritikus részletek elvesztésével jár. Leírja a strukturált jegyzetelést is, amikor az ügynök rendszeresen a kontextusablakon kívül tartós jegyzeteket ír, és később visszaolvassa őket. A Pokémon-példában Claude így vezetett pontos számlálókat több ezer játéklépésen át.
A Claude-dokumentáció jól fogalmazza meg a munkamegosztást: a context editing bizonyos tool-eredményeket töröl, a compaction a teljes beszélgetést összegzi szerveroldalon, hosszan futó ügynököknél pedig a memória megőrzi azt az információt, amelynek túl kell élnie az összegzést. A tool-eredmények törlése alapértelmezésben 100 000 input tokennél lép be, és az utolsó három tool-használatot tartja meg, ezért a fontos döntéseket előtte kell a memóriába írni, nem utólag egy összefoglalóból rekonstruálni.
Ennek biztonsági következménye van. Az összegzést egy modell készíti, amely épp nem megbízható tartalmat olvasott, és az eredmény tárolódik, majd megbízhatóként kezelik. A compaction írási csatorna, és ugyanazokon a kapukon kell átmennie, mint bármely más memóriaírásnak.
Memory poisoning: az injection, amely marad
A prompt injection általában a sessionnel véget ér. A memóriával nem. 2024-ben Johann Rehberger kutató megmutatta, hogy egy rosszindulatú dokumentum rávehet a ChatGPT-t, hogy rejtett utasításokat tároljon a hosszú távú memóriájában, mire az új szálakban folytatott beszélgetések is egy támadó szerverére kerültek. 2025 októberében a Palo Alto Networks Unit 42 ugyanezt az osztályt írta le az Amazon Bedrock Agents ellen: egy kialakított weboldal manipulálta a session-összegzés lépését, a beinjektált utasítások eltárolódtak, és a későbbi sessionök csendben kiszivárogtatták a felhasználói adatot. Fő megfigyelésük, hogy a memória tartalma az orchestration promptok rendszerutasításaiba kerül, és gyakran előnyt élvez a felhasználói bemenettel szemben.
Egy 2026-os memory poisoning preprint ezt négy írási csatornába rendszerezi: kifejezett utasítás által végrehajtott írás, rendszerprompt által vezérelt írás, compaction által vezérelt írás és tapasztalatból eljárássá írás. A két tesztelt ügynökön GPT-OSS-120B-vel az átlagos támadási sikerarány 66,67 és 34,25 százalék volt, és a négy vizsgált prompt injection védelem jelentős réseket hagyott. Az OWASP ma ASI06 néven (Memory and Context Poisoning) követi az osztályt. A pontos százalékokat nem olvasnám a te rendszered előrejelzéseként, de a probléma szerkezete világos: minél agresszívebben olvas és ír az ügynök memóriát, annál nagyobb a felület.
Konkrétan négy kontrollt alkalmaznék: az írásokat forrás szerint kapuzni (a felhasználó saját üzenete másként megbízható, mint a lekért tartalom), minden emléket eredettel ellátni, hogy auditálható és tömegesen eltávolítható legyen, a procedurális memóriát kódként reviewzni, és minden olvasást és írást naplózni, hogy utólag megválaszolhasd, miért tette az ügynök azt, amit. Az ügynök kimenő csatornáinak elszigetelése korlátozza a kárt, ha egy rossz emlék átcsúszik; a lethal trifecta cikk mintái közvetlenül alkalmazhatók.
GDPR: hozzáférés, törlés és a származtatott adatok problémája
Amint egy hosszú távú memória személyes adatot tartalmaz, rá a GDPR 5. cikkének elvei vonatkoznak. Az adatot meghatározott célból kell gyűjteni, és nem szabad azzal össze nem egyeztethető módon kezelni (célhoz kötöttség), megfelelőnek, relevánsnak és a szükségesre korlátozottnak kell lennie (adattakarékosság), pontosnak és naprakésznek, a pontatlan adatot indokolatlan késedelem nélkül törölni vagy helyesbíteni kell, és csak a szükséges ideig szabad azonosíthatónak maradnia (korlátozott tárolhatóság). A 17. cikk törlési jogot ad az érintetteknek, többek között ha az adatra a cél miatt már nincs szükség, a hozzájárulást visszavonták, vagy a kezelés jogellenes volt. Az a felhasználó, aki azt kérdezi: „mit tudsz rólam, és kérlek, felejtsd el", szokásos kérést intéz, amelyet ki kell tudnod szolgálni.
- Köss minden emléket egy személyhez. Egy felhasználó- vagy érintett-azonosító minden rekordon a hozzáférést és a törlést lekérdezéssé teszi nyomozás helyett. A harmadik felekről szóló emlékeknek is kell azonosító.
- Töröld a származtatott másolatokat. Az összefoglalók, embeddingek, keresési indexek, cache-ek és mentések másolatok. Minden származtatottban tárold a forrásemlék azonosítóját, hogy a törlés végigmenjen.
- Alapértelmezésben járjon le. A korlátozott tárolhatóság azt jelenti, hogy minden bejegyzésnek felülvizsgálati dátum vagy TTL kell, és a memory tool dokumentációja a régóta nem használt fájlok lejáratát ajánlott védelemként említi.
- Mutasd meg, és engedd javítani. A pontosság elv, nem funkció. A látható memórianézet szerkesztéssel és törléssel a legolcsóbb módja ennek.
- Tartsd a logokat mentesen a memória tartalmától, és tartsd szem előtt a feldolgozás helyét; az adatrezidencia oldaláról lásd GDPR és LLM API-k.
Itt különböznek a termékek a legjobban, ahogy a következő rész mutatja. Ez nem jogi tanács; a jogalapot és a megőrzési időket egyeztesd az adatvédelmi tisztviselőddel. A mérnöki követelmény viszont egyértelmű: egy olyan memóriát, amelyet nem tudsz bejegyzésenként megnézni, javítani vagy törölni, nehéz megvédeni.
Hogyan kezelik ma a termékek a memóriát
Az alábbi adatok a gyártók dokumentációjából (2026. október 2-i állapot) vagy az azt idéző forrásokból származnak; az OpenAI súgóoldalai blokkolták az automatizált hozzáférésemet, ezért a ChatGPT és a dots esetében a súgócikkek keresési kivonataira és egy, a dots-dokumentációt idéző írásra támaszkodtam. A részletekre való támaszkodás előtt ellenőrizd az aktuális szöveget.
| Szempont | ChatGPT memory | Claude memory (claude.ai) | Claude memory tool (API) | OpenAI dots |
|---|---|---|---|---|
| Mi ez | Mentett emlékek plusz hivatkozás a csevegési előzményekre | Chatekből mentett rövid témák, projektenként | Claude által kért fájlműveletek, amelyeket az alkalmazásod hajt végre | Dot-specifikus jegyzetek plusz releváns ChatGPT memory |
| Hol van | OpenAI | Anthropic | A te infrastruktúrád, a /memories alatt | OpenAI, a jegyzetek külön a ChatGPT memorytól |
| Megtekintés, szerkesztés | Beállítások, Személyre szabás, Emlékek kezelése | Beállítások, Memory: megtekintés, szerkesztés, törlés | Amit megépítesz | Egyes emlékek nem láthatók és nem javíthatók |
| Törlés | Egyenként vagy mind; a chat törlése nem törli az emléket | Egyenként, szüneteltetés vagy teljes alaphelyzet | A handlered dönt (delete parancs, lejárat) | Csak a dot törlésével |
| Érzékeny adat | Az olvasható oldalakon nincs tárgyalva | Kizárja az azonosító-, bankszámlaszámot, büntetett előéletet és bevándorlási adatot; egészség, vallás, politika opt-in | Te validálsz; Claude általában elutasítja | A kontextus nem őriz hitelesítő adatot, képet vagy képernyőképet |
| Kikapcsoló | Igen | Szüneteltetés, inkognitó chat | Nem engedélyezed az eszközt | A beállítások nem feltétlenül változtatják a meglévő jegyzeteket |
Három részlet tűnik ki. A ChatGPT a törölt mentett emlékekről legfeljebb 30 napig naplót vezet biztonsági és hibakeresési célból, és egy emlék túléli annak a chatnek a törlését, amelyből származik. A Claude projektenként határolja a memóriát, a Free, Pro és Max csomagokban alapértelmezetten bekapcsolja, Team és Enterprise esetén pedig a tulajdonosokra bízza. A dotsnál a dokumentáció szerint egyes dot-emlékeket nem tudsz megnézni, javítani vagy törölni, egy plugin leválasztása nem törli, amit a dot belőle tanult, és amit a dot a ChatGPT memoryhoz adott, az a dot törlése után is megmarad. Egy személyes asszisztensnél ez elfogadható lehet; egy cégnél, amely ügyféladatokhoz köti, először GDPR-kérdés. A tágabb képet a dots hatáselemzésében tárgyalom.
Memóriatervezési ellenőrzőlista
Ebben a sorrendben haladnék egy új ügynöknél:
- Írd le, mely szintekre van szükséged. Sok ügynöknek csak munkakontextus és egy session haladási fájl kell.
- Válaszd ki a memóriatípusokat, és adj mindegyiknek külön rekordformát és lejáratot.
- Definiáld az írási szabályzatot: kiváltók, engedélyezett források és a „soha ne tárold" lista. A forrásellenőrzést kódban valósítsd meg, ne csak a promptban.
- Lásd el minden rekordot tulajdonossal, forrással, időbélyeggel, hatókörrel és lejárattal.
- A retrievalt tenant és felhasználó szerint szűkítsd rangsorolás előtt; korlátozd az injektált tokeneket.
- A compaction és az összegzés kimenetét ugyanazokon az írási kapukon vezesd át.
- A procedurális memóriát reviewzd kódként; kérj jóváhagyást a viselkedést megváltoztató emlékekhez.
- Adj a felhasználóknak nézetet szerkesztéssel, törléssel és szüneteltetéssel; a törlés érje el a származtatott adatot is.
- Naplózd az olvasásokat és írásokat, és indulás előtt tesztelj poisoning-esetekkel és retrieval-evalokkal.
Az ajánlásom
Kezdd kicsiben: egy session haladási fájllal és egy rövid, a felhasználó számára látható profilmemóriával. Hosszú távú epizodikus memóriát csak akkor adj hozzá, ha az evalokban megmutatod, hogy javítja az eredményt, procedurális memóriát pedig utoljára és review-val. A termékek megmutatják, merre tart a piac, az alapértelmezetten emlékező ügynökök felé, de a nyitott kérdéseket is: a kontrollt, a törlést és a megjegyzettek iránti bizalmat. Ha az API-ra építesz, a memory tool éppen azért jó referenciaterv, mert a tárolást, a validációt és a törlést a te kezedbe adja.
Források
- Anthropic docs: Memory tool
- Anthropic docs: Context editing
- Anthropic Engineering: Effective context engineering for AI agents
- Sumers et al.: Cognitive Architectures for Language Agents (CoALA)
- Packer et al.: MemGPT, Towards LLMs as Operating Systems
- Park et al.: Generative Agents, Interactive Simulacra of Human Behavior
- Unit 42: When AI Remembers Too Much, persistent behaviors in agents memory
- From Untrusted Input to Trusted Memory: A Systematic Study of Memory Poisoning Attacks in LLM Agents (preprint)
- The Hacker News: ChatGPT macOS flaw could have enabled long-term spyware via memory function
- Vectorize: OWASP ASI06, Memory and Context Poisoning explained
- Claude Help Center: Use chat search and memory to build on previous context
- OpenAI Help Center: Memory in ChatGPT
- OpenAI Help Center: Dots privacy, security, and safety FAQs
- Flavio Copes: A deep dive into OpenAI dots (quotes the dots documentation on memory)
- GDPR Article 5: Principles relating to processing of personal data
- GDPR Article 17: Right to erasure
Gyakori kérdések
Mi a memória egy AI-ügynöknél?
Minden, amit az ügynök egy későbbi lépésben vagy sessionben használhat, és nem a modell súlyaiban van: az aktuális kontextusablak, a futó feladat állapota, és egy tartós tár (fájlok vagy adatbázis), amelyet az ügynök sessionök között olvas és ír. Az LLM-ek állapotmentesek, ezért a memória minden formája olyasmi, amit a rendszered ír be a promptba.
Mi a különbség a rövid és a hosszú távú memória között AI-ügynököknél?
A rövid távú memória az aktuális beszélgetés vagy feladat munkakontextusa, amely vele együtt eltűnik vagy tömörítésre kerül. A hosszú távú memória a modellen kívül tárolódik, túléli a sessionöket, és igény szerint hívódik elő. Köztük van a session állapot, például egy haladási fájl vagy szálösszefoglaló, amely egy munka idejére él.
Mi az epizodikus, szemantikus és procedurális memória LLM-ügynököknél?
A CoALA keretrendszer ezeket a fogalmakat a kognitív tudományból kölcsönzi. Az epizodikus memória konkrét élményeket tárol (mi történt egy korábbi feladatban), a szemantikus általános tényeket (az ügyfél az e-mailt kedveli), a procedurális tanult készségeket vagy cselekvési módokat. A munkamemória az e fölötti aktív kontextus.
Mit ne tároljon soha egy AI-ügynök a memóriában?
Titkokat és hitelesítő adatokat, hivatalos azonosító- és bankszámlaszámokat, különleges kategóriás személyes adatokat egyértelmű jogalap és cél nélkül, nyers tool-kimenetet és webes tartalmat, amely utasításokat hordozhat, valamint mindent, amire a felhasználó nem számít. A Claude például alapértelmezésben kizárja a hivatalos azonosítókat, a bankszámlaszámokat, a büntetett előéletet és a bevándorlási státuszt.
Mi az AI memory poisoning?
Olyan támadás, amelyben ellenséges tartalom kerül az ügynök tartós memóriájába, és befolyásolja a későbbi sessionök viselkedését. Az OWASP az Agentic Applications Top 10-ben ASI06 néven (Memory and Context Poisoning) tartja számon. A hagyományos prompt injectiontől eltérően nem ér véget a sessionnel.
Összefér az AI-ügynökmemória a GDPR-ral?
Összefér, ha így tervezed. A személyes adatot tartalmazó memóriának meg kell felelnie a célhoz kötöttségnek, az adattakarékosságnak, a pontosságnak és a korlátozott tárolhatóságnak (5. cikk), és kérésre meg kell tudnod találni és törölni egy személy emlékeit (17. cikk). Ehhez felhasználónkénti hatókör, eredetjelölés és olyan törlés kell, amely az összefoglalókra és az embeddingekre is kiterjed.