Blog/MI-ágensek
Multi-agent rendszerek: mikor verik az egyetlen ügynököt, és mikor nem
Orchestrator-worker, fan-out, critic, handoff: mit ad valójában a multi-agent rendszer, mennyi tokenbe kerül, hogyan hibázik, és egy döntési táblázat.
Balázs Csorba··12 perc olvasás
- Multi-agent systems
- AI agents
- Orchestrator-worker
- Context engineering
A lényeg röviden
- Az Anthropic mérése szerint egy ügynök nagyjából négyszer, egy multi-agent rendszer nagyjából tizenötször annyi tokent használ, mint egy chat, ezért a multi-agent felépítésnek meg kell érnie ezt a szorzót.
- Az igazi haszon a kontextus elszigetelése: a worker a saját ablakában kutat, és összefoglalót ad vissza, így a vezető ügynök fókuszban marad, a lefedett terület pedig meghaladhat egy kontextusablakot.
- A párhuzamos olvasás jól skálázódik, a párhuzamos írás és a szorosan összefüggő lépések nem. A Google Research +81%-ot mért egy párhuzamosítható, és 39–70% romlást egy szekvenciális feladaton.
- A hibák többsége koordinációs hiba (homályos specifikáció, elveszett kontextus, hiányzó ellenőrzés), nem modellhiba, és a vita-alapú megoldások gyakran az egyszerű együgynökös alapvonalat sem verik meg.
- Kezdj egy ügynökkel és jó harnesszel, subagentet csak mért okból adj hozzá, tartsd single-threaded az írást, és a multi-agent változatot mérd az együgynökös ellen.
Pár havonta egy új keretrendszer triviálissá teszi egy ügynökcsapat felállítását: tervező, kutató, kódoló, reviewer. A diagramok szervezeti ábrának látszanak, és könnyű azt hinni, hogy több ügynök több intelligenciát jelent. A publikált bizonyítékok óvatosabbat mondanak: a multi-agent rendszerek egy szűk problémaosztályban kiválóak, mindenhol drágák, és meglepően sok feladaton csendben rosszabbak az egyetlen ügynöknél.
Ez a bejegyzés rendbe teszi a mintákat, számot ad a költségre, felsorolja a kutatás és a gyártók által dokumentált hibamódokat, és egy döntési keretrendszerrel zár, amelyet a saját esetedre alkalmazhatsz. Az álláspontom előre: kezdj egy ügynökkel, és minden további ügynököt kezelj úgy, mint egy beszerzést, amelyet indokolnod kell. A legerősebb indok nem a „specializáció” vagy a „csapatmunka”, hanem a kontextus elszigetelése.
Ha előbb az egyetlen ügynök alapjait szeretnéd, olvasd el az agent loop magyarázatát. Minden alább azt feltételezi, hogy már van egy működő ügynököd.
Négy minta, és mire jó mindegyik
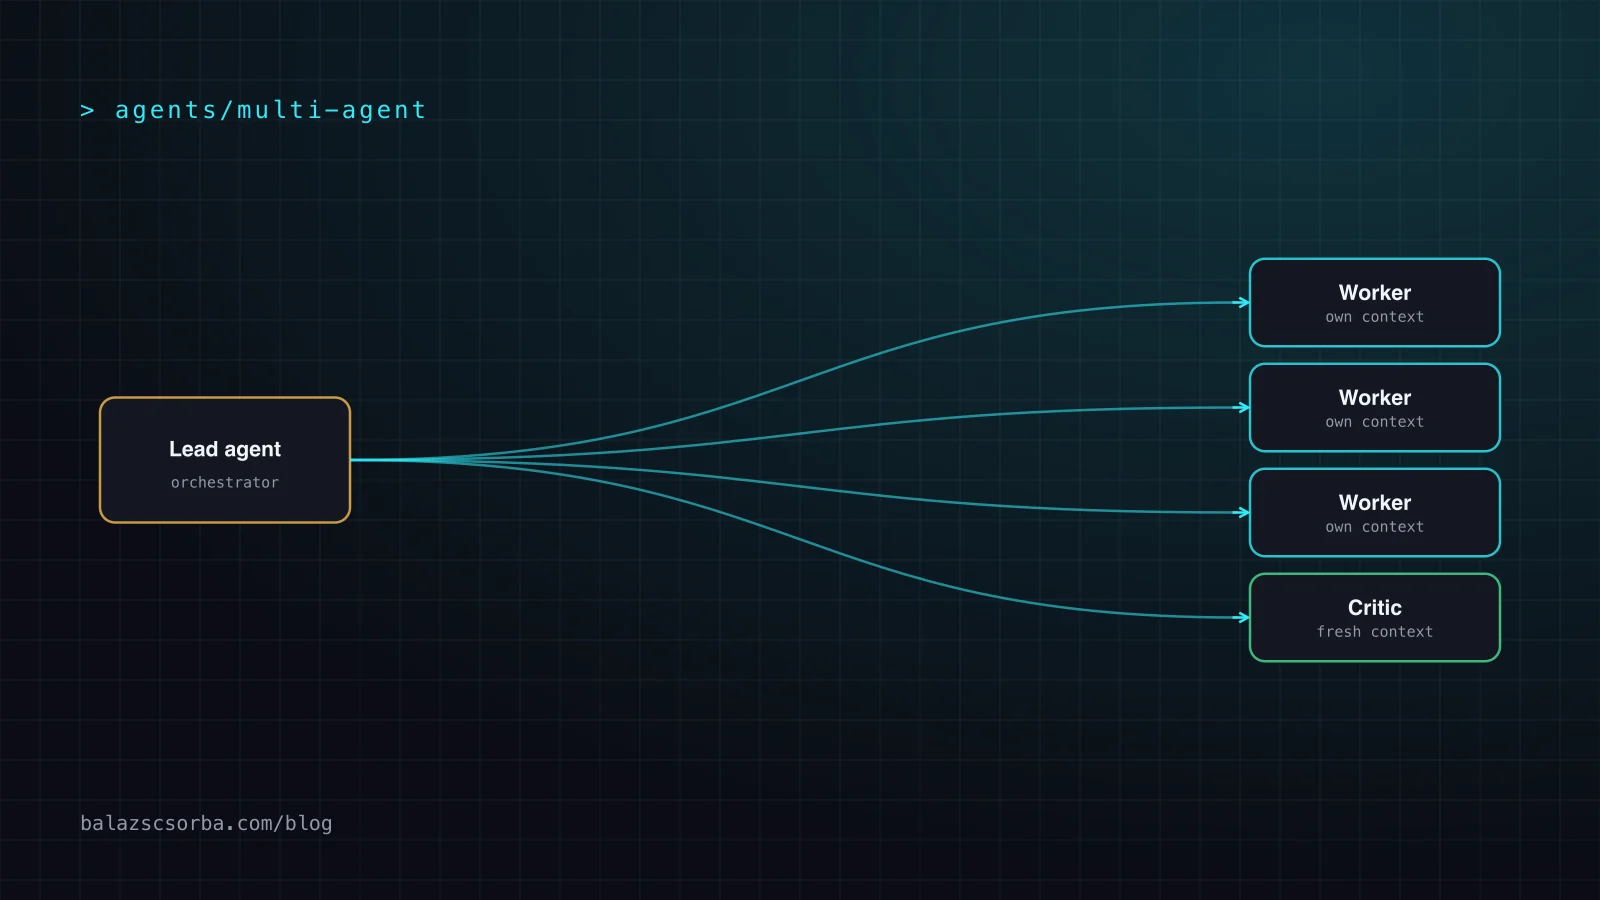
A legtöbb multi-agent felépítés négy alapforma kombinációja. Abban különböznek, hogy ki tartja kézben az irányítást, ki melyik kontextust látja, és hol egyesülnek az eredmények.
Részletesebben:
- Orchestrator-worker. Egy vezető ügynök tervez, workereknek delegál, és szintetizál. Az Anthropic Building effective agents bejegyzése egy központi LLM-ként írja le, amely „dinamikusan bontja a feladatokat, worker LLM-eknek delegálja, és szintetizálja az eredményeiket”. Olyan feladatokra való, ahol a részfeladatokat előre nem tudod megjósolni.
- Párhuzamos fan-out. Ugyanez rögzített formában: a munkát független részekre bontod, egyszerre futtatod, majd egyesíted. Ugyanez a bejegyzés két változatot nevez meg: sectioning (független részfeladatok) és voting (ugyanazt a feladatot többször futtatod, változatos kimenetekért).
- Író és critic (debate). Egy második ügynök ellenőrzi az első kimenetét, vagy több ügynök vitatkozik egy válaszig. Itt vegyesebb a bizonyíték, ahogy a hibákról szóló rész mutatja.
- Handoff. Egy ügynök átadja a beszélgetést egy szakértőnek. Az OpenAI Agents SDK-ban a handoff a modell számára egy transfer_to_refund_agent nevű eszközként jelenik meg, és alapértelmezés szerint „az új ügynök átveszi a beszélgetést, és látja a teljes korábbi előzményt”. Egy input filterrel ezt szűkítheted.
A kontextus elszigetelése az igazi haszon
Kérdezd meg, mit tud a második ügynök, amit az első nem. Nincs jobb modellje, és nem gondolkodik keményebben. Neki üres kontextusablaka van. Egy worker elolvashat negyven keresési találatot, átkereshet egy monorepót, vagy lefuttathat egy zajos tesztcsomagot, és tíz sort ad vissza. A vezető ügynök sosem cipeli ezt a zajt.
Az Anthropic saját kutatórendszer-leírása ezt kimondja: a subagentek párhuzamosan, saját kontextusablakkal dolgoznak, így kezeli a rendszer az egyetlen kontextusablakot meghaladó információt. A Claude Code dokumentációja ugyanezt mondja a kódolásról: akkor használj subagentet, ha egy mellékfeladat a fő beszélgetést „keresési találatokkal, logokkal vagy fájltartalmakkal árasztaná el, amelyekre többé nem hivatkozol”, mert a munkát a saját kontextusában végzi, és „csak az összefoglalót adja vissza”.
A másik oldal ugyanilyen fontos. A friss subagent nem örökli a beszélgetési előzményt, a skilleket és a már elolvasott fájlokat, ezért mindennek, amire szüksége van, a feladatleírásában kell lennie. A dokumentáció felsorolja, mikor maradj a fő beszélgetésben: gyakori oda-vissza, több, sok közös kontextust osztó fázis, például tervezés, implementáció és tesztelés, valamint késleltetésre érzékeny munka. Ez ugyanaz a felismerés, mint a kódoló ügynökök harness engineeringjében: az dönt, mit teszel az ablakba, és mit tartasz kint.
A Cognition egy második, finomabb hasznot is talált: a tiszta kontextus javítja a reviewert. A 2026. áprilisi folytatásukban azt írják, hogy a review ügynökük jobban dolgozik, ha nem osztja meg a kontextust a kódoló ügynökkel, mert önállóan gondolkodik, ahelyett hogy örökölné a szerző feltevéseit. Közlésük szerint a Devin Review átlagosan 2 hibát talál pull requestenként, nagyjából 58%-uk súlyos. Ez gyártói adat, de a mechanizmus hihető és olcsón kipróbálható. Illeszkedik az AI által generált pull requestek review-szűk keresztmetszetéhez is.
Mibe kerül: a tokenszorzó
Az Anthropic szokatlanul őszinte erről a multi-agent kutatórendszerről szóló bejegyzésében: az ügynökök jellemzően nagyjából 4-szer több tokent használnak, mint a chat, a multi-agent rendszerek nagyjából 15-ször többet. Arra jutnak, hogy ilyen rendszerekhez olyan feladatok kellenek, amelyek értéke indokolja a költséget.
Ugyanennek a bejegyzésnek van egy kényelmetlen olvasata is. A BrowseComp benchmarkon végzett elemzésükben a tokenhasználat önmagában a teljesítményszórás 80%-át magyarázta. Amit egy multi-agent rendszer vásárol, annak egy része egyszerűen több gondolkodás kérdésenként. Ez jogos, de azt jelenti, hogy egy ugyanakkora tokenkeretet kapó egyetlen ügynökhöz kell hasonlítani, nem egy korán abbahagyóhoz. A fő eredményük: egy Claude Opus 4 vezető Claude Sonnet 4 subagentekkel 90,2%-kal verte az egyetlen Claude Opus 4-et a belső kutatási értékelésükön, a párhuzamosítás pedig összetett kérdéseknél akár 90%-kal csökkentette a kutatási időt.
A késleltetés és a pénz ellentétes irányba húz. A párhuzamos workerek rövidítik a falióra szerinti időt, és növelik a számlát. A tokenenkénti ár csökken a cachinggel és az útválasztással, ezért olvasd el az LLM költség, késleltetés, prompt caching és routing írást, mielőtt megfizethetetlennek ítéled a szorzót. Olcsóbb worker modellek, megosztott gyorsítótárazott prefixek és a workerek számának kemény korlátja sokat változtat a gazdaságosságon.
Az Anthropic a korai verziók hibamódjait is felsorolja: 50 subagent indítása egy egyszerű kérdésre, végtelen keresés nem létező források után, és workerek, amelyek a homályos feladatleírás miatt duplázták egymás munkáját. A megoldás explicit skálázási szabály volt a promptban, hogy az erőfeszítés a kérdés bonyolultságához igazodjon, és jóval részletesebb feladatleírás minden workernek.
Hogyan hibáznak a multi-agent rendszerek
A kutatás egy pontban egybehangzó: a hibák többnyire a koordinációról szólnak, nem a modellek intelligenciájáról.
- Szétszórt döntések. A Cognition 2025. júniusi „Don't Build Multi-Agents” bejegyzése két elvre épül: oszd meg a kontextust, és „a cselekvések implicit döntéseket hordoznak”. A példájuk egy Flappy Bird klón, amelyet részfeladatokra bontanak: az egyik subagent Super Mario stílusú hátteret épít, a másik olyan madarat, amely nem néz ki és nem viselkedik úgy, mint a Flappy Bird, az utolsó ügynöknek pedig össze kell fésülnie az eltérést. Összegzésük: több, együttműködő ügynök futtatása csak törékeny rendszereket eredményez.
- A szekvenciális munka romlik. A Google Research 180 ügynökkonfigurációt értékelt. A központosított koordináció 80,9%-kal javított egy párhuzamosítható pénzügyi következtetési feladaton az egyetlen ügynökhöz képest, míg egy szekvenciális tervezési feladaton minden tesztelt multi-agent változat 39–70%-kal rontott a teljesítményen. A független ügynökök 17,2-szeresére erősítették a hibákat, a központi orchestrator csak 4,4-szeresére, mert érvényesítési szűk keresztmetszetként működik. A szerzők eszköz-koordinációs kompromisszumot is jeleznek: az overhead aránytalanul nő az eszközigényes feladatoknál.
- A hibák taxonómiája. A MAST tanulmány (Cemri és társai) több mint 1600 annotált nyomvonalat elemzett 7 multi-agent keretrendszerből, és 14 hibamódot három kategóriába sorolt: rendszertervezési problémák, ügynökök közti félreértés és feladat-ellenőrzés. A szerzők megjegyzik, hogy a népszerű benchmarkokon a teljesítménynyereség gyakran minimális, és több esetben ugyanaz a modell együgynökös felállásban jobban teljesített.
- A debate alapból túlértékelt. Du és társai (2023) megmutatták, hogy több vitatkozó modellpéldány javíthatja a következtetést és a tényhűséget. Egy 2025-ös értékelés 5 debate-módszert vizsgált 9 benchmarkon és 4 modellen, és azt találta, hogy ezek a sokkal több inferencia-számítás ellenére gyakran nem előzik meg a Chain-of-Thoughtot és a Self-Consistency-t. A modellek heterogenitása segített: különböző modellekből származó vitatkozók.
- A párhuzamos írók ütköznek. 2026 áprilisában a Cognition frissítette a nézetét: a multi-agent rendszerek ma akkor működnek a legjobban, ha az írás single-threaded marad, és a további ügynökök intelligenciát, nem cselekvést adnak hozzá; a legtöbb rajszerű ötlet még alig terjed. Az Anthropic is rossz illeszkedésnek nevezi a kódolási munka nagy részét, mert alig párhuzamosítható.
A forrásokat átfogó minta az olvasás és írás szétválasztása. Az olvasás, keresés, elemzés és review jól párhuzamosítható, mert minden eredmény önmagában megítélhető. A kódírás, a megosztott állapot módosítása és a tervezési döntések nem, mert minden cselekvés olyan döntéseket hordoz, amelyeket a többi ügynök nem lát.
Az ellenőrzés a másik visszatérő hiány. Ha senki sem ellenőrzi az egyesített eredményt, a hibák továbbterjednek; a Google számai megmutatják, mennyit fog vissza egy központi érvényesítési lépés. Az orchestrator összefésülő lépését kezeld explicit ellenőrzések helyeként, a teljes rendszert pedig a funkcióhoz épített evalokkal mérd, ne néhány nyomvonal átolvasásával.
Döntési keretrendszer
Ezt a táblázatot használnám egy design review-n. A kérdés sosem az, hogy „egy vagy több”, hanem hogy melyik konkrét forma térül meg ezen a feladaton.
| Helyzet | Jel | Minta | Miért |
|---|---|---|---|
| Széles kutatás sok független forrásból | A részfeladatok előre ismeretlenek, és nagyobbak egy kontextusablaknál | Orchestrator-worker | Az elszigetelt ablakok szélességet adnak; az Anthropic itt nagy nyereséget közöl, nagyjából a chat tokenjeinek 15-szörösén |
| Független ellenőrzések vagy lekérdezések ismert halmaza | Ugyanaz a művelet N elemen, függőségek nélkül | Párhuzamos fan-out (sectioning) | A falióra szerinti idő csökken, az összefésülésen túl nincs szükség koordinációra |
| Nagy tétű kimenet, amelynek hibáit egy második pillantás megfoghatja | A review-nak jót tesz, ha nem osztja a szerző feltevéseit | Író és critic friss kontextussal | Független ellenőrzés; ideális esetben más modell, ahogy a debate-vizsgálat sugallja |
| Több terület eltérő eszközökkel vagy promptokkal | Irányítás szakértők között, egyszerre egy aktív | Handoff | Minden szakértő rövid promptot és kevés eszközt kap; döntsd el, mennyi előzmény vándoroljon |
| Zajos kimenetű mellékfeladat | Logok, keresési találatok vagy fájltartalmak, amelyekre többé nem hivatkozol | Összefoglalót visszaadó subagent | Tisztán tartja a fő kontextust, az ár a tiszta lappal indulás |
| Többlépéses munka, amelynek lépései egymásra épülnek | Tervezés, refaktorálás, egy dokumentum, megosztott állapot | Egyetlen ügynök | A szekvenciális feladatok a Google vizsgálatában a multi-agent változatoknál 39–70%-kal romlottak |
| Párhuzamos módosítások ugyanabban a kódbázisban | Ellentmondó stílus- és szélsőeset-döntések | Egy író, a segítők csak olvasnak | Cognition: az írás maradjon single-threaded |
Ha egy sor azt mondja, egyetlen ügynök, a bajban lévő rendszer szokásos orvossága nem egy újabb ügynök, hanem jobb harness: világosabb utasítások, jobb eszközök, compaction és checkpointok. Az Anthropic saját tanácsa a Building effective agentsben az, hogy keresd a lehető legegyszerűbb megoldást, és csak akkor növeld a bonyolultságot, ha az bizonyíthatóan javít az eredményen; arra is figyelmeztet, hogy a keretrendszerek elfedhetik a promptokat és a válaszokat, és megnehezíthetik a hibakeresést.
Ellenőrzőlista, mielőtt ügynököt adsz hozzá
- Építsd meg először az együgynökös alapvonalat, ugyanazokkal az eszközökkel és tisztességes tokenkerettel.
- Írd le az elszigetelési érvet: mi marad ki kinek a kontextusából.
- Sorold be a munkát olvasás- vagy írásigényesnek. Az írást tartsd single-threaded.
- Adj minden workernek teljes feladatleírást: cél, kimeneti formátum, eszközök, határok és leállási feltétel, mert nem örököl semmit.
- Tégy explicit skálázási szabályokat a vezető promptjába, és kemény korlátot a workerekre és a körökre.
- Adj hozzá ellenőrző lépést az egyesített eredményre, és döntsd el, ki mondhatja ki, hogy „kész”.
- Mindkét változatot először nagyjából 20 valósághű kérdésen értékeld, ahogy az Anthropic javasolja, majd bővítsd a halmazt. Hasonlítsd össze a minőséget, a tokeneket, a késleltetést és a hibaarányt.
- Naplózz minden delegálást a feladatleírással és az összefoglalóval, hogy debugolhasd az elveszett kontextust, és tervezd meg, hogyan élik túl a futó ügynökök a deploymentet.
Az utolsó ponthoz: az Anthropic megjegyzi, hogy az ügynökfolyamatok állapottartók és hosszan futnak, ezért rainbow deploymenteket használ, amelyek fokozatosan terelik át a forgalmat ahelyett, hogy megszakítanák a futó munkákat. A költségkontroll ugyanennek a fegyelemnek a része; a tokentakarékos eszközök kódoló ügynököknek a workerekre is érvényesek.
Mit tennék én
Egy tipikus vállalati esetben egyetlen ügynököt szállítanék erős eszközökkel és jó harnesszel, és pontosan egy multi-agent elemet adnék hozzá ott, ahol az elszigetelési érv erős: egy kutató subagentet, amely hivatkozásokkal ellátott összefoglalót ad, vagy egy tiszta kontextusú reviewert a kimenetre. Mindkettő egy ügynöknél tartja az írást, és könnyen mérhető az alapvonalhoz képest.
Kerülném az egyenrangú ügynökök rajait, az azonos modellű ügynökök nyílt vitáját és a párhuzamos kódírókat, amíg a bizonyítékok nem változnak. Még a Cognition, a leghangosabb kritikus is a működő multi-agent megoldások egy szűkebb osztályát írja le ma. A legutóbbi gyártói bejegyzések, amelyeket elolvastam, ugyanazt a formát írják le: egy orchestrator, amely birtokolja a kontextust, elszigetelt segítőkkel, amelyek összefoglalót adnak vissza. Ezt az architektúrát érdemes megtanulni, és jól illeszkedik ahhoz az AI engineering munkához, amelyet ügyfeleimnek végzek.
Források
- Anthropic Engineering: How we built our multi-agent research system
- Anthropic: Building effective agents
- Cognition: Don't Build Multi-Agents (12 June 2025)
- Cognition: Multi-Agents: What's Actually Working (22 April 2026)
- Google Research: Towards a science of scaling agent systems
- arXiv 2512.08296: Towards a Science of Scaling Agent Systems
- arXiv 2503.13657: Why Do Multi-Agent LLM Systems Fail? (MAST)
- arXiv 2305.14325: Improving Factuality and Reasoning in Language Models through Multiagent Debate
- arXiv 2502.08788: Stop Overvaluing Multi-Agent Debate
- OpenAI Agents SDK: Handoffs
- Claude Code documentation: Subagents
Gyakori kérdések
Mikor érdemes multi-agent rendszert használni egyetlen ügynök helyett?
Ha a munka inkább széles, mint mély: sok független kérdés, egy kontextusablakot meghaladó források, vagy olyan mellékfeladatok, amelyek elárasztanák a fő beszélgetést kimenettel. Az Anthropic a szélességi kutatást nevezi ideális esetnek. Ha a lépések egymásra épülnek vagy sok kontextust osztanak meg, általában az egyetlen ügynök a jobb.
Mennyivel több tokent használnak a multi-agent rendszerek?
Az Anthropic szerint az ügynökök nagyjából 4-szer több tokent használnak, mint a chat, a multi-agent rendszerek nagyjából 15-ször többet. A BrowseComp benchmarkon végzett elemzésük szerint a tokenhasználat önmagában a teljesítményszórás nagyjából 80%-át magyarázta, tehát a nyereség egy része egyszerűen több számítás.
Miért hibáznak a multi-agent LLM rendszerek?
Az 1600-nál több annotált nyomvonalat vizsgáló, 7 keretrendszert átfogó MAST tanulmány 14 hibamódot csoportosít három kategóriába: rendszertervezési problémák, ügynökök közti félreértés és feladat-ellenőrzés. A gyakorlatban ez homályos feladatleírást, a következő ügynökig el nem jutó kontextust, duplikált munkát és ellenőrzés hiányát jelenti.
Megéri a multi-agent debate?
Alapértelmezésként ritkán. Az eredeti debate-tanulmány jobb következtetést és tényhűséget mért, de egy későbbi, 5 módszert 9 benchmarkon vizsgáló értékelés szerint a vita gyakran nem veri meg a Chain-of-Thoughtot vagy a self-consistency-t, pedig több számítást használ. Ebben a vizsgálatban a különböző modellek használata segített.
Mi a különbség a handoff és a subagent között?
A handoff átadja az irányítást: a következő ügynök átveszi a beszélgetést, alapértelmezés szerint a teljes előzményekkel. A subagent friss kontextusban kap egy mellékfeladatot, és csak összefoglalót ad vissza, a hívó pedig felelős marad. A handoff a szakértők közti irányításra jó, a subagent a kontextus elszigetelésére.
Futtassanak a kódoló ügynökök subagenteket párhuzamosan?
Óvatosan. A Cognition szerint a párhuzamos író ügynökök egymásnak ellentmondó, implicit döntéseket hoznak a stílusról és a szélső esetekről, és úgy látják, ma a multi-agent megoldások akkor működnek a legjobban, ha az írás single-threaded marad. A feltáráshoz, kereséshez és review-hoz használt subagentek a biztos felhasználás.