Blog/MI-ágensek
20 módszer, hogy kevesebb tokent égessenek a kódoló ágensek: rtk, lean-ctx, Serena és társaik, bizonyítékok szerint rangsorolva
Az rtk, a lean-ctx, a context-mode, a Serena és még 16 tokenspóroló kódoló ágensekhez, bizonyítékok szerint rangsorolva, saját mérésekkel egy valódi Nuxt-kódbázison.
Balázs Csorba··17 perc olvasás
- Claude Code
- token usage
- context engineering
- developer tools
A lényeg röviden
- A tokenspórolók százalékai többnyire azt mérik, mennyivel rövidebb a kimenet azokon a parancsokon, amelyekben az eszköz a legjobb, nem azt, mennyivel kisebb a számla. Felső korlátnak érdemes tekinteni őket.
- Az ingyenes beépített szokások jönnek először: mérés a /usage paranccsal és a ccusage-dzsel, /clear a feladatok között, stabil, gyorsítótárazott előtag, kevesebb MCP-szerver és alacsonyabb effort.
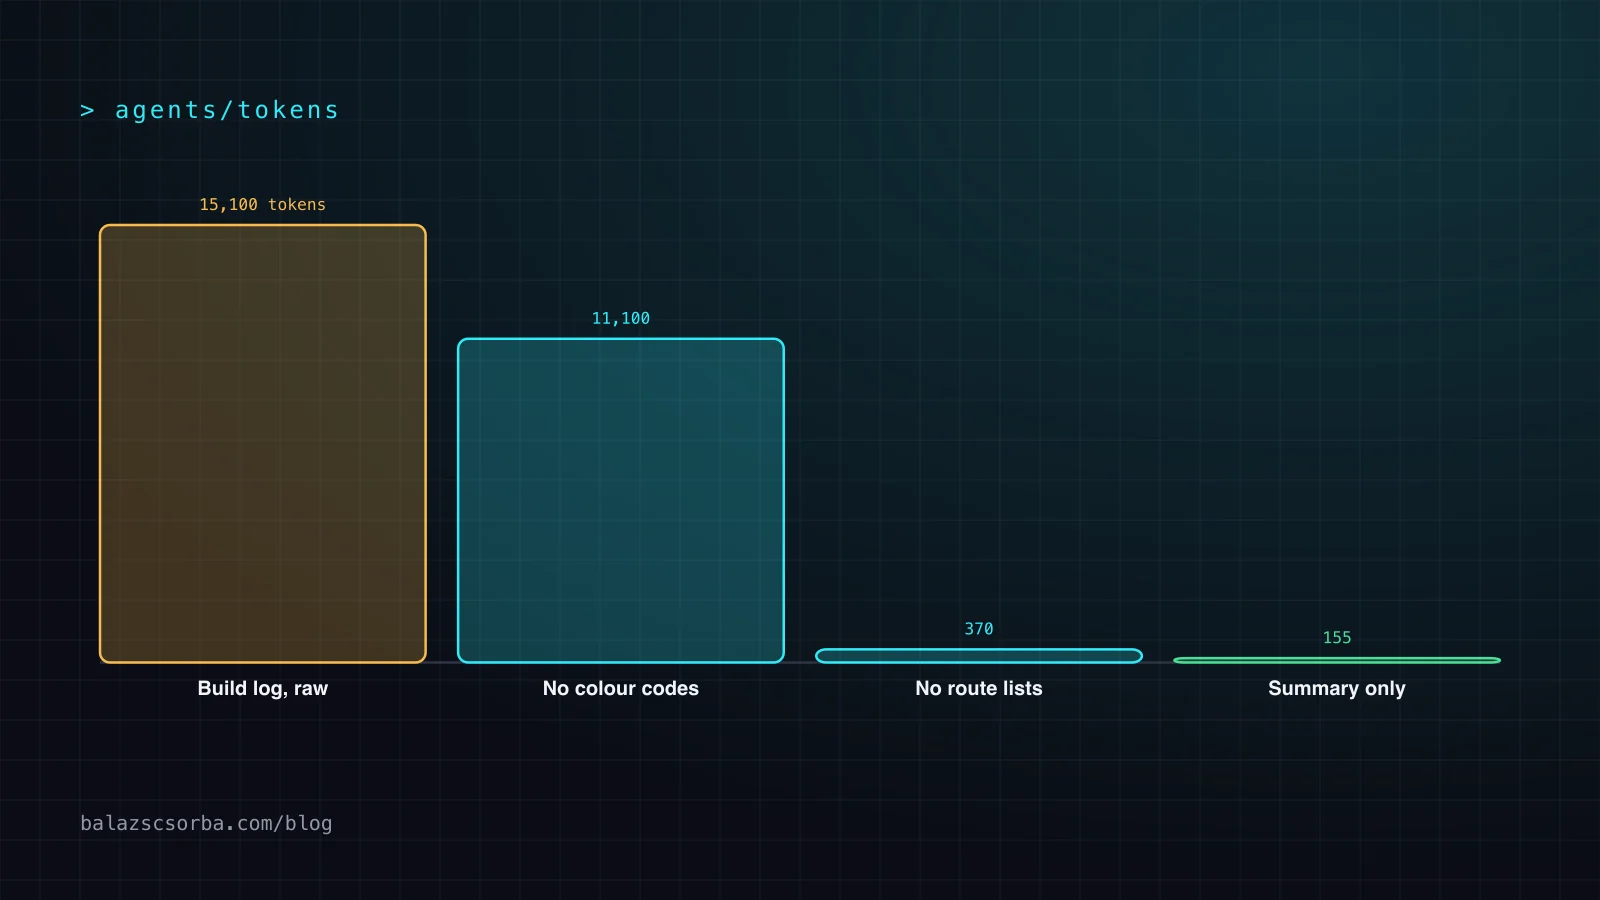
- A legnagyobb szivárgás, amit mértem, a shell-kimenet volt: egy 15 100 tokenes build-napló körülbelül 370 tokenre zsugorodott úgy, hogy egyetlen hasznos sor sem veszett el, pusztán a színkódok, a figyelmeztetések és az útvonallisták elhagyásával.
- Olvasási oldalon a szimbólumnavigáció (code intelligence pluginek, Serena, lean-ctx) jobb, mint egész fájlokat olvasni. A Repomix --compress az én futtatásomban 79%-kal rövidítette a TypeScriptet, a Vue-fájlokat viszont 30%-kal megnövelte.
- Az egyetlen független összehasonlító teszt, amit találtam, a token-saviort, a claude-token-efficientet és a cavemant hozta ki az élre 38–43%-kal, egyetlen repón mérve.
A kódoló ágensek költségcsökkentéséről szóló tanácsok többsége egy képernyőképig jut el, amelyen egy számláló 90% megtakarítást mutat. Tudni akartam, melyik eszköz állja is a szavát, ezért végigmentem több mint húsz tokenspóroló README-jén és benchmarkján, összevetettem őket az egyetlen független összehasonlító teszttel, amit találtam, és két ötletet lemértem ennek az oldalnak a saját kódbázisán. Ez a rangsor lett belőle.
A rangsor a Claude Code-hoz készült, mert ezzel dolgozom, és ennek a hivatalos dokumentációja a legkonkrétabb, de a lista legtöbb eszköze a Cursorba, a Codexbe, az OpenCode-ba vagy bármely más ágensbe is beköthető, amely MCP-t beszél vagy shell hookokat futtat. Hogy a kontextus mérete miért határozza meg egyszerre a költséget és a minőséget, arról a kontextustervezés kódoló ágenseknek és a prompt caching és modellválasztás cikk szól.
Honnan jönnek egy ágenskör tokenjei
Minden kérés, amit egy ágens elküld, négyféle tokent visz, és a lista minden eszköze ezek közül egyen dolgozik. Az előtag a rendszerprompt, az eszközdefiníciók és a CLAUDE.md. Az olvasás azok a fájlok és keresési találatok, amelyeket az ágens a kód megértéséhez behúz. Az eszközkimenet az, amit a shell-parancsok, a tesztfuttatók és az MCP-szerverek visszaírnak. A modellkimenet a gondolkodás és a válasz. Mind a négy felgyűlik az előzményekben, amelyek minden körben újra elmennek.
Az árak nem szimmetrikusak, és ez dönti el, hol számít a spórolás. A prompt caching dokumentáció szerint a Claude Opus 5.5-nél egy gyorsítótárból olvasott bemeneti token millió darabonként 0,20 dollár, egy friss 4 dollár, egy kimeneti token pedig 20 dollár. Egy stabil, gyorsítótárazott előtag tehát az első kérés után szinte ingyenes. Az új tartalom kerül pénzbe: a frissen olvasott fájlok, a friss eszközkimenet és minden, amit a modell ír, a gondolkodást is beleértve. A Claude Code saját költségútmutatója szerint az átlag nagyjából 13 dollár fejlesztőnként és aktív naponként, a felhasználók 90%-ánál 30 dollár alatt. A gond tehát ritkán egyetlen nagy számla, sokkal inkább egy folyamatos szivárgás sok körön át.
Amit ezen az oldalon mértem
Két állítást itt olcsón le lehetett ellenőrizni. Ez az oldal egy Nuxt 4-es alkalmazás nagyjából 110 Vue-, TypeScript- és szkriptfájllal, a buildje pedig rengeteget ír ki. A Repomix 1.18.1-es verzióját futtattam a forráskódon az alapértelmezett o200k_base tokenizálóval, egyszer simán és egyszer --compress kapcsolóval, amely tree-sitterrel megtartja a szignatúrákat és eldobja a függvénytörzseket. A README körülbelül 70%-os csökkenést ígér.
A TypeScript- és szkriptfájloknál az állítás bőven teljesül: 133 146 tokenből 28 402 lett, ez 79%-os csökkenés. A Vue single-file komponenseknél fordítva történt: 72 298 tokenből 94 096 lett, 30%-kal több, és a 49 fájlból 46 megnőtt. A kimenetbe belenézve kiderül, miért: a tömörített Vue-fájlok megtartották a teljes templatet, majd annak darabjait még egyszer, külön szakaszokként megismételték ⋮---- jelölők között. A teljes kódbázison 40% lett a megtakarítás, nem 70.
A második teszt az a helyzet volt, amelyre az rtk és a lista összes többi kimenetszűrője készült: egy zajos parancs. Ennek az oldalnak egy teljes npm run generate futása 501 sort ír ki. A naplót lépésenként ritkítottam, a tokeneket pedig bájtok osztva néggyel becsültem, ugyanazzal a durva ökölszabállyal, amit az rtk is használ.
| Lépés | Bájt | Token (bájt/4) | Sor |
|---|---|---|---|
| Nyers napló, ahogy a fájlba került | 60 311 | ~15 100 | 501 |
| ANSI-színkódok nélkül | 44 426 | ~11 100 | 501 |
| A Node kísérleti figyelmeztetései nélkül | 42 144 | ~10 500 | 481 |
| Az útvonal- és chunklisták nélkül | 1 479 | ~370 | 46 |
| Csak az összegző és a hibasorok | 620 | ~155 | 12 |
Csak a színkódok a napló negyedét tették ki, pedig a kimenet fájlba volt irányítva. Az előrenderelt útvonalak és a lefordított chunkok listái a maradék 96%-át adták, és egy zöld buildnél ezekből semmi sem mond semmit egy modellnek. Ha ezt a hármat elhagyjuk, minden sor megmarad, amelyre egy ember reagálna, a tokenek 97,5%-a pedig eltűnik. Egy piros buildnél a hibasorok és a körülöttük lévő néhány sor kell, és egy jó szűrő pontosan ezeket tartja meg.
A top 20 rangsorolva
Négy szempont szerint rangsoroltam, ebben a sorrendben: van-e a megtakarítás mögött más is, mint a szerző saját benchmarkja, egy valódi munkamenet mekkora részét érinti, mennyi idő a beállítás, és mit kockáztat, a veszteséges kimenettől a korlátozó licencig. A beépített szokások jönnek előre, mert ingyenesek és dokumentáltak; utánuk a külső eszközök következnek, a bizonyítékok szerint sorba rendezve.
| # | Eszköz vagy szokás | Réteg | Bizonyíték | Beállítás |
|---|---|---|---|---|
| 1 | /usage, /context, ccusage | mind | maga a mérés | percek |
| 2 | /clear és célzott /compact | előzmények | hivatalos dokumentáció | nincs |
| 3 | Stabil előtag a prompt cachinghez | előtag | hivatalos árazás | nincs |
| 4 | Tool search, kevesebb MCP-szerver, CLI-k | előtag | hivatalos: az eszközdefiníciók több mint 85%-a | percek |
| 5 | Effort és modellválasztás | modellkimenet | hivatalos dokumentáció | nincs |
| 6 | rtk | eszközkimenet | állított 60–90%; mért 0–90% | 5 perc |
| 7 | context-mode | eszközkimenet | állított legfeljebb 98%; mért 20–98% | 10 perc |
| 8 | Saját szűrőhookok, MAX_MCP_OUTPUT_TOKENS | eszközkimenet | saját build-napló: −97,5% | egy óra |
| 9 | lean-ctx | olvasás | állított 98% map módban | 10 perc |
| 10 | Serena | olvasás | mechanizmus; nincs semleges szám | 15 perc |
| 11 | Code intelligence pluginek | olvasás | hivatalos dokumentáció | percek |
| 12 | Karcsú CLAUDE.md, a többi skillekbe | előtag | hivatalos: 200 sor alatt | egy óra |
| 13 | Subagentek a bőbeszédű munkára | előzmények | hivatalos dokumentáció | nincs |
| 14 | token-savior | olvasás | mért −43% | 15 perc |
| 15 | Repótérképek: Aider, code-review-graph | olvasás | állított nagy; mért −5% egy kis repón | változó |
| 16 | repomix --compress | olvasás | saját futtatás: −79% TS, +30% Vue | percek |
| 17 | Context7 | olvasás | mechanizmus; nincs szám | percek |
| 18 | claude-context | olvasás | állított kb. 40%; mért 30–60% monorepókon | egy óra, vektoradatbázis kell |
| 19 | Tömör kimeneti szabályok: caveman, claude-token-efficient | modellkimenet | a kimeneti tokenek 4–12%-a | percek |
| 20 | claude-code-router | ár, nem token | 3–5-ször olcsóbb az átirányított körökön | egy óra |
Az egyetlen független összehasonlító teszt, amit találtam, a ComputingForGeeks 2026 áprilisi mérése: egy repó (sindresorhus/ky), Claude Code 2.1.116 és Sonnet 4.5, egy 284 473 tokenes, 0,27 dolláros alapméréssel szemben. Egyetlen repó vékony bizonyíték, ezért döntetlen esetekben használom, nem ítéletként.
| Eszköz | Változás az összes tokenben | Megjegyzés |
|---|---|---|
| token-savior | −43% | szimbólumindex és memória MCP-n |
| claude-token-efficient | −40% | CLAUDE.md-szabályok |
| caveman | −38% | kimeneti stílus |
| token-optimizer-mcp | −23% | MCP-szerver |
| alexgreensh/token-optimizer | −18% | PolyForm Noncommercial licenc |
| code-review-graph | kb. −5% | kis repó, a gráf többletköltsége felemészti a nyereséget |
| rtk | 0% tiszta kimenetnél, 60–90% zajos naplóknál | a parancsoktól függ |
| context-mode | −20%-tól −98%-ig | a munkától függ |
1–5. hely: beépített szokások, amelyek semmibe sem kerülnek
1. Először mérj: /usage, /context és ccusage
A /usage a munkamenet tokenjeit mutatja, az újabb verziókban pedig egy prompt cache sort is: a bemenet mekkora része jött a gyorsítótárból, hány találati hiba volt, és mi lehetett az utolsó oka. A /context azt mutatja, mi tölti meg éppen az ablakot: rendszerprompt, eszközök, memóriafájlok és üzenetek. A munkamenetek közötti előzményekhez a ccusage (npx ccusage@latest, MIT) a helyi JSONL-naplókat olvassa, és napi, havi, munkamenetenkénti és ötórás blokkonkénti jelentést készít. Alapmérés nélkül nem tudod megkülönböztetni a 40%-ot hozó eszközt a placebótól.
2. /clear a feladatok között, /compact utasítással
A teljes előzmény minden körben elmegy, így az előző feladatból ottmaradt, elavult kontextust minden új üzenettel újra megfizeted. A /clear tiszta lappal indul, és semmibe sem kerül. A /compact Fókuszálj a hibás tesztre és a diffre megőrzi a folytonosságot, de ehhez el kell olvasnia az egész beszélgetést, hogy összefoglalja, tehát önmagában is nagy kérés. Ha később vissza akarsz térni a /resume paranccsal, ürítés előtt nevezd el a munkamenetet a /rename paranccsal.
3. Tartsd stabilan az előtagot, hogy működjön a gyorsítótár
A gyorsítótár a lista legnagyobb kedvezménye, és alapból be van kapcsolva, ezért könnyű észrevétlenül elrontani. A gyorsítótár az eszközök, rendszerprompt, üzenetek sorrendet követi: ha egy eszközdefiníció megváltozik, minden, ami utána jön, újra kiíródik, a drágább cache-írási áron. A gyakorlatban ez azt jelenti, hogy ne kapcsolgass MCP-szervereket munkamenet közben, és ne szerkeszd a CLAUDE.md-t egy hosszú feladat felénél. A gyorsítótár élettartama előfizetéssel egy óra, API-kulccsal alapból öt perc, így az API-n egy kávészünet a teljes kontextus újraolvasásába kerül.
4. Kevesebb MCP-szerver, késleltetve betöltött eszközök, CLI, ahol van
Az Anthropic tool search dokumentációja konkrét számot ad: öt gyakori szerver (GitHub, Slack, Sentry, Grafana és Splunk) nagyjából 55 000 tokennyi definíciót foglal el, mielőtt bármilyen munka elkezdődne, a késleltetett betöltés pedig ezt jellemzően több mint 85%-kal csökkenti. Azt is leírja, hogy 30–50 betöltött eszköz fölött romlik az eszközválasztás. A Claude Code alapból késleltetve tölti be az MCP-eszközöket, de az MCP-dokumentáció felsorol olyan beállításokat, amelyekben a tool search ki van kapcsolva, köztük az ENABLE_TOOL_SEARCH=false és az egyedi ANTHROPIC_BASE_URL esetét. Ezen felül kapcsold ki a /mcp alatt azokat a szervereket, amelyeket nem használsz, és ugyanahhoz az API-hoz inkább a gh, az aws vagy a gcloud parancsot válaszd egy MCP-csomagoló helyett, mert egy CLI egyáltalán nem ad hozzá eszközlistát.
5. Az effortot és a modellt igazítsd a feladathoz
A gondolkodási tokeneket kimeneti tokenként számlázzák, ez a legdrágább fajta. Az /effort adaptív modelleknél csökkenti a gondolkodási keretet, a /model pedig olcsóbb modellre vált; a subagentek a definíciójukban szereplő model: haiku sorral Haikun futnak. A nagyságrendet az Opus 5.5 ranglistás számai mutatják: medium effort mellett a modell hozta elődje max effortos pontszámát, feladatonként nagyjából negyed áron.
6–8. hely: szűrd meg az eszközkimenetet, mielőtt a modell elolvassa
6. rtk
Az rtk egy Rust CLI, amely egy PreToolUse hookon keresztül (rtk init -g) a shell-parancsok elé áll, és több mint száz parancs kimenetét szűri, csoportosítja, levágja és duplikációmentesíti. A README az ls és a tree esetén körülbelül 70%-ot, a git diff-nél körülbelül 80%-ot, a cargo test-nél 90%-ot ír. A független teszt az eleve csendes parancsoknál 0%-ot, a zajos naplóknál 60–90%-ot mért, ami egyezik a saját build-naplómmal. Két korlát: a számok a kimenet csökkenését mérik, nem a számláét, a hook pedig csak shell-parancsokat lát, így a Claude Code beépített Read, Grep és Glob eszközei érintetlenül mennek át. Apache 2.0.
7. context-mode
A context-mode másik utat választ: az eszközkimenet egy sandboxba és egy SQLite FTS5 indexbe kerül, az ágens pedig BM25-tel keres benne ahelyett, hogy egészben elolvasná. A projekt szerint 315 KB kimenet 5,4 KB-ra zsugorodik, egy Playwright-pillanatkép 56 KB-ról 299 bájtra, egy access log 45 KB-ról 155 bájtra, és egy legfeljebb 2 KB-os munkamenet-útmutatót is megtart, amely túléli a tömörítést. A független teszt a munkától függően 20–98%-ot mért. Elastic License 2.0 alatt érhető el, ami saját használatra rendben van, de nem OSI szerinti nyílt forrású licenc.
8. Saját szűrőhookok és felső korlát az MCP-kimenetre
A hivatalos költségútmutató egy olyan PreToolUse hookot mutat be, amely úgy írja át a tesztparancsokat, hogy csak a hibák jussanak el a modellig. Ugyanez az ötlet bármely gyakran futtatott parancsra működik. A fenti buildhez én így írnám meg:
#!/bin/bash
# ~/.claude/hooks/quiet-build.sh: a PreToolUse hook with "matcher": "Bash".
# Rewrites the site build so the model sees summary and error lines, not 500 lines of routes.
input=$(cat)
cmd=$(echo "$input" | jq -r '.tool_input.command')

if [[ "$cmd" =~ ^npm\ run\ generate ]]; then
  quiet="set -o pipefail; $cmd 2>&1 | perl -pe 's/\e\[[0-9;]*m//g' | grep -vE 'ExperimentalWarning|trace-warnings|├─|└─|node_modules/.cache'"
  echo "$input" | jq --arg c "$quiet" \
    '{hookSpecificOutput: {hookEventName: "PreToolUse", permissionDecision: "allow", updatedInput: (.tool_input + {command: $c})}}'
else
  echo "{}"
fi
A táblázatban szereplő naplón lefuttatva pontosan a negyedik sor 46 sora marad meg, a pipefail miatt pedig egy hibás build továbbra is hibakóddal áll le. A settings.json fájlban a hooks.PreToolUse alatt kell regisztrálni "matcher": "Bash" beállítással, ahogy a hivatalos példában, és a /hooks paranccsal ellenőrizni. A példához hasonlóan allow választ ad, ami az átírt parancsnál az engedélykérést is kihagyja, ezért a minta legyen szűk. MCP-szervereknél a megfelelő eszköz a MAX_MCP_OUTPUT_TOKENS: a Claude Code figyelmeztet, ha egyetlen eszközeredmény átlépi a 10 000 tokent, alapból pedig 25 000-ig engedi. Egy alacsonyabb korlát megakadályozza, hogy egyetlen bőbeszédű szerver elárassza az ablakot.
9–11. hely: szimbólumokat olvass, ne egész fájlokat
9. lean-ctx
A lean-ctx egy helyi Rust bináris és MCP-szerver, amely tízféle módot ad az ágensnek egy fájl olvasására, a teljes szövegtől a szerkezeti térképen át a puszta szignatúrákig, emellett több mint 95 shell-parancshoz ad tömörítési mintát. A projekt saját, 50 fájlos repóján, GPT-4o tokenizálóval számolva, 533 200 nyers tokenből map módban 8 000, szignatúra módban 14 000 lett, egy változatlan fájl újraolvasása a gyorsítótárból pedig körülbelül 13 tokenbe kerül. Ez a legambiciózusabb eszköz a listán, és a számok a szerzőtől származnak, de az ötlet, hogy előbb a szerkezetet olvassuk, a törzseket pedig csak szükség esetén, helyes. lean-ctx wrap claude, Apache 2.0.
10. Serena
A Serena több mint 40 nyelv language serverét csomagolja MCP-eszközökbe, például find_symbol, find_referencing_symbols és replace_symbol_body néven. Ahelyett, hogy grepelne és három jelölt fájlt végigolvasna, az ágens egyetlen szimbólumot kér le, és helyben szerkeszti. Semleges benchmarkot nem találtam, de a mechanizmus ugyanaz, amit az Anthropic a következő pontban ajánl, és bármely MCP-kliensben működik. Telepítés: uv tool install -p 3.13 serena-agent, majd serena init; GPL-3.0.
11. Code intelligence pluginek
A Claude Code saját code intelligence pluginjei külső szerver nélkül hozzák ugyanezt: ugrás a definícióhoz és a hivatkozások keresése egy telepített language serveren keresztül. A költségútmutató egyenesen kimondja: egyetlen definíciókeresés kivált egy grepet és utána több jelölt fájl elolvasását, a language server pedig szerkesztés után jelzi a típushibákat, ami megspórol egy fordítási kört. TypeScript-, Python-, Go- vagy Rust-projekteknél ez az első olvasási oldali változtatás, amit megcsinálnék.
12–13. hely: tartsd kicsiben a fő kontextust
12. Karcsú CLAUDE.md, a többi mehet skillekbe
A CLAUDE.md minden munkamenetbe betöltődik, így minden sorát minden kérésnél megfizeted, akár gyorsítótárból jön, akár nem. A hivatalos tanács az, hogy maradjon 200 sor alatt, a konkrét munkafolyamatokhoz tartozó utasítások pedig, például hogyan kell egy PR-t átnézni vagy egy migrációt lefuttatni, kerüljenek skillekbe, amelyek csak használatkor töltődnek be. Egy rövid skill, amely leírja az architektúrát, azt a felderítő olvasgatást is megspórolja, amellyel egy ágens minden feladatot kezd.
13. Subagentek a bőbeszédű munkára
Egy subagent a saját kontextusában futtat teszteket, olvas naplókat vagy tölt le dokumentációt, és csak egy összefoglalót ad vissza, így a bőbeszédű rész sosem kerül a fő előzményekbe. Tokenbe ettől még kerül, csak nem minden későbbi körben újra, és futhat kis modellen is. Az ellenkező irányú figyelmeztetés ugyanabban a dokumentációban áll: az agent teamek nagyjából hétszer annyi tokent használnak, mint egy normál munkamenet, ha a csapattagok plan módban futnak, mert mindegyiknek saját, teljes kontextusa van.
14–18. hely: indexek, térképek és dokumentáció
14. token-savior
A token-savior egy MCP-n elérhető szimbólumindexet, egy memóriatárat és a bash-kimenet tömörítését kombinálja. A független tesztben ez vágott a legtöbbet, az összes token 43%-át. A projekt saját főcímét, 96 feladaton 80%-kal kevesebb aktív tokent Opus 4.7-tel, a szerző maga jelöli ellenőrizetlennek, egy korábbi számot pedig visszavont. Ezt az őszinteség jelének tartom, nem annak, hogy a nagyobb számnak hinni kellene. MIT.
15. Repótérképek: Aider és code-review-graph
Egy repótérkép egész fájlok helyett a kódbázis rangsorolt vázlatát adja az ágensnek. Az Aider repótérképe tree-sitterrel és gráfalapú rangsorolással készül, és belefér a --map-tokens által megadott keretbe, amely alapból 1 000 token. A code-review-graph SQLite-ban tárol egy hívási gráfot, és megmondja, mire hat egy változtatás. Kérdésenként mediánban nagyjából 63-szor kevesebb tokent ír, de maga is elismeri, hogy ez egy gráflekérdezést vet össze a teljes korpusszal, vagyis felső korlát. A független tesztben egy kis repón körülbelül 5%-ot spórolt, mert a gráf többletköltsége felemésztette a nyereség nagy részét. Nagy repóknál megéri, kicsiknél nem. MIT.
16. Repomix --compress
A Repomix egyetlen fájlba csomagolja a repót egy modell számára, a --token-count-tree kapcsolóval megmutatja, hol vannak a tokenek, emellett van --remove-comments kapcsolója és MCP-módja is. A --compress arra jó, hogy egy modell egyszerre, szignatúraszinten átlássa egy TypeScript-, Python- vagy Go-kódbázis felépítését, ahogy a saját futtatásom is mutatta. Templatekkel teli formátumoknál, például Vue-nál, érdemes belenézni a kimenetbe, mielőtt építenél rá. MIT.
17. Context7 a könyvtárak dokumentációjához
A Context7 kérésre friss, verzióra pontos dokumentációt tölt le egy könyvtárhoz, vagy ctx7 CLI-parancsokkal és egy skillel, vagy egy MCP-szerveren keresztül (npx ctx7 setup). A megtakarítás közvetett, és nincs rá számom: egy célzott részlet egy teljes weboldal helyett, és kevesebb kör, amelyben egy olyan API-t kell javítani, amelyre a modell egy régebbi verzióból emlékezett. MIT.
18. claude-context
A claude-context hibrid keresésre indexeli a kódbázist, BM25 és vektorok kombinációjával, így az ágens rákérdezhet arra a kódra, amely a hitelesítést intézi, és megkapja a releváns részleteket. Körülbelül 40%-kal kevesebb tokent ír azonos találati minőség mellett, a független teszt pedig 30–60%-ot mért monorepókon. Az ára az infrastruktúra: kell egy embedding-szolgáltató (OpenAI, VoyageAI, Gemini vagy egy helyi Ollama) és egy vektoradatbázis, Milvus vagy Zilliz Cloud. Nagy monorepóknál megtérül, alattuk túlzás. MIT.
19–20. hely: kimeneti stílus és útválasztás
19. Tömör kimeneti szabályok: caveman és claude-token-efficient
Ezek az eszközök azt változtatják meg, hogyan ír a modell, nem azt, hogy mit olvas. A caveman egy skill lite, full és ultra módokkal a kurta fogalmazáshoz; a claude-token-efficient egy nyolcszabályos CLAUDE.md. A gondosan mért számok kicsik. A cavemannél egy 86 feladatos JetBrains-laborfuttatás 8,5%-kal kevesebb kimeneti tokent mért változatlan minőség mellett, a projekt saját értékelése rövid kérdés–válaszoknál 50%-os mediánt mutat, ágensmunkában pedig magas egyjegyű a csökkenés, miközben a szabályfájl körülbelül 1 000 bemeneti tokennel bővíti a kontextust. A claude-token-efficient Haikun 4%-kal, Sonneten 12%-kal, Opuson 7%-kal kevesebb kimeneti tokent mért. A független teszt −38 és −40%-a messze e fölött van, és egyetlen repóból nem általánosítanék. Olcsón kipróbálható, és akkor a leghasznosabb, ha sok kimenetért fizetsz.
20. claude-code-router
A claude-code-router egy helyi átjáró, amely szabályok alapján más szolgáltatókhoz és modellekhez küldi a Claude Code kéréseit, például a DeepSeekhez, a Geminihez, a Kimihez vagy az OpenRouterhez. Tokent nem spórol, csak egy részüket olcsóbbá teszi: a független teszt az átirányított körökön háromszor-ötször alacsonyabb költséget mért. Okkal áll a lista végén: egy router egyedi ANTHROPIC_BASE_URL beállítást jelent, ez pedig az egyik olyan eset, amikor a Claude Code kikapcsolja az MCP tool searchöt, ráadásul minden váltás egy másik modellre annak gyorsítótárát nulláról indítja. A teljes munkamenetet mérd, ne csak az átirányított köröket. MIT.
Amit kihagynék, vagy csak óvatosan használnék
- Az LLMLingua és más prompttömörítők. Az LLMLingua elhagyja azokat a tokeneket, amelyeket egy kis modell lényegtelennek ítél, és akár 20-szoros tömörítést ír kis veszteséggel folyó szövegnél, keresésnél és érvelő promptoknál. Olyan kódnál, amelyet az ágensnek pontosan kell szerkesztenie, a veszteséges tömörítés rossz alku.
- Eszközök, amelyeknek a licence nem megfelelő. Az alexgreensh/token-optimizer 18%-ot spórolt a független tesztben, de PolyForm Noncommercial licenc alatt áll, így ügyfélmunkára nem használható.
- Bármi, amit nem mértél előtte és utána. A független teszt nem ajánlotta a nadimtuhin/claude-token-optimizert, a claude-mem hatását pedig változónak találta. A memóriaeszközök megspórolhatják az újramagyarázást, de el is áraszthatnak minden munkamenetet elavult jegyzetekkel.
- Három eszköz ugyanazon a rétegen. Az rtk, a context-mode és a lean-ctx mind elfogja a shell-kimenetet. Rétegenként egyet válassz, különben a végén azt fogod keresni, melyik hook mit írt át.
Kezdőcsomag egy délutánra
- Futtasd le az
npx ccusage@latest dailyparancsot, és egy szokásos munkamenetet/usageparanccsal a végén. Írd fel a számokat. - Nyisd meg a
/contextnézetet, kapcsold ki azokat az MCP-szervereket, amelyeket ezen a héten nem használtál, és cseréld le azokat, amelyekhez van CLI (ghegy GitHub-szerver helyett). - Rövidítsd a CLAUDE.md-t 200 sor alá, a munkafolyamatokat pedig tedd skillekbe.
- Telepítsd a fő nyelvedhez tartozó code intelligence plugint, vagy a Serenát, ha több ágenst használsz.
- Adj hozzá egy kimenetszűrőt: az rtk-t, ha készet szeretnél, vagy egy 15 soros hookot, mint a fenti, ha pontosan látni akarod, mi esik ki.
- Ismételd meg ugyanazt a fajta munkamenetet, és hasonlítsd össze. Ami mozdított a számon, maradjon, a többit töröld.
A sorrend mögötti gondolatmenetet a harness engineering cikk fejti ki: hogyan tartják az irányelvek és az érzékelők egy ágens kontextusát hasznosnak, nem csak kicsinek.
Források
- rtk: a CLI proxy that filters shell output for coding agents (GitHub)
- lean-ctx: context read modes and shell compression for coding agents (GitHub)
- context-mode: sandboxed tool output with SQLite FTS5 search (GitHub)
- Serena: semantic code retrieval and editing over MCP (GitHub)
- token-savior: symbol index, memory and bash compaction over MCP (GitHub)
- code-review-graph: a code graph for blast-radius reviews (GitHub)
- Aider documentation: repository map
- Repomix: pack a repository into one AI-friendly file (GitHub)
- Context7: up-to-date library documentation for LLMs (GitHub)
- claude-context: hybrid code search MCP (GitHub)
- caveman: terse output modes for coding agents (GitHub)
- claude-token-efficient: an eight-rule CLAUDE.md (GitHub)
- claude-code-router: a local model gateway for coding agents (GitHub)
- ccusage: token and cost reports from local agent logs (GitHub)
- LLMLingua: prompt compression (Microsoft, GitHub)
- ComputingForGeeks: tools that reduce Claude Code token usage, tested (April 2026)
- Claude Code docs: manage costs effectively
- Claude Code docs: MCP, output limits and tool search
- Claude API docs: tool search tool
- Claude API docs: prompt caching
Gyakori kérdések
Melyik eszköz csökkenti a legjobban a Claude Code tokenfogyasztását?
Nincs egyetlen legjobb, mert minden eszköz a kör egy másik részén dolgozik. Kezdd az ingyenes beépített lehetőségekkel: /clear a feladatok között, stabil előtag a gyorsítótárhoz, kevesebb MCP-szerver és alacsonyabb effort. Utána jöhet egy kimenetszűrő, például az rtk vagy a context-mode, és egy olvasási oldali eszköz, például egy code intelligence plugin vagy a Serena, előtte és utána méréssel.
Tényleg 90%-nyi tokent spórol az rtk?
Zajos parancsoknál, például tesztfuttatásoknál és build-naplóknál a kimenet 60–90%-át eltávolítja, és egy független teszt is ezt a sávot mérte. Eleve rövid kimenetű parancsoknál szinte semmit sem spórol, a Claude Code beépített Read, Grep és Glob eszközeihez pedig hozzá sem nyúl, így egy teljes munkamenetre sokkal kisebb a hatása, mint amit a főcím sugall.
Biztonságos tömöríteni egy kódoló ágens kontextusát?
A szerkezetet megtartó módszerek biztonságosak: a zaj kiszűrése a naplókból, a szignatúrák olvasása a függvénytörzsek előtt és a szimbólumok keresése language serveren keresztül. A veszteséges prompttömörítés, amely egyes tokeneket kihagy, mint az LLMLingua, folyó szöveghez és kereséshez való, nem olyan kódhoz, amelyet az ágensnek pontosan kell szerkesztenie.
Hogyan mérhetem a tokenfogyasztásomat a Claude Code-ban?
Az aktuális munkamenethez a /usage parancs kell, ez a gyorsítótár-találati arányt is mutatja, a /context pedig megmutatja, mi tölti meg a kontextusablakot. A munkamenetek közötti előzményekhez a ccusage a helyi naplókat olvassa, és napi, havi, munkamenetenkénti vagy ötórás blokkonkénti bontást ad.