Blog/MI-ágensek
Human in the loop AI-ügynököknél: hová kerüljenek a jóváhagyási kapuk
Hová valók a jóváhagyási kapuk egy AI-ügynökben, hogyan kerülheted el a vaktában jóváhagyást, és hogyan működik az interrupt és resume a LangGraphban és az SDK-kban.
Balázs Csorba··13 perc olvasás
- Human in the loop
- AI agents
- Approval gates
- Agent safety
A lényeg röviden
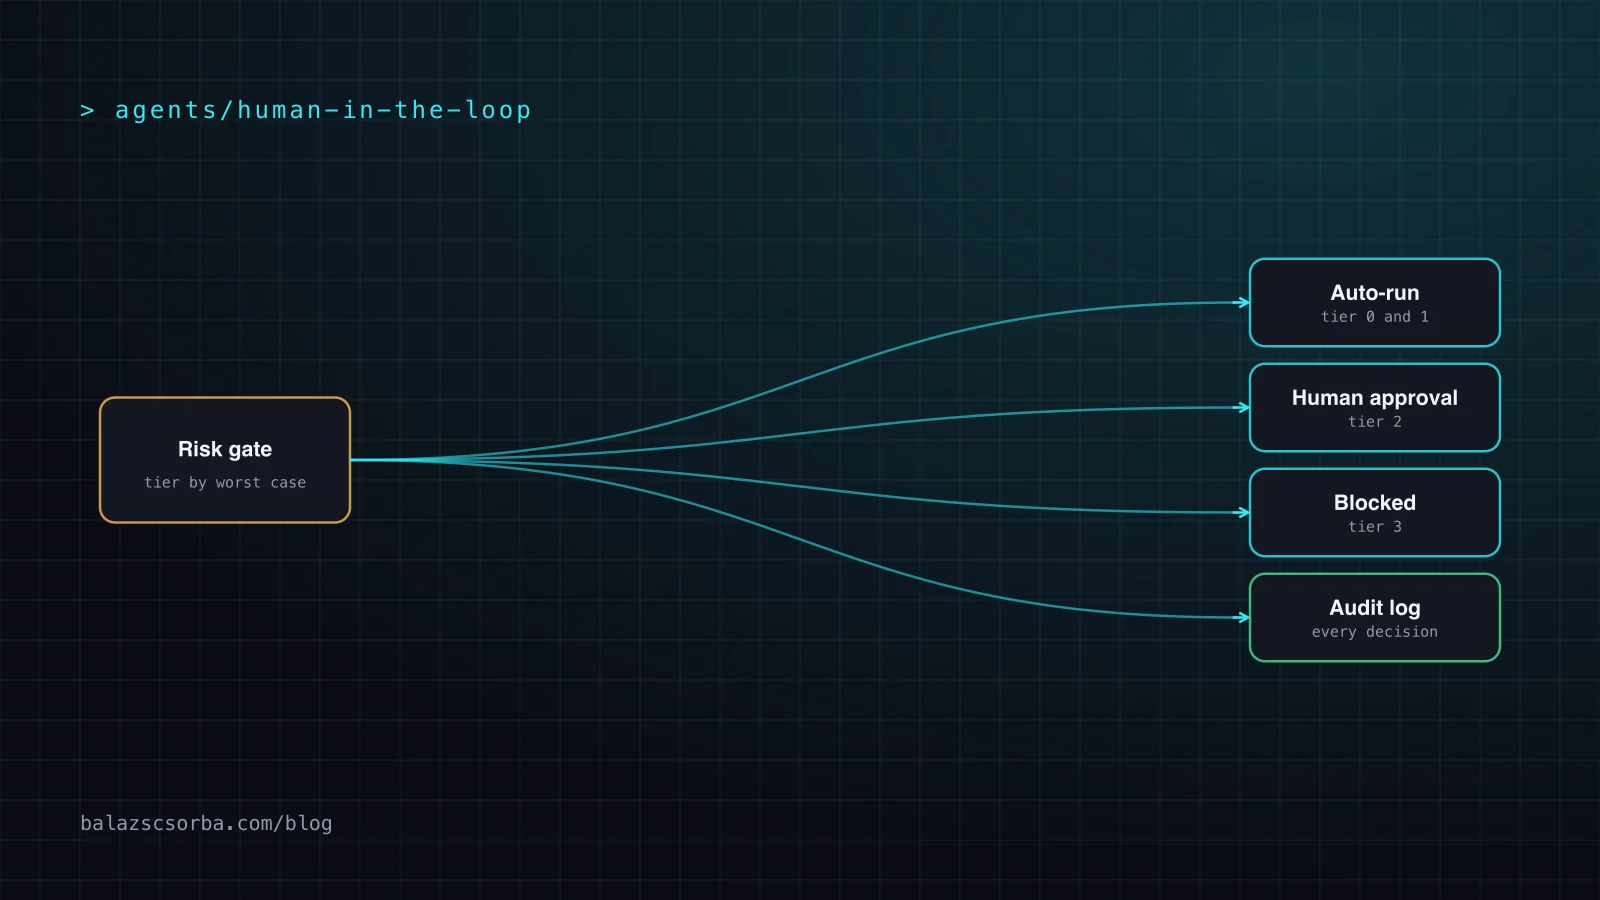
- A műveleteket kockázat szerint kapuzd, ne eszköz szerint: a visszafordíthatóság, a hatókör, az adatok érzékenysége és a láthatóság dönti el, hogy egy művelet lefut, emberhez fordul vagy tiltott.
- A műveletenkénti jóváhagyás nagy volumennél felmondja a szolgálatot. Az Anthropic szerint a Claude Code engedélykéréseinek 93 százalékát jóváhagyják, és egy kísérletben az emberi ellenőrök egy álcázott veszélyes parancsnak csak a 13,6 százalékát vették észre.
- Az interrupt és resume ma már alapprimitív: LangGraph interrupt és Command(resume), needs_approval és RunState az OpenAI Agents SDK-ban, canUseTool és a PreToolUse defer döntés a Claude Agent SDK-ban.
- A jóváhagyás csak akkor ér valamit, ha a pontos műveletre köt, hitelesített személytől jön, naplózott és le tud járni. Minden más puszta rituálé.
- Az always-on ügynökök, például az OpenAI dots, az embert a lánc elejéről a végére teszik, ezért a tervezés a gyakoribb kérdezésről a jobb kérdezésre vált: szabályokkal, ellenőrző modellel és mintavételes auditokkal.
Minden csapat, amely ügynököt ad ki a kezéből, egy héten belül ugyanazzal a kérdéssel találkozik: mikor kell kérdeznie? Ha túl ritkán kérdez, egyetlen rossz eszközhívás letöröl egy táblát, rossz e-mailt küld, vagy rossz ügyfélnek utal vissza pénzt. Ha túl gyakran, az emberek olvasás nélkül kattintanak az „Engedélyezés” gombra, ami rosszabb a kapu hiányánál, mert a rendszer felügyeltnek látszik, miközben nem az.
A „human in the loop” legtöbbször pipa a listán: egy megerősítő ablak a veszélyes eszközök előtt. Ez a tervezés kezdete, nem a vége. Ez a cikk azokat a döntéseket járja végig, amelyek számítanak: hová kerülnek a kapuk, hogyan építs olyan jóváhagyást, amelyet az emberek tényleg elolvasnak, milyen interrupt és resume primitíveket kínálnak ma a fő ügynökframeworkök, mit kell tartalmaznia egy audit nyomvonalnak, és hogyan változtatják meg a képet az always-on ügynökök, mint az OpenAI dots. Ha előbb magát a ciklus működését szeretnéd megérteni, kezdd az ügynökciklus magyarázatával.
Miért csődöt mond a műveletenkénti jóváhagyás nagy léptékben
A kellemetlen bizonyíték azoktól jön, akik az iparág legnagyobb jóváhagyási ablakát üzemeltetik. Az auto módról szóló mérnöki cikkében az Anthropic azt írja, hogy a Claude Code felhasználói az engedélykérések 93 százalékát jóváhagyják, és a következményt jóváhagyási fáradtságnak nevezi: az emberek nem figyelnek oda többé arra, mit hagynak jóvá.
Egy beszámoló szerinti kísérlet élesebbé teszi a lényeget. A DevOps.com szerint az Anthropic 1053 tesztelőnél egy valóban veszélyes parancsot ágyazott az engedélykérések közé: az emberi ellenőrök az esetek 13,6 százalékában vették észre, az automatikus osztályozó 89 százalékban, és több mint 50 korábbi kérés után az emberi találati arány nagyjából 5 százalékra esett. Ez gyártói kísérlet, szándékosan álcázott paranccsal, ezért irányként olvasom, nem állandóként. Az irány ettől még egyértelmű: aki ötven ártalmatlan kérést látott, rossz detektor az ötvenegyedikhez.
Ugyanez a mérnöki cikk őszinte a másik oldalról is. A kétlépcsős osztályozó a valódi, túlbuzgó műveletek 52 elemű kis mintáján még mindig 17 százalékos hamis negatív arányt mutatott, amit az Anthropic az őszinte számnak nevez. Sem az ember, sem a modell nem megbízható egyedüli kapu. A tervezési cél ezért nem az, hogy „egy ember mindent jóváhagy”, hanem az, hogy a szűkös emberi figyelmet oda tedd, ahol megváltoztatja az eredményt, és olyan kontrollokkal támaszd meg, amelyek nem fáradnak el.
Hová tedd a kapukat: kockázat, visszafordíthatóság, hatókör
Az eszköz neve szerint kapuzni („kérdezz a Bash előtt”) túl durva, és túl könnyen felhígul. Én a művelet négy tulajdonsága szerint kapuzok, fontossági sorrendben:
- Visszafordíthatóság. Visszacsinálható-e a hatás olcsón és teljesen? Egy piszkozat, egy branch vagy egy staging táblasor igen. Egy elküldött e-mail, egy kifizetés, egy törölt bucket vagy egy megváltoztatott jogosultság nem.
- Hatókör. Hány rekordot, ügyfelet vagy rendszert érint egyetlen hívás? Az „egy jegy frissítése” és a „minden, a szűrőnek megfelelő jegy frissítése” ugyanaz az eszköz, ezerszer eltérő kockázattal.
- Adatok és láthatóság. Felfed-e személyes, pénzügyi vagy bizalmas adatot, vagy látható-e a szervezeteden kívül?
- Jogosultság. Olyan hitelesítő adatot használ-e, amelyet az ember nem erre a feladatra adott, vagy megváltoztatja-e, ki mit tehet?
Ezekből négy szint lesz. A jobb oldali oszlopok ugyanolyan fontosak, mint a bal oldaliak: egy szint csak akkor valódi, ha megnevezi a kontrollt és a hátrahagyott bizonyítékot.
| Szint | Tipikus műveletek | Kontroll | Bizonyíték |
|---|---|---|---|
| 0: megfigyelés | Olvasás az ügynök hatókörén belül, keresés, összegzés, piszkozat egy ideiglenes területen | Automatikusan fut, minimális jogosultságú olvasás | A hívások naplója |
| 1: visszafordítható módosítás | Commit egy branchre, piszkozat szerkesztése, jegy létrehozása, írás staging tárba | Automatikusan fut visszavonással; ellenőrző modell vagy szabályok fölötte | Napló, plusz az előtte és utána állapot |
| 2: látható vagy költséges | E-mail ügyfélnek, bejegyzés megosztott csatornán, tömeges módosítás limiten belül, költés keret alatt | Emberi jóváhagyás a valódi hatás megmutatásával; a hasonló lépések összevonva | Jóváhagyó, pontos payload, időbélyeg |
| 3: visszafordíthatatlan vagy privilegizált | Fizetések, törlések, éles deploy, jogosultságmódosítás, személyes adatok tömeges exportja | Kemény tiltás vagy kötelező átadás; a legrosszabb esetekben két ember; az ügynök nem csökkentheti a szintet | Jóváhagyó, payload, indoklás, második jóváhagyó |
Két szabály tartja őszintén a mátrixot. Először: az argumentumok legrosszabb esete szerint eszkalálj, ne az eszköz szerint. Egy visszatérítő eszköz a limit feletti összeggel 3. szint, alatta 2. szint. Másodszor: az ügynök sosem osztályozza be a saját műveletét. A szintet determinisztikus szabályok vagy egy, az ügynök elérésén kívüli külön komponens adja. Pontosan ezt a szerkezetet írja le az OpenAI a dotsnál, ahol egy különálló, az ügynök által módosítható környezeten kívüli ellenőrző rendszer dönt arról, hogy egy lépés lefut-e. A Claude Agent SDK engedélysorrendje is így épül fel: hookok, majd tiltó szabályok, majd kérdező szabályok, majd az engedélymód, majd engedélyező szabályok, végül a te callbacked.
Jóváhagyási UX, amely nem tanít igent kattintani
Amikor egy kapu működésbe lép, a felület dönti el, hogy működik-e. Ezeket a tervezési szabályokat alkalmazom, és mind egyetlen gondolatból következnek: az ellenőrnek néhány másodperc alatt meg kell tudnia ítélni a hatást.
- A hatást mutasd, ne a szándékot. Az „Az ügynök a send_email-t akarja futtatni” használhatatlan. Az „E-mail ceo@client.com címre, 340 szó, csatolja a contract.pdf-et, 12 másolatos címzett” ellenőrizhető. Kódnál és adatnál diffet mutass, pénznél összeget, pénznemet és címzettet.
- A veszélyes részt tedd hangossá. Emeld ki a szokatlant: új címzettet, a mediánnál nagyobb összeget, helyettesítő karaktert az útvonalban, külső domaint.
- Vond össze, ami összetartozik. Tíz hasonló 2. szintű lépés egy döntés látható listával, nem tíz ablak. A fáradtság a megszakítások számával nő.
- Ne csak igent vagy nemet kínálj, hanem szerkesztést is. A Claude Agent SDK-ban a callback módosított bemenetet adhat vissza, a LangChain human-in-the-loop middleware-ében pedig az approve és reject mellett van edit döntés. Aki ki tud javítani egy paramétert, nem veti el az egész tervet.
- Az elutasítás vigyen indoklást. A deny üzenet visszamegy a modellnek, amely így igazodhat. A Claude Agent SDK-ban Claude látja az elutasítás üzenetét, az OpenAI Agents SDK-ban hívásonként beállíthatsz elutasítási üzenetet.
- Vigyázz a „mindig engedélyez” opcióval. Az eltárolt döntés a jövőbeli súrlódást és a jövőbeli ellenőrzést is megszünteti. Ha felkínálod, szűken érvényesítsd (ez a parancs, ez az útvonal), járjon le, és az aktív szabályokat listázd ott, ahol az emberek átnézhetik.
- Hiba esetén zárj. Ha senki nem válaszol, a válasz nem. Időtúllépés sosem hagyhat jóvá.
Aztán mérj. A saját ökölszabályom, amely tapasztalaton alapuló heurisztika, nem közzétett küszöb: ha egy kaput az esetek több mint 95 százalékában jóváhagynak, és a döntés mediánja pár másodperc, az színház. Vagy a művelet az 1. szintre való, vagy a kérés nem adja meg, ami az elbíráláshoz kell. Műveletfajtánként kövesd a jóváhagyási arányt, a döntési időt és a később visszavont jóváhagyások arányát. Ugyanaz a figyelemprobléma, amely az ügynökök írta pull requesteket review-szűk keresztmetszetté teszi, és a megoldás is ugyanaz: kevesebb, jobban előkészített döntés.
Interrupt és resume a fő frameworkökben
Technikailag a kapu egy szünet: az ügynök javasol egy műveletet, a futtatókörnyezet megáll, az állapot elmentődik, és egy későbbi hívás döntéssel folytatja. Mindhárom nagy stack kapott már erre első osztályú primitívet. Az API különbözik, a hibamódok hasonlók.
| Framework | Szünet | Folytatás | Perzisztencia és buktatók |
|---|---|---|---|
| LangGraph | Egy node-ban interrupt(payload) hívás; a payloadnak JSON-szerializálhatónak kell lennie | Újrahívás Command(resume=value) értékkel ugyanazon a thread_id-n; az érték az interrupt visszatérési értéke lesz | Checkpointer kell. A node az elejéről indul újra, ezért az interrupt előtti mellékhatásoknak idempotensnek kell lenniük. Az interrupt-ot ne tedd try/except-be. Az illesztés index alapú, tartsd stabilan a hívások sorrendjét |
| LangChain agents | HumanInTheLoopMiddleware eszközönkénti interrupt_on beállítással | Command(resume={"decisions": [...]}) approve, edit, reject (vagy respond) döntésekkel | Checkpointer és thread_id kell; a döntéseknek a szüneteltetett műveletek sorrendjét kell követniük |
| OpenAI Agents SDK | Az eszköz needs_approval-t állít (true vagy az argumentumok async függvénye); a futás függő interruptions listával ér véget | state.approve(item) vagy state.reject(item, rejection_message=...), majd újrafuttatás a RunState-tel | Az állapot to_json és from_json hívással szerializálható. Csak megbízható tárból deszerializálj. Az always_approve tartóssá teszi a döntést |
| Claude Agent SDK | A canUseTool azokra a hívásokra fut le, amelyeket nem döntött el hook, szabály vagy mód; lassú ellenőröknél a PreToolUse hook defer értéket adhat vissza | allow (opcionálisan updatedInput-tal) vagy deny üzenettel; a halasztott hívás --resume-mal folytatódik, és a hook újra lefut | Az automatikusan jóváhagyott eszközök sosem érik el a canUseTool-t; ahol minden hívást látni kell, PreToolUse hookot használj. dontAsk módban a kérdések elutasítássá válnak |
A hivatalos dokumentációból érdemes tudni néhány részletet, mielőtt ráépítesz. A LangGraph interrupts útmutatója figyelmeztet, hogy a folytatott node az elejéről fut újra, így az interrupt előtt elküldött e-mail kétszer menne ki. Az OpenAI Agents SDK útmutatója megmutatja, hogy a needs_approval lehet async függvény, amely hívásonként a paraméterek alapján dönt, és hosszú életű jóváhagyásoknál azt írja: a szerver hitelesítse az ellenőrt, a tárolt futás ellen ellenőrizze a jogosultságot, a döntésazonosítókat a szerver oldali állapottal validálja, és a döntéseket atomikusan alkalmazza a replay megelőzésére. A Claude Agent SDK dokumentációja rögzíti, hogy a callback korlátlanul függőben maradhat, és a defer döntést ajánlja, ha az ember tovább tarthat, mint ameddig a folyamatod életben maradhat.
from langgraph.types import interrupt, Command

def refund_node(state):
    # runs again from the top after resume: keep everything above idempotent
    decision = interrupt({
        "action": "refund", "amount": state["amount"],
        "customer": state["customer_id"], "tier": 3,
    })
    return Command(goto="execute" if decision["approved"] else "cancel")

# later, possibly from another process, same thread_id
graph.stream_events(Command(resume={"approved": True}),
                    config={"configurable": {"thread_id": "case-4711"}}, version="v3")
Bármelyik frameworköt használod, négy tulajdonságot teszek hozzá. Kösd a jóváhagyást a pontos műveletre: a döntés mellé tárold az eszköznév és az argumentumok hash-ét, és végrehajtáskor ellenőrizd újra, hogy a jóváhagyás után megváltozott terv ne legyen fedezve. Hitelesítsd a jóváhagyót a session alapján, soha ne a request body-ból. Járasd le a jóváhagyásokat percek vagy órák után, ne napokéra. Tedd idempotenssé a végrehajtó lépést idempotency kulccsal, mert a resume, a retry és a dupla kattintás mind létezik. Az eszközbiztonság tágabb kérdéseiben az MCP szerver biztonsági ellenőrzőlistám a probléma másik felét fedi le.
Audit nyomvonal és eszkaláció
A nyom nélküli jóváhagyást nem lehet felülvizsgálni, megtámadni vagy tanulni belőle. Minden kapuzott műveletnél kis, unalmas tényhalmazt naplózok: a futás és a szál azonosítóját, a javasolt műveletet teljes argumentumokkal, a szintet és a szabályt, amely hozzárendelte, ki döntött (ember, szabály vagy ellenőrző modell), a döntést és az esetleges módosítást, az időbélyeget és a késleltetést, valamint a végrehajtás eredményét. Az argumentumokat úgy tárold, ahogy az ellenőrnek megmutattad. Ha a felület összefoglalót jelenít meg, azt is őrizd meg, mert a vita gyakran arról szól, mit látott az ember.
Szabályozott területen ez nem opcionális. Az EU AI Act 14. cikke, amely a nagy kockázatú rendszerekre vonatkozik, olyan felügyeletet kér, amellyel a kijelölt személyek megérthetik a rendszer korlátait, tudatában maradhatnak az automation biasnak, dönthetnek úgy, hogy nem használják vagy felülbírálják a kimenetet, és beavatkozhatnak a működésbe vagy leállíthatják a rendszert. Hogy az ügynököd nagy kockázatú-e, a felhasználási esettől függ, ezért ellenőrizd, mielőtt bármelyik irányba feltételezed. Az EU AI Act ellenőrzőlistám fejlesztőknek az átláthatósági oldalt tárgyalja.
Az eszkaláció az a rész, amelyet a csapatok elfelejtenek. Előre döntsd el, kit kérdeznek, mennyi ideje van, és mi történik utána. Egy működő létra: először a kérő felhasználó, aztán egy megnevezett szerep (a folyamat gazdája), aztán a 3. szintnél egy második jóváhagyó, és ha senki nem válaszol, az alapértelmezés az elutasítás. Adj hozzá az ügynöktől független kill switchet: egy jelzőt, amely leállítja az új futásokat és megszakítja a függő jóváhagyásokat. Az értesítéseket olyan csatornán küldd, amelyet az emberek amúgy is figyelnek. A Claude Agent SDK-nak például van PermissionRequest hookja, amelyet arra szántak, hogy Slack- vagy e-mail-értesítést küldjön, amikor az ügynök vár.
Mit változtatnak az always-on ügynökök
Minden eddigi feltételezte, hogy egy ember ül egy chat előtt. Az always-on ügynökök ezt a feltételezést megdöntik. Egy dot vagy egy ütemezett kódoló ügynök órákig dolgozik, akkor is fut, amikor te alszol, és géptempóban termel jóváhagyásokat. Ahogy a dots hatáselemzésben írtam, az ember a lánc elejéről a végére kerül, és a szűk keresztmetszet a figyelem lesz.
Az OpenAI közzétett dots-tervezése hasznos referencia, mert kockázat szerint szintezett kapu. A háttérkutatás csak olvasó eszközökkel fut, egy külön Auto-review rendszer a következményekkel járó lépéseket az utasításaid, a Custom Rules szabályaid és a biztonsági követelmények ellen ellenőrzi, a Custom Rules pedig engedélyezhet, jóváhagyáshoz köthet vagy tilthat műveleteket, de a kötelező alsó határt nem tudja eltávolítani: jelszó megváltoztatása vagy számlák közötti pénzmozgatás mindig visszamegy a személyhez. Ez a 0., 2. és 3. szint egy termékben.
Ebből három következmény adódik a saját tervezésedre. Először: a szabályok kiváltják a kérdések többségét. Egy olyan szabályrendszer, mint „X alatti visszatérítés fut, felette kérdez, bankadatot érintő minden tiltott”, ezernyi kis értékű megszakítást szüntet meg, a megmaradók pedig olvasásra érdemes eseményekké válnak. Másodszor: az ellenőrző modell eszköz, nem orákulum. Skálázódik és nem fárad, de az Anthropic saját számai nullánál nagyobb hibaarányt mutatnak, az OpenAI Auto-review-ja pedig a gyártó modellje, amely a gyártó ügynökét felügyeli. A determinisztikus 3. szintű szabályokat tartsd bármely modellen kívül, az automatikusan jóváhagyott műveletekből pedig vegyél mintát emberi auditra. Harmadszor: a kapuk a műveleteket kontrollálják, nem azt, amit az ügynök olvas. Egy csak olvasó dot is látja a teljes ügyfélrekordot, ezért a minimális jogosultságú kapcsolatok és a maszkolt adatok éppúgy a tervezés részei, mint a jóváhagyások. Ezt a mintát mélyebben a prompt injection és a lethal trifecta cikkben tárgyalom.
Ellenőrzőlista a következő ügynöködhöz
Ezt a listát venném végig, mielőtt írási joggal rendelkező ügynököt engednék valódi adatokra:
- Listázd az összes eszközt és hozzájuk a legrosszabb esetű argumentumokat. Rendelj szintet a visszafordíthatóság, a hatókör, az adatok és a jogosultság alapján.
- A szintdöntést told az ügynökön kívülre: először determinisztikus szabályok, aztán egy ellenőrző modell, soha nem az ügynök saját megítélése.
- A 3. szintet alapból tiltsd, és csak megnevezett átadáson, hitelesített jóváhagyóval engedd.
- A jóváhagyó képernyőt a hatás köré építsd: payload, diff, címzett, összeg, a szokatlan részek kiemelésével.
- Vond össze a hasonló 2. szintű lépéseket, támogasd a szerkesztést a jóváhagyás és az elutasítás mellett, és az elutasítás indokát add vissza az ügynöknek.
- Checkpointerrel vagy szerializált állapottal szüneteltess, a szünet előtti mindent tegyél idempotenssé, és minden jóváhagyást kösd a pontos művelet hash-éhez.
- Időtúllépésnél utasíts el, járasd le a jóváhagyásokat, és tarts egy, az ügynöktől független kill switchet.
- Naplózd, hogy ki, mit, melyik szint, melyik szabály, döntés, módosítások, idő és eredmény, és őrizd meg, amit az ellenőr ténylegesen látott.
- Hetente vegyél mintát az automatikusan jóváhagyott műveletekből emberi felülvizsgálatra, és műveletfajtánként kövesd a jóváhagyási arányt és a döntési időt.
- Minden incidens és minden új eszköz után szintezz újra: a mátrix élő dokumentum.
Ha segítséget szeretnél ennek konkrét architektúrává alakításához az ügynökeidhez, ezt csinálom az AI engineering munkám során.
A nagyobb kép
A human in the loop nem tűnik el, ahogy az ügynökök jobbak lesznek, de az alakja változik. Az alapértelmezés „egy ember minden lépést jóváhagy”-ról „egy ember szabályokat állít, átnézi a kivételeket és auditálja a többit”-re tolódik. Az, hogy a Claude Code-ban az auto mód lesz az alapértelmezett, a dotsnál pedig Auto-review réteg van, két gyártó, amely ugyanabban a szezonban jut ugyanarra a következtetésre.
Ami emberi marad, az a felelősség. Egy osztályozó jóváhagyhat egy műveletet, de nem lehet felelős érte. Úgy tervezz minden kaput, hogy ha valami rosszul sül el, meg tudd válaszolni, ki engedte, milyen információ alapján és melyik szabály szerint.
Források
- LangChain docs: LangGraph interrupts
- LangChain docs: Human-in-the-loop (HumanInTheLoopMiddleware)
- OpenAI Agents SDK (Python): Human in the loop
- Claude Agent SDK: Handle approvals and user input
- Claude Agent SDK: Configure permissions
- Claude Code docs: Hooks (PreToolUse defer, PermissionRequest)
- Anthropic Engineering: Claude Code auto mode
- DevOps.com: Anthropic makes Claude Code auto mode the default
- EU AI Act, Article 14: Human oversight
- OpenAI: How we build safety, security and privacy into dots
Gyakori kérdések
Mit jelent a human in the loop az AI-ügynököknél?
Azt, hogy egy ember meghatározott pontokon beavatkozhat, miközben az ügynök dolgozik: jóváhagyhat vagy módosíthat egy tervezett műveletet, megválaszolhat egy kérdést, vagy leállíthatja a futást. A gyakorlatban ez egy kapu az ügynökciklusban. Az ügynök megáll, megmutatja, mit akar tenni, döntésre vár, majd a döntéssel folytatja.
Mely ügynökműveletekhez kell emberi jóváhagyás?
Azokhoz, amelyeket nehéz visszacsinálni, pénzt, jogosultságot vagy személyes adatot érintenek, elhagyják a szervezetedet, vagy sok rekordot módosítanak egyszerre. Az ügynök hatókörén belüli olvasás és a sandboxban végzett visszafordítható módosítás általában automatikusan futhat, naplózással.
Hogyan kerülhető el a jóváhagyási fáradtság?
Ritkábban kérdezz, de ilyenkor többet mutass. Az alacsony kockázatú műveleteket hagyd jóvá automatikusan, az összetartozó lépéseket vond egy döntésbe, eszköznév helyett a hatást és a diffet mutasd, a veszélyes eseteket szabállyal tiltsd, ne kérdéssel, és auditálj mintát a kérdés nélkül lefutott műveletekből.
Hogyan működik az interrupt és resume a LangGraphban?
Egy node JSON-szerializálható payloaddal hívja az interrupt függvényt. A LangGraph checkpointerrel elmenti az állapotot, és megáll. Ugyanazon a thread_id-n a Command(resume=value) hívással folytatod, és ez az érték lesz az interrupt visszatérési értéke. A node az elejéről indul újra, ezért az interrupt előtti mellékhatásoknak idempotensnek kell lenniük.
Hogyan kezeli az OpenAI és a Claude agent SDK az eszközjóváhagyást?
Az OpenAI Agents SDK-ban az eszköz needs_approval-t deklarál, a futás a függő hívásokat interruptions listaként adja vissza, te pedig egy szerializálható RunState-en jóváhagyod vagy elutasítod őket, majd újra futtatod. A Claude Agent SDK-ban a canUseTool callback minden olyan hívást megkap, amelyet nem döntött el szabály vagy mód, és allow vagy deny választ ad.
Előírja az EU AI Act az AI-ügynökök feletti emberi felügyeletet?
A 14. cikk hatékony emberi felügyeletet ír elő a nagy kockázatú AI-rendszereknél, beleértve az automation bias tudatosítását és a beavatkozás vagy leállítás lehetőségét. Hogy az ügynököd nagy kockázatú-e, a felhasználási esettől függ. Ha nem az, ugyanezek a tervezési elvek akkor is jó alapot adnak.