Blog/Webfejlesztés
Generative Engine Optimization a gyakorlatban: teljes GEO-audit a saját webhelyemen
Mi a Generative Engine Optimization, mit támaszt alá valóban a kutatás, és a webhelyem GEO-auditja: 12 ellenőrzés, 7 javítás, kóddal együtt.
Balázs Csorba··12 perc olvasás
- GEO
- AI search
- Structured data
- nginx
A lényeg röviden
- A Generative Engine Optimization (GEO) azt jelenti, hogy az oldalakat úgy alakítjuk, hogy a MI-alapú válaszmotorok könnyen lekérjék, idézzék és forrásként hivatkozzák őket; a kifejezés Aggarwal és társai 2023-as tanulmányából származik, amelyet a KDD 2024-en mutattak be.
- A tanulmányban az idézetek, a statisztikák és a megnevezett források akár 40 %-kal növelték egy oldal láthatóságát a generált válaszokban, a kulcsszóhalmozás viszont rosszabbul teljesített, mint az optimalizálás teljes hiánya.
- Egy 45 GEO-tanulmányt áttekintő 2026. júliusi összefoglaló szerint ezek a nyereségek csak a már lekért oldalakra érvényesek; egyetlen technika sem mutatott stabil hatást arra, hogy egy oldalt egyáltalán megtaláljanak.
- A Google szerint az AI Overviews és az AI Mode nem igényel külön fájlokat vagy sémát: az oldalnak indexelve kell lennie, és megjelenhessen snippettel, vagyis a SEO alapjai a belépőjegy.
- A webhelyem 105 oldalának auditja 12 ellenőrzést futtatott és 7 javítást hozott, főleg felfedezési linkeket, őszinte dátumokat és egy módot arra, hogy lássam a MI-crawlerek forgalmát; mindegyik kódja lent található.
A Generative Engine Optimization (GEO) az a gyakorlat, hogy a tartalmat úgy alakítjuk, hogy a MI-alapú válaszmotorok, például a Google AI Overviews és AI Mode, a ChatGPT keresés, a Perplexity és a Copilot könnyen megtalálják, lekérjék, idézzék és forrásként hivatkozzák. Ahol a SEO egy linklistában elfoglalt helyre optimalizál, ott a GEO arra, hogy azon kevés forrás egyike legyél, amelyekből egy válasz felépül. A kifejezés egy 2023-as kutatási tanulmányból származik, amelyet a KDD 2024-en mutattak be.
Ennek a bejegyzésnek két fele van: mit támasztanak alá a bizonyítékok, ami kevesebb, mint amit a legtöbb GEO-útmutató állít, és egy teljes GEO-audit erről a webhelyről, amely egy statikus Nuxt build 105 oldallal három nyelven. Az audit 12 ellenőrzést futtatott és 7 javítást hozott; mindegyik kódja lent található, a végén lévő ellenőrzőlista pedig az, amelyet bármelyik webhelyen lefuttatnék.
Mi a Generative Engine Optimization?
Egy generatív keresőmotor nem tíz linket rangsorol. Eldönti, hogy egy kérdéshez kell-e egyáltalán webes keresés, elküld egy vagy több lekérdezést (a Google ezt query fan-outnak hívja), jelölt oldalakat húz elő egy indexből, kiválasztja a modell kontextusába kerülő bekezdéseket, megírja a választ, és megnevezi néhány forrását. Egy oldal ezen lépések bármelyikénél kieshet, és minden lépésnek más karjai vannak.
| SEO | GEO | |
|---|---|---|
| Cél | Előkelő hely egy linklistában | Azon kevés forrás egyike lenni, amelyekből a válasz felépül |
| Egység | Az oldal | Az idézett bekezdés vagy tény |
| Sikermérce | Helyezés, kattintások | Hivatkozások, említések, ajánló látogatások |
| Mérőeszköz | Search Console, analitika | Bing AI Performance, szervernaplók, ismételt promptok |
A GEO nem váltja fel a SEO-t. A Google MI-funkcióinál arra épül: egy nem indexelt oldalra nem lehet hivatkozni.
Mit mutat valójában a kutatás?
Az alapító tanulmány a GEO: Generative Engine Optimization Pranjal Aggarwaltól és kollégáitól a Princetonról és más intézményekből; először 2023 novemberében jelent meg, és a KDD 2024 fogadta el. Megépítették a GEO-bench-et, egy 10 000 lekérdezésből álló benchmarkot, kilenc különböző módszerrel átírták a forrásoldalakat, és megmérték, mennyire lett látható az egyes forrás a generált válaszban.
- Az idézetek, statisztikák és megnevezett források működnek. A legjobb módszerek a pozícióval súlyozott szószámban 41 %-kal, egy szubjektív benyomási pontszámban 28 %-kal múlták felül az optimalizálatlan alapszintet; a főcímbe került szám az „akár 40 %”.
- A kulcsszóhalmozás nem működik. Több keresőkifejezés beszúrása, a klasszikus SEO-fogás, az alapszint alatt teljesített.
- A hátrébb rangsorolt oldalak nyernek a legtöbbet. A forrásmegjelölés 115,1 %-kal növelte a találati lista ötödik helyén álló oldalak láthatóságát, míg az első helyen állók átlagosan 30,3 %-ot veszítettek.
- Élő motoron is működött. A Perplexity.ai-on ugyanezek a módszerek akár 37 %-kal növelték a láthatóságot.
Aztán megérkeztek a fenntartások. Olivier Martinez 45 GEO-tanulmányt áttekintő kritikai összefoglalója (2026. július) amellett érvel, hogy a GEO nem egyetlen rangsorolási feladat, hanem egy zajos folyamat, és hogy az alapító tanulmány eredményei a saját kísérleti keretükben érvényesek, de feltételezik, hogy a forrás már egy rögzített kontextusban van. Az áttekintett munkákban a tematikus relevancia és a kontextusban elfoglalt hely volt a legjobban reprodukálható kar. Az általános átírási heurisztikák rosszul voltak átvihetők, a hivatkozásra célzó átírások akár a lekérést is ronthatták, és egyetlen technika sem mutatott stabil, hosszú távú, platformokon átívelő hatást arra, hogy egy oldalt egyáltalán megtaláljanak.
Tian és kollégái 2026. márciusi tanulmánya a másik oldalról mutat ugyanabba az irányba. Ahelyett, hogy minden oldalra ugyanazt az átírást alkalmaznák, az AgentGEO rendszerük diagnosztizálja, miért nem hivatkoznak egy adott dokumentumra, és pontosan azt javítja. Relatíve több mint 40 %-kal növelte a hivatkozási arányt, miközben a tartalom kb. 5 %-át változtatta meg, és a szerzők azt találták, hogy az általános optimalizálás árthat a hosszú farok tartalmainak.
Mit mond a Google, az OpenAI és a Microsoft?
A platformok saját dokumentációja rövid és egybehangzó.
- A Google szerint nincsenek további követelmények az AI Overviews vagy az AI Mode esetén: az oldalnak indexelve kell lennie, és megjelenhessen snippettel. Nincs szükség új gépileg olvasható fájlokra, MI-szövegfájlokra vagy különleges schema.org markupra; a strukturált adatoknak egyezniük kell a látható szöveggel; és a
nosnippet,data-nosnippet,max-snippetésnoindexszabályozza, mi jelenik meg. Mindkét funkció használhat query fan-outot, és a forgalmuk a Search Console-ban a „Web” keresési típusnál számít. - Az OpenAI az OAI-SearchBotot használja a ChatGPT kereséshez és a GPTBotot a tanításhoz, és a két beállítás független egymástól. Az OAI-SearchBotot letiltó webhelyek nem jelennek meg a ChatGPT keresés válaszaiban, a navigációs linkeket kivéve, és egy robots.txt-módosítás kb. 24 óra alatt lép életbe.
- A Microsoft 2026. február 10-én nyilvános előzetesként beépítette az AI Performance jelentést a Bing Webmaster Toolsba. Ez mutatja az összes hivatkozást a Copilotban és a Bing MI-válaszaiban, a hivatkozott oldalak átlagos számát, a grounding lekérdezéseket, amelyekkel a MI a tartalmat lekérte, és az URL-enkénti hivatkozásokat.
Figyelemre méltó, mit hagy ki a Google: az llms.txt és a Markdown-másolatok nem kellenek ahhoz, hogy megjelenj a MI-funkcióiban. Ezek azokat az ügynököket szolgálják, amelyek közvetlenül töltik le az oldalakat, ez pedig más közönség; az llms.txt és a Markdown content negotiation összevetéséről szóló bejegyzésemben vannak hozzá a naplóadatok. Egy statikus webhelyen keveset kerülnek, ezért megtartom őket, de nem számolok velük rangsorolási karként.
Hogyan futtattam az auditot
Az auditot az éles buildon futtattam, nem a forráskódon: az nuxt generate 105 statikus HTML-oldalt ír (35 oldal angolul, németül és magyarul), egy build utáni lépés pedig mindegyikről Markdown-másolatot és egy /llms.txt fájlt készít. Ezután két kis Node-szkript ment végig a kimeneten.
- Technikai audit minden generált HTML-fájlon: cím és leírás, canonical és hreflang, robots-direktívák, Markdown- és llms.txt-linkek, a JSON-LD gráf (csomóponttípusok és dátumok), oldalanként egy h1, és hogy létezik-e a Markdown-másolat.
- Tartalmi audit a blogadatbázis 24 angol bejegyzésén: meghatározza-e az első mondat a témát, hány forrás és szövegközi hivatkozás van, hány szám, van-e kulcsgondolat-lista és GYIK, és hány h2-címsor kérdés.
// GEO audit over the generated site (excerpt): one pass over every HTML file
for (const file of htmlFiles) {
  const html = readFileSync(file, 'utf8')
  if (!/type="text\/markdown"/.test(html)) add('no rel=alternate text/markdown', page)
  if (!/rel="describedby"/.test(html)) add('no rel=describedby llms.txt', page)
  const robots = html.match(/<meta name="robots" content="([^"]*)"/)?.[1] ?? ''
  if (!robots.includes('max-snippet')) add('robots without max-snippet', page)
  for (const node of jsonLdGraph(html))
    if (/WebPage|CollectionPage|ProfilePage/.test(node['@type']) && !node.dateModified) add('page node without a date', page)
}
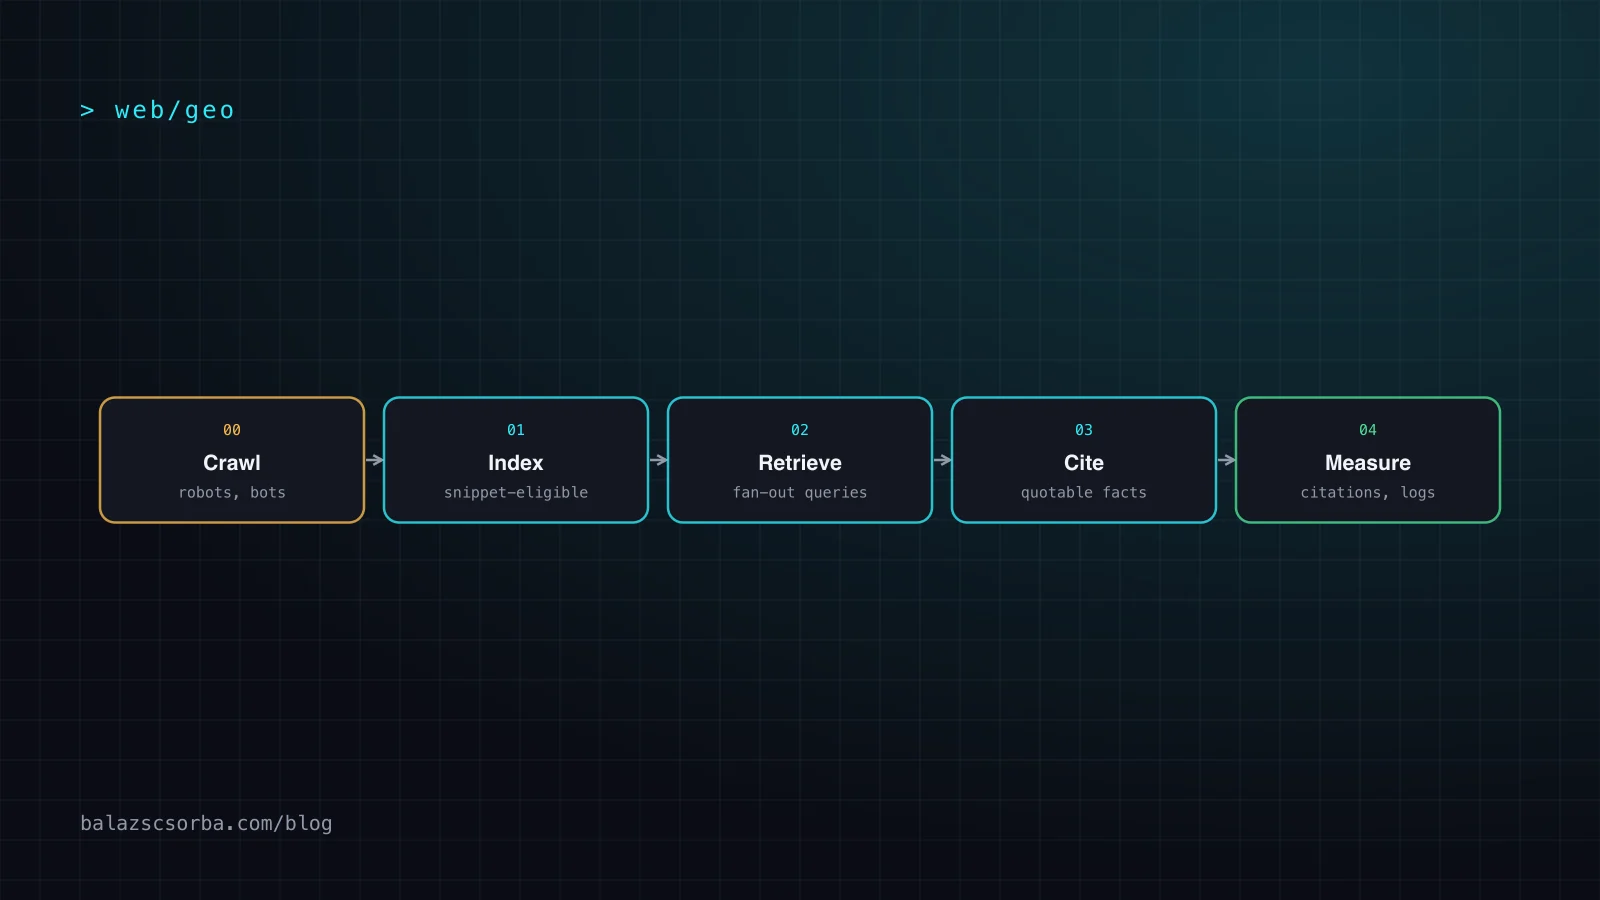
Az ellenőrzések az ábrán látható folyamatot követik: hozzáférés, felfedezhetőség, értelmezés, tartalom és mérés. Az alábbi eredmények ugyanebben a sorrendben következnek.
Mit talált az audit?
| Ellenőrzés | Előtte | Utána |
|---|---|---|
| MI-crawlerek engedélyezve | Rendben: a robots.txt mindenkit enged, és 16 MI-botot név szerint felsorol; a TDMRep engedi a szöveg- és adatbányászatot | Változatlan |
| Snippet-jogosultság | Indexelhető, de 105 oldalból 33 nem adott meg max-snippet direktívát | max-snippet:-1 minden indexelhető oldalon |
| Markdown-másolat oldalanként | Rendben: 105-ből 105 | Változatlan |
Markdown-felfedezés (rel="alternate") | 105-ből 21 oldal; egyetlen blogbejegyzésen és szakterületi oldalon sem volt | Minden oldal, plusz egy HTTP Link fejléc |
llms.txt-felfedezés (rel="describedby") | 105-ből 0; az llms.txt rel="alternate" type="text/plain" linkként szerepelt | Minden oldal, plusz a Link fejléc |
| Entitásgráf (JSON-LD) | Rendben: Person, WebSite, WebPage és BreadcrumbList minden oldalon; BlogPosting, FAQPage, hivatkozások és speakable a bejegyzéseken | Változatlan |
| Dátum az oldalcsomópontokon | 105 WebPage-csomópontból 0-nak volt dátuma | A bejegyzéseken és a blogindexen datePublished és dateModified |
| Sitemap lastmod | Minden statikus oldal a build dátumával volt ellátva | lastmod csak ott, ahol valódi dátum van |
| Idézhető összefoglaló | A kulcsgondolatok speakable jelöléssel, de a sémában nem | abstract a kulcsgondolatokból |
| Válasz az elején | 24 bejegyzésből 21 definícióval kezdődik; 3 egyes szám első személyű építési napló | Maradtak, ahogy vannak |
| Források | Bejegyzésenként 6 forrás a medián; 3 bejegyzés 4-nél kevesebbet hivatkozik | Feljegyezve a következő átdolgozásukhoz |
| MI-crawlerek láthatósága | Semmi: az analitika csak hozzájárulás után töltődik be, a crawlerek pedig nem futtatnak JavaScriptet | Külön nginx-napló a MI-ügynököknek, az Accept fejléccel |
Az audit kb. 30 olyan oldalcímet és leírást is jelzett, amely hosszabb annál, amit a találati lista megjelenít. Ez snippet-higiénia, nem GEO, ezért egy külön körre hagytam. A tartalmi oldal kitartott, mert a bejegyzések kezdettől fogva sablon szerint készültek kulcsgondolatokkal, GYIK-kel és forráslistával; a hiányosságok szinte mind a technikában voltak.
A javítások lépésről lépésre
Minden oldal linkeli a Markdown-másolatát és az llms.txt-t
Az llms.txt 2. verziója arra a kérdésre, hogyan találja meg egy ügynök egy oldal Markdown-változatát, két szabványos linkrelációval felel: rel="alternate" type="text/markdown" a Markdown-másolathoz, és rel="describedby" az oldalt lefedő llms.txt-hez, akár HTML link elemként, akár HTTP Link fejlécként. A webhelyen volt egy plugin az elsőhöz, de csak hét legfelső szintű oldalra. Most minden másolattal rendelkező oldalt lefed, a hibaoldalak kivételével:
// app/plugins/agent-links.ts (excerpt)
const PAGE = /^(\/(about|references|game|accessibility|privacy|imprint|blog)|\/(blog|expertise)\/[a-z0-9-]+)?$/

if (!m || error.value || !PAGE.test(page)) return {}
return {
  link: [
    { key: 'markdown', rel: 'alternate', type: 'text/markdown', href: page ? `${prefix}${page}.md` : `${prefix}/index.md` },
    { key: 'llms-txt', rel: 'describedby', href: '/llms.txt', title: 'llms.txt' },
  ],
}
Ugyanez a pár HTTP fejlécként is kimegy, hogy az a kliens is lássa, amely csak HEAD kérést küld. Egy nginx-részlet második pillantást igényelt: a try_files a fejlécek kiírása előtt /about/index.html-re változtatja a $uri értékét, így egy $uri-ra épülő map a legtöbb oldalnál semmit nem ad. Ha a map a $request_uri-ra épül, ez elkerülhető:
# Keyed on $request_uri: try_files changes $uri to /page/index.html before the headers go out
map $request_uri $bc_agent_links {
  default                                  "";
  "~^/(\?.*)?$"                            '</index.md>; rel="alternate"; type="text/markdown", </llms.txt>; rel="describedby"';
  "~^(?<p>/[a-z0-9/-]*[a-z0-9])(\?.*)?$"   '<$p.md>; rel="alternate"; type="text/markdown", </llms.txt>; rel="describedby"';
}

location / {
  add_header Link $bc_agent_links;   # an empty value sends no header
  # ...
}
Snippet-direktívák és őszinte dátumok
A Google csak akkor használ egy oldalt az AI Overviewsban, ha snippetet mutathat belőle. A snippet alapértelmezés szerint engedélyezett, így a max-snippet:-1 elvben semmit nem változtat, de minden oldalon kimondja a szándékot, és megegyezik azzal, amit a blogbejegyzések már eddig is küldtek.
A dátumok voltak az érdekesebb hiányosság. A sitemap minden statikus oldalnak a build dátumát adta, ami hamis frissességi jel: a Google saját bevallása szerint csak akkor használja a lastmod értéket, ha az következetesen és ellenőrizhetően pontos. A statikus oldalaknak most egyáltalán nincs lastmod értékük, és csak a bejegyzések és a blogindex, amelyeknek valódi dátumuk van, visel datePublished és dateModified mezőt a strukturált adataiban. Jobb a dátum hiánya, mint egy rossz dátum.
Idézhető összefoglaló a strukturált adatokban
Minden bejegyzés öt kulcsgondolattal kezdődik, önmagukban is megálló mondatokként. Ezek már speakable jelölést kaptak, és a bejegyzés forrásai már citation mezőként szerepeltek a sémában. Most a kulcsgondolatok a BlogPosting abstract mezőjébe is bekerülnek, így egy JSON-LD-t olvasó rendszer az oldal feldolgozása nélkül megkapja az összefoglalót:
{
  "@type": "BlogPosting",
  "headline": "Generative engine optimization in practice: …",
  "abstract": "Generative engine optimization (GEO) means … (the five key takeaways)",
  "datePublished": "2026-09-28",
  "dateModified": "2026-09-28",
  "citation": [{ "@type": "CreativeWork", "name": "GEO: Generative Engine Optimization", "url": "https://arxiv.org/abs/2311.09735" }],
  "speakable": { "@type": "SpeakableSpecification", "cssSelector": ["#takeaways"] }
}
Mérni, mit töltenek le a MI-crawlerek
Amit nem látsz, azt nem tudod javítani, és ez a webhely egyáltalán nem látta a MI-crawlereket: a Google Analytics csak a sütihozzájárulás után töltődik be, a crawlerek pedig amúgy sem futtatnak JavaScriptet. A szervernapló az egyetlen őszinte forrás. Az nginx most 16 MI-bot mintájára illeszkedő kéréseket külön naplóba ír, az Accept fejléccel együtt, így látszik, mely oldalakat töltik le, és ki kér Markdownot:
# http context: which requests come from AI crawlers and agents
map $http_user_agent $bc_ai_agent {
  default 0;
  "~*(GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|…)" 1;
}
log_format bc_agents '$time_iso8601 $status $request_method $host$request_uri -> $uri $body_bytes_sent "$http_accept" "$http_user_agent"';

# server block: an access_log here replaces the inherited one, so the default is repeated
access_log /var/log/nginx/access.log;
access_log /var/log/nginx/balazscsorba-agents.log bc_agents if=$bc_ai_agent;
Kezdetnek két parancs elég:
# The pages AI agents fetch most (after negotiation, so /about.md means "asked for Markdown")
awk '{print $6}' /var/log/nginx/balazscsorba-agents.log | sort | uniq -c | sort -rn | head -20
# Requests per agent
grep -oE '(GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User)' \
  /var/log/nginx/balazscsorba-agents.log | sort | uniq -c | sort -rn
A szervernaplók a feltérképezést mutatják, nem a hivatkozást. A hivatkozásokhoz a Bing Webmaster Tools AI Performance jelentése az egyetlen első kézből származó szám; a Search Console a Web összesítésekbe számolja az AI Overviewst és az AI Mode-ot; a chatgpt.com, a perplexity.ai és a copilot.microsoft.com felől érkező ajánlások pedig ugyanúgy megjelennek az analitikában, mint bármely más hivatkozó oldal. Ezen túl az összefoglaló tanácsa érvényes: ugyanazokat a promptokat ismételd meg időről időre, átfogalmazásokkal, mert az egyes válaszok futásról futásra változnak.
Amit szándékosan nem csináltam
- Nincs kulcsszóhalmozás. Az eredeti GEO-tanulmányban rosszabbul teljesített, mint az optimalizálás hiánya.
- Nincs mind a 24 bejegyzésre kiterjedő átírás. Az összefoglaló szerint az általános átírási szabályok rosszul vihetők át, és ronthatják a lekérést. A kevés forrással rendelkező három bejegyzés a következő átdolgozáskor kap többet, az olvasók kedvéért.
- Nincs rejtett szöveg a nyelvi modelleknek. A csak MI-rendszereknek szánt szöveg más néven cloaking, és ugyanazt a trükköt használja, mint a prompt injection. Mindent, amit egy modell elolvashat ezen a webhelyen, egy ember is elolvashat.
- Nincsenek olyan strukturált adatok, amelyek nincsenek az oldalon. A Google a látható szöveggel egyező markupot kér; a sémában lévő GYIK az a GYIK, amelyet látsz.
- Nincsenek kitalált entitásadatok. A Person csomópont csak létező profilokat sorol fel. Több sameAs link is a listámon van, de csak olyan fiókokhoz, amelyeket tényleg használok.
Ellenőrzőlista egy GEO-audithoz
- Engedd be a válaszmotorokat. A robots.txt engedi az OAI-SearchBotot, a Claude-SearchBotot, a PerplexityBotot és a többit, és egyetlen CDN-botszűrő sem írja felül.
- Legyél indexelve és snippetre jogosult. Nincs elkóborolt noindex vagy nosnippet; ellenőrizd a Search Console-ban és a Bing Webmaster Toolsban.
- HTML-ként szolgáld ki a tartalmat. A JavaScriptet nem futtató crawlereknek is látniuk kell a szöveget; a statikus vagy szerveroldali renderelés ezt biztosítja.
- Kezdd a válasszal. Egy oldal első mondata azokkal a szavakkal határozza meg a témáját, amelyekkel valaki keresne rá.
- Fogalmazz konkrétan és forrással. A számok, dátumok, megnevezett források és linkek a GEO azon része, amelyet a kutatás a legjobban alátámaszt.
- Tartsd igaznak a strukturált adatokat. Egyetlen összefüggő entitásgráf, a látható szöveggel egyező markup, és dátumok csak ott, ahol valódiak.
- Kínálj tiszta másolatot. Minden oldal Markdown-változata rel="alternate" linkkel, és egy llms.txt rel="describedby" linkkel.
- Naplózd külön a MI-crawlereket. Szervernapló a user agenttel és az Accept fejléccel, nem kliensoldali analitika.
- Kövesd a hivatkozásokat, ne csak a helyezéseket. Bing AI Performance, Search Console és ajánló forgalom, hetekig figyelve.
- Futtasd újra az auditot minden build után. Az ellenőrzések szkriptek, így egy visszalépés még aznap kiderül.
Ugyanennek a munkának az ügynöki oldalához lásd az llms.txt és a Markdown content negotiation összevetését és a WebMCP egy valódi webhelyen útmutatót. Ha ezt az auditot a saját webhelyeden szeretnéd, keress meg.
Források
- Aggarwal et al.: GEO: Generative Engine Optimization (KDD 2024)
- Martinez: Optimizing Visibility in Generative Engines, a critical survey of GEO 2023–2026 (July 2026)
- Tian et al.: Diagnosing and Repairing Citation Failures in Generative Engine Optimization (March 2026)
- Google Search Central: AI features and your website
- Google Search Central: Build and submit a sitemap
- OpenAI: Overview of OpenAI crawlers
- Bing Webmaster Blog: Introducing AI Performance in Bing Webmaster Tools (10 February 2026)
- llmstxt.org: Changes from v1 to v2
Gyakori kérdések
Mi a Generative Engine Optimization (GEO)?
A Generative Engine Optimization az a gyakorlat, hogy a tartalmat úgy alakítjuk, hogy a MI-alapú válaszmotorok, például a Google AI Overviews és AI Mode, a ChatGPT keresés, a Perplexity és a Copilot könnyen lekérjék, idézzék és forrásként hivatkozzák. A kifejezés Aggarwal és társai tanulmányából származik, amely először 2023 novemberében jelent meg, és a KDD 2024-en mutatták be. Kimutatta, hogy idézetekkel, statisztikákkal és megnevezett forrásokkal egy oldal láthatósága a generált válaszokban akár 40 %-kal nőhet.
Más a GEO, mint a SEO?
A SEO-ra épül, nem váltja fel. A SEO egy linklista elején lévő helyet céloz; a GEO azt, hogy azon kevés forrás egyike legyél, amelyekből egy válasz felépül, így az egység az idézhető bekezdés, nem az oldal. A Google MI-funkcióinál ugyanazok a belépési feltételek, mint a keresésnél: az oldalnak indexelve kell lennie, és megjelenhessen snippettel.
Segít az llms.txt a Generative Engine Optimizationben?
Rangsorolási jelként nem. A Google szerint az AI Overviews és az AI Mode nem igényel MI-szövegfájlokat vagy különleges markupot, és a naplóelemzések szerint a legtöbb llms.txt fájlt soha senki nem kéri le. Az llms.txt és a Markdown-másolatok azoknak az ügynököknek segítenek, amelyek közvetlenül töltik le az oldalakat, ez pedig külön közönség; egy statikus webhelyen olcsó megtartani őket.
Milyen tartalmi változtatások hoznak több MI-hivatkozást?
A legjobban alátámasztottak a konkrét, ellenőrizhető állítások: statisztikák, idézetek és hiteles forrásokra mutató linkek, olyan szövegben, amely egyértelműen illeszkedik a feltett kérdéshez. Az eredeti tanulmányban a kulcsszóhalmozás rosszabbul teljesített, mint az optimalizálás hiánya. Egy 45 tanulmányt áttekintő 2026-os összefoglaló arra figyelmeztet, hogy ezek a nyereségek a már lekért oldalakra vonatkoznak, és az általános átírási szabályok rosszul vihetők át, ezért a saját oldalaidon mérj.
Hogyan mérjem a GEO eredményeit?
Kombinálj három forrást. A Bing Webmaster Tools AI Performance jelentése oldalanként mutatja a hivatkozásokat a Copilotban és a Bing MI-válaszaiban, a mögöttük álló grounding lekérdezésekkel együtt. A szervernaplók megmutatják, mely oldalakat töltik le a MI-crawlerek. A chatgpt.com, a perplexity.ai és hasonló oldalak ajánló forgalma megjelenik az analitikában. A generált válaszok futásról futásra változnak, ezért ugyanazokat a promptokat ismételd meg időről időre, ahelyett hogy egyetlen válaszban bíznál.