Blog/Retrieval és keresés
Text-to-SQL LLM-mel: sémakontextus, csak olvasható szerepkörök és működő validálás
Mennyire pontos valójában a text-to-SQL, hogyan kapjon sémakontextust a modell, és milyen adatbázis- és kódszintű korlátok teszik biztonságossá az SQL-t.
Balázs Csorba··8 perc olvasás
- Text-to-SQL
- LLM security
- PostgreSQL
- Agents
- Analytics
A lényeg röviden
- A legjobb BIRD-rendszerek nagyjából 83%-os végrehajtási pontosságot érnek el a szakértők 93%-ával szemben, a Spider 2.0 ágensalapú vállalati feladatai pedig sokkal nehezebbek.
- A pontosság főleg a sémakontextusból jön: válogatott nézetek, oszlopleírások, mintaértékek, szószedet és ellenőrzött példalekérdezések.
- A biztonságot először az adatbázisban kényszerítsd ki: csak a válogatott nézetekre SELECT-jogú szerepkör, csak olvasható tranzakciók, időkorlátok és sorszintű biztonság.
- Második rétegként validálj kódban: elemezd az SQL-t, egyetlen SELECT utasítást engedj, a táblákat engedélylistán ellenőrizd, és tegyél rá sorlimitet.
- Mutasd meg a felhasználónak a generált SQL-t és az eredménytáblázatot, és a saját kérdéseiden értékelj a végrehajtott eredmények összevetésével.
Minden adatbázissal rendelkező cégnél van valaki, aki hétköznapi nyelven szeretne kérdezni tőle: hány rendelés jött Ausztriából az előző negyedévben, mely ügyfelek hagytak fel a vásárlással, mely cikkek vannak a minimális készlet alatt. Az LLM-ek elfogadható SQL-t írnak, így a demó egy délután alatt elkészül. Az éles üzem tovább tart, mert a nehéz rész nem a generálás, hanem a megfelelő sémakontextus, és annak biztosítása, hogy egy hibás vagy manipulált lekérdezés ne okozhasson kárt.
A cikk azzal kezd, mit mondanak a benchmarkok a pontosságról, majd végigmegy az általam használt architektúrán: válogatott sémakontextus, egy adatbázis-szerepkör, amely csak azt olvashatja, amit kell, validálás kódban, és egy ellenőrző kör a felhasználóval. A példák PostgreSQL-t használnak, de a rétegek bármely SQL-adatbázisra érvényesek.
Mennyire pontos ma a text-to-SQL?
A BIRD a valósághű adatbázisok szabványos benchmarkja: 12 751 kérdés–SQL pár 95 adatbázison, összesen 33,4 GB-on, piszkos értékekkel és külső tudást igénylő kérdésekkel. A ranglista szerint az emberek (adatmérnökök és adatbázis-szakos hallgatók) a tesztkészleten 92,96%-os végrehajtási pontosságot érnek el. A legjobb rendszerek 2026 szeptemberében nagyjából 83%-nál tartanak, és olyan „oracle” tudásbeli segítséget kapnak, amelyet a saját felhasználóid nem fognak megadni.
A Spider 2.0 a vállalati véglet: 632 munkafolyamat-feladat valódi adatbázisokon BigQueryben, Snowflake-ben és máshol, gyakran több mint 1000 oszloppal és 100 sornál hosszabb SQL-lel. A megjelenéskor egy o1-preview alapú kódágens ezek 21,3%-át oldotta meg, szemben az eredeti Spider 91,2%-ával és a BIRD 73,0%-ával. A tanulság nem az, hogy a text-to-SQL kudarc, hanem hogy a pontosság azon múlik, mennyit talál meg a modell a séma jelentéséből.
Hogyan néz ki egy biztonságos text-to-SQL architektúra?
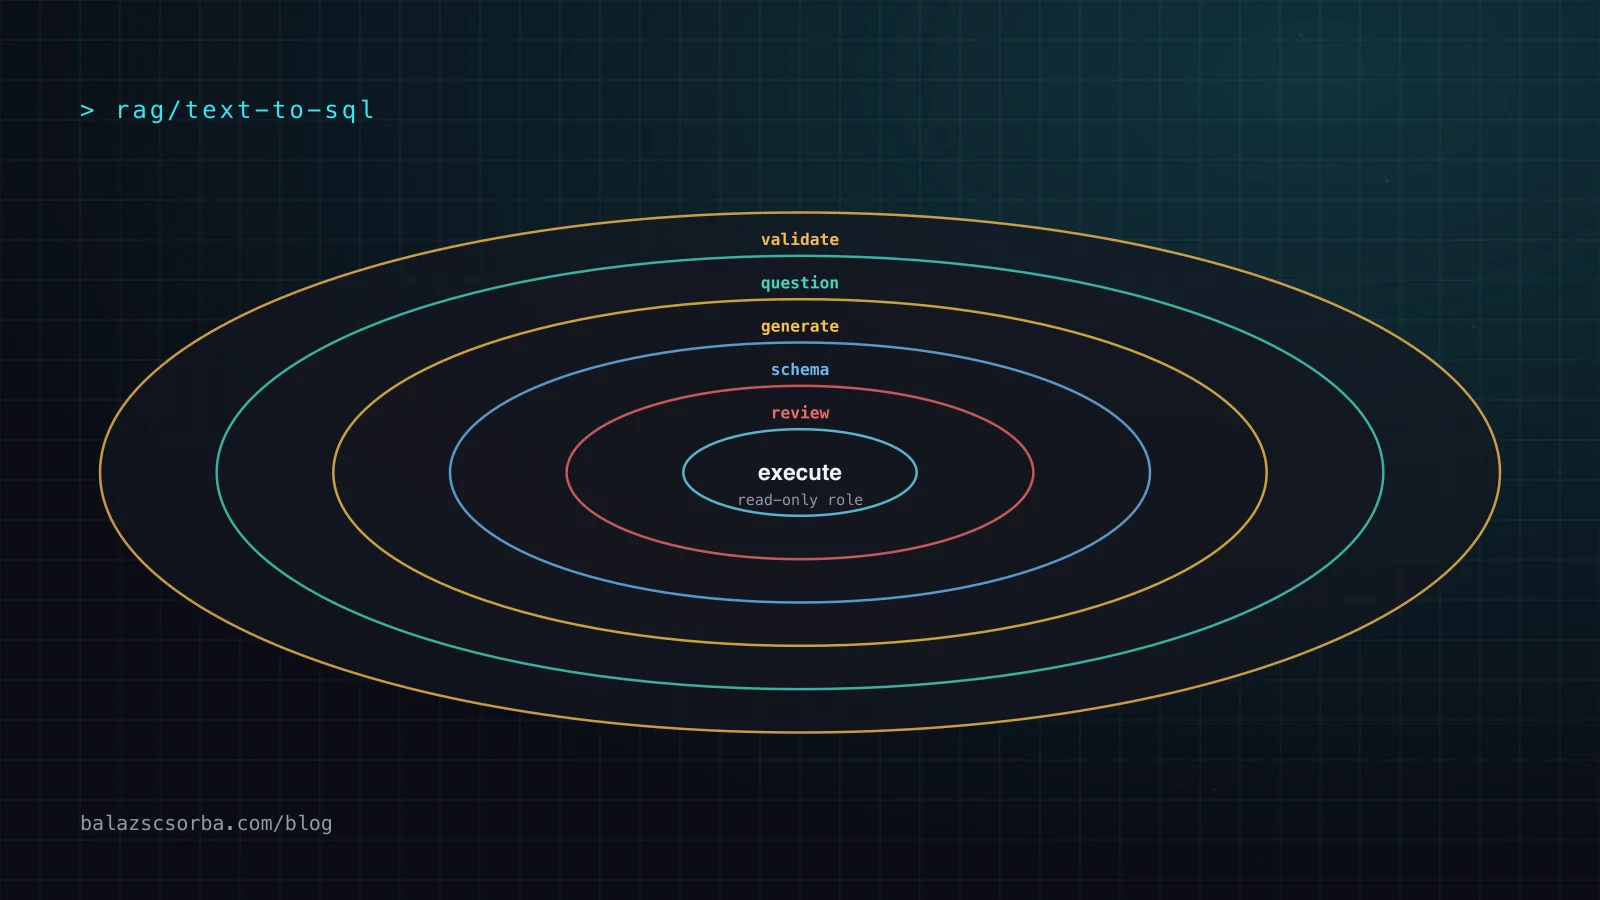
A sorrend számít. Az adatbázisréteg a garancia; a validátor gyors második réteg, amely hasznos hibákat ad a modellnek; a felhasználói ellenőrzés pedig azokat a lekérdezéseket fogja meg, amelyek érvényesek és biztonságosak, mégis rossz kérdésre válaszolnak.
Milyen sémakontextusra van szüksége a modellnek?
A nyers CREATE TABLE utasítások nem elegendők. Az olyan oszlopnevek, mint a kz_status vagy az art_typ, semmit sem mondanak a modellnek, és az új munkatársaknak is keveset. Ami segít, nagyjából hatás szerint sorba rendezve:
- Válogatott nézetek olvasható nevekkel, amelyek összekapcsolják azokat a táblákat, amelyekre ténylegesen kérdeznek, például egy
v_ordersnézet az ügyfél országával és az euróban kifejezett nettó összeggel. - Oszlopleírások mértékegységekkel, kódokkal és jelentésükkel: a 3-as státusz kiszállítottat jelent, az összegek nettók, a dátumok helyi időben vannak.
- Mintaértékek a kevés különböző értékű oszlopokhoz, hogy a modell
country = 'AT'feltételt írjon, necountry = 'Austria'-t. - Üzleti szószedet: ki számít aktív ügyfélnek, mely rendelések számítanak bevételnek, hogyan definiált az üzleti év.
- Ellenőrzött példalekérdezések: valaki által átnézett kérdés–SQL párok, az új kérdéshez való hasonlóság alapján visszakeresve.
Nagy sémánál ne másold az egészet a promptba. Kérdésenként keresd vissza a releváns nézeteket és leírásokat, ugyanúgy, ahogy RAG-nál a dokumentumokat. A folyamatos munka nagy része is a szószedetbe és a példákba megy: minden hibás válaszból, amelyet egy felhasználó jelez, új ellenőrzött példa vagy javított leírás legyen.
Mely korlátok tartoznak az adatbázisba?
Az OWASP a túlzott cselekvési jogkört (excessive agency) az LLM-alkalmazások fő kockázatai közé sorolja, és szinte pontosan ezt az esetet hozza példának: egy ágens, amelynek csak olvasási jog kell egy terméktáblához, ne férjen hozzá más táblákhoz, és ne módosíthasson rekordokat, és ezt az ágens által használt identitás adatbázis-jogosultságaival kell kikényszeríteni. Ez ugyanaz az elv, mint az AI-ágensek is identitások cikkben.
-- A role for the assistant: SELECT on curated views, nothing else
CREATE ROLE sql_assistant LOGIN PASSWORD :'pw' NOSUPERUSER NOCREATEDB NOCREATEROLE;
REVOKE ALL ON SCHEMA public FROM sql_assistant;
GRANT USAGE ON SCHEMA reporting TO sql_assistant;
GRANT SELECT ON reporting.v_orders, reporting.v_customers, reporting.v_stock TO sql_assistant;

-- Every transaction read-only, every statement time-limited
ALTER ROLE sql_assistant SET default_transaction_read_only = on;
ALTER ROLE sql_assistant SET statement_timeout = '5s';
ALTER ROLE sql_assistant SET transaction_timeout = '10s';

-- Row-level security on the base table: each session sees only its tenant
-- (views need security_invoker = true so the policy applies to the caller)
ALTER TABLE orders ENABLE ROW LEVEL SECURITY;
CREATE POLICY tenant_only ON orders FOR SELECT TO sql_assistant
  USING (tenant_id = current_setting('app.tenant_id')::int);
ALTER VIEW reporting.v_orders SET (security_invoker = true);
| Kontroll | Mit akadályoz meg |
|---|---|
| SELECT csak a válogatott nézetekre | Fizetések, jelszó-hashek, más sémák olvasása |
default_transaction_read_only | Írás, még túl tág jogosultság esetén is |
statement_timeout, transaction_timeout | Descartes-szorzatos joinok és elszabadult táblabejárások |
| Sorszintű biztonság | Hogy egy ügyfél vagy bérlő a másik sorait lássa |
| Olvasási replika | Hogy az elemzési terhelés lassítsa a webshopot vagy az ERP-t |
A PostgreSQL sorszintű biztonsági dokumentációjának két részlete könnyen elsikkad: a tábla tulajdonosára a sorszintű szabályok általában nem vonatkoznak, ezért az asszisztens soha ne csatlakozzon tulajdonosként, és ha az RLS be van kapcsolva, de nincs szabály, az alapértelmezés a tiltás.
Hogyan validáld kódban a generált SQL-t?
Az SQL-t valódi parserrel elemezd, ne reguláris kifejezésekkel. A SQLGlot több mint 30 dialektust alakít ellenőrizhető szintaxisfává. Az alábbi ellenőrzések mindent elutasítanak, ami nem egyetlen olvasó lekérdezés engedélyezett nézeteken, és sorlimitet adnak hozzá.
# Illustrative validator with sqlglot (second layer; the database role is the guarantee)
import sqlglot
from sqlglot import exp

ALLOWED = {"v_orders", "v_customers", "v_stock"}
WRITE_NODES = (exp.Insert, exp.Update, exp.Delete, exp.Merge, exp.Create, exp.Drop, exp.Alter, exp.Command)
MAX_ROWS = 1000

def validate(sql: str) -> str:
    statements = sqlglot.parse(sql, read="postgres")
    if len(statements) != 1 or statements[0] is None:
        raise ValueError("exactly one statement is allowed")
    tree = statements[0]
    if not isinstance(tree, exp.Query):
        raise ValueError("only SELECT queries are allowed")
    if any(tree.find_all(*WRITE_NODES)):
        raise ValueError("data-modifying statements are not allowed")
    ctes = {c.alias_or_name for c in tree.find_all(exp.CTE)}
    tables = {t.name for t in tree.find_all(exp.Table)} - ctes
    if unknown := tables - ALLOWED:
        raise ValueError(f"unknown tables: {sorted(unknown)}; allowed: {sorted(ALLOWED)}")
    if not tree.args.get("limit"):
        tree = tree.limit(MAX_ROWS)
    return tree.sql(dialect="postgres")
A hibaüzenetet add vissza a modellnek, és engedj egy-két javítási kísérletet. Az üzenetek a modellnek szólnak: gyakran elég megnevezni az engedélyezett nézeteket, hogy kijavítsa a lekérdezést.
Támadhatják az adatbázisban lévő adatok a modellt?
Igen. Az eredmények visszakerülnek a modell kontextusába, a szöveges oszlopok – termékleírások, ügyfélmegjegyzések, jegyszövegek – pedig bárki által írt utasításokat tartalmazhatnak, aki szerkeszthette őket. Ha ugyanez az ágens e-mailt is küldhet vagy külső API-t is hívhat, a halálos hármas mindhárom eleme megvan: privát adat, nem megbízható tartalom és kifelé vezető út. Az SQL-asszisztens eszközei maradjanak a lekérdezésnél és a megjelenítésnél, a szabad szöveges oszlopokat pedig csak akkor foglalja össze, ha a felhasználó kifejezetten kéri.
Miért lássa a felhasználó a generált SQL-t?
A legveszélyesebb hiba egy lekérdezés, amely hibátlanul lefut, de egy kicsit más kérdésre válaszol: nettó bruttó helyett, rendelési dátum számla dátuma helyett, a lemondott rendelésekkel együtt. Az eredménytáblázat mellett mutasd meg az SQL-t vagy a szűrőinek közérthető összefoglalását, és adj a felhasználónak egykattintásos lehetőséget a hibás válasz jelzésére. Ezek a jelzések táplálják a szószedetet és az ellenőrzött példákat.
Hogyan értékeld a text-to-SQL funkciót?
Használd a végrehajtási pontosságot, a BIRD metrikáját: futtasd le a generált és a referencia-lekérdezést, és az eredményhalmazokat hasonlítsd össze, ne az SQL szövegét. Építs 50–100 kérdést valódi kérésekből, mindegyikhez referencia-lekérdezéssel, és futtasd őket a CI-ban, valahányszor változik a modell, a prompt vagy a sémakontextus, ahogy az LLM-értékelés termékfunkciókhoz cikkben. Tarts meg egy szeletet olyan kérdésekből, amelyeket el kell utasítani, például olyan adatra vonatkozókat, amelyet a szerepkör nem lát, és ellenőrizd, hogy a rendszer ezt mondja-e, ahelyett hogy találgatna.
Mikor ne generálj egyáltalán szabad SQL-t?
Ha a kérdések többsége néhány definiált mutatóra vonatkozik – bevétel, árrés, nyitott rendelések –, akkor egy szemantikai réteg vagy paraméterezett lekérdező eszközök készlete pontosabb, mint a szabad SQL: a modell választja ki a mutatót, a dimenziókat és a szűrőket, a lekérdezést pedig kód építi fel. A szabad SQL a kockázatát a kritikusan olvasni tudó elemzők felfedező kérdéseinél éri meg, nem olyan számoknál, amelyek ellenőrzés nélkül kerülnek egy vezetői jelentésbe.
Források
- BIRD-bench: leaderboard and dataset description
- Lei et al.: Spider 2.0: Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows (2024)
- PostgreSQL 18 Documentation: Row Security Policies
- PostgreSQL 18 Documentation: Client Connection Defaults (read-only and timeouts)
- SQLGlot: SQL parser, transpiler and optimizer (GitHub)
- OWASP Gen AI Security Project: LLM06:2025 Excessive Agency
Gyakori kérdések
Mennyire pontos a text-to-SQL 2026-ban?
A BIRD benchmarkon a legjobb közzétett rendszerek a tesztkészleten nagyjából 83%-os végrehajtási pontosságot érnek el, az adatmérnökök és adatbázis-szakos hallgatók nagyjából 93%-ot. A több mint 1000 oszlopos vállalati adatbázisokat használó Spider 2.0-n egy o1-preview alapú ágens a megjelenéskor a feladatok mindössze 21,3%-át oldotta meg. A saját sémád valahol a kettő között lesz.
Biztonságos LLM-mel SQL-t futtatni éles adatbázison?
Csak adatbázisszintű kontrollok mögött. Csatlakozz egy külön szerepkörrel, amely csak a válogatott nézetekből olvashat, kényszeríts csak olvasható tranzakciókat, állíts be utasítás-időkorlátot, alkalmazz felhasználónkénti vagy bérlőnkénti sorszintű biztonságot, és lehetőleg replikát kérdezz le. A promptba írt utasítás önmagában nem kontroll.
Kell SQL-validálás, ha a szerepkör csak olvasható?
Igen, második rétegként. Az elemzéssel még az adatbázis előtt elutasíthatod a többszörös utasításokat, az ismeretlen táblákat és függvényeket és a drága mintákat, a modell pedig egyértelmű hibaüzenetet kap, amellyel javíthatja a lekérdezést.
Mi az a szemantikai réteg, és kell-e?
A szemantikai réteg az üzleti mutatókat, például a bevételt vagy az aktív ügyfeleket, egyszer, kódban definiálja. Ha a felhasználók főleg definiált mutatókra kérdeznek, a modell ebből a rétegből válasszon mutatót és szűrőt szabad SQL írása helyett; ez pontosabb és következetesebb.
Támadhatják az adatbázisban lévő adatok a modellt?
Igen. A szöveges oszlopok, például a termékleírások vagy a jegyek szövege tartalmazhatnak utasításokat, amelyeket a modell az eredményekben elolvas. A lekérdezési eredményeket kezeld nem megbízható bemenetként, és ugyanannak az ágensnek ne adj olyan eszközt, amely adatot küldhet kifelé.