Blog/LLMOps & Evals
LLM-Modellmigration ohne Regressionen: Deprecations, Evals, Shadow-Traffic
Ein Playbook für den Wechsel von LLM-Modellen: Deprecation-Fristen, Vertragsfixes, Regression-Suite, Prompt-Tuning, Shadow-Traffic und Canary.
Balázs Csorba··10 Min. Lesezeit
- Model migration
- Regression testing
- Deprecations
- LLM evals
- Canary releases
Das Wichtigste in Kürze
- Anbieter nehmen Modelle planmäßig außer Betrieb: OpenAI gibt GA-Modellen mindestens sechs Monate, Anthropic mindestens 60 Tage, Gemini-Previews teils nur zwei Wochen.
- Ein Modellwechsel ändert drei Dinge: den API-Vertrag, das Verhalten auf deinen Prompts sowie Token-Zahlen und Kosten; prüfe jedes getrennt.
- Exakte Modell-IDs pinnen, pro Anwendungsfall zentralisieren und die echte Nutzung aus Anbieter-Exporten und Gateway-Logs erfassen, bevor du testest.
- Altes und neues Modell Seite an Seite auf einem Golden Set aus der Produktion laufen lassen, Gates auf Erfolg, Parse-Fehler, Verweigerungen, Länge, Kosten und Latenz setzen und jede Niederlage lesen.
- Über Shadow-Traffic und einen Canary hinter einem Flag ausrollen, Prompt und Modell gemeinsam versionieren und die Suite danach wöchentlich laufen lassen.
Jedes LLM-Feature, das du auslieferst, hat ein Ablaufdatum, das du nicht gewählt hast. Anbieter nehmen Modelle planmäßig außer Betrieb, und der Nachfolger ist nie ein reiner Austausch: Request-Parameter werden abgelehnt, auf das alte Modell abgestimmte Prompts verhalten sich anders, und der Tokenizer zählt deine Eingaben womöglich anders. Wenn Claude Sonnet 4.5 in deinem Stack steckt, läuft die Uhr gerade sichtbar: Anthropic hat es am 30. September 2026 als veraltet markiert und nimmt es am 30. November 2026 außer Betrieb; empfohlener Nachfolger ist Claude Sonnet 5.5.
Dieser Artikel ist ein Migrations-Playbook: wie Deprecation-Zeitpläne bei OpenAI, Anthropic und Google funktionieren, wie du jede Aufrufstelle findest, was eine Regression-Suite für einen Modellwechsel messen sollte und wie du das neue Modell mit Shadow-Traffic und Canary ausrollst statt mit einem Big-Bang-Wechsel.
Warum ein Modellwechsel Dinge kaputt macht
Beim Wechsel auf ein neues Modell ändern sich drei verschiedene Dinge, und jedes braucht eine eigene Prüfung:
- Der API-Vertrag. Parameter, die beim alten Modell funktionierten, liefern beim neuen ein 400. Der Migrationsleitfaden für Claude Opus 5.5 nennt mehrere: Thinking deaktivieren, Thinking-Budgets, erzwungene Tool-Wahl, nicht standardmäßige Sampling-Parameter und Assistant-Prefills werden alle abgelehnt.
- Verhalten. Derselbe Prompt erzeugt andere Ausgaben. Sclar et al. maßen Genauigkeitsunterschiede von bis zu 76 Punkten allein durch bedeutungserhaltende Formatänderungen und fanden, dass das beste Format zwischen Modellen nur schwach korreliert. Ein für Modell A optimierter Prompt ist nicht für Modell B optimiert.
- Kosten und Limits. Anthropics Leitfaden weist darauf hin, dass der mit Opus 4.7 eingeführte Tokenizer für denselben Text etwa das 1- bis 1,35-Fache an Tokens früherer Modelle verbrauchen kann. Dein
max_tokens, Compaction-Schwellen und Kostenschätzungen verschieben sich mit.
Es gibt noch einen vierten Fall, der gar keine Migration ist: Derselbe Modellname ändert sein Verhalten. Chen, Zaharia und Zou verglichen die Versionen von GPT-4 aus März und Juni 2023 und stellten fest, dass die Genauigkeit beim Erkennen von Primzahlen von 84 % auf 51 % fiel, dazu kamen mehr Formatierungsfehler in generiertem Code. Ihr Fazit, dass sich das Verhalten desselben LLM-Dienstes in kurzer Zeit erheblich ändern kann, ist das Argument dafür, die Regression-Suite regelmäßig laufen zu lassen, nicht nur beim Wechsel.
Deprecation-Zeitpläne bei OpenAI, Anthropic und Google
Wie viel Vorwarnung du bekommst, hängt vom Anbieter und von der Art des Modells ab. Laut der jeweiligen Dokumentation:
| Anbieter | Mindestvorlauf vor der Abschaltung | Wie du es überwachst |
|---|---|---|
| tagchildren | Mindestens 6 Monate für allgemein verfügbare Modelle, 3 Monate für spezialisierte Varianten (Chat, Codex, Deep Research), bei Preview-Modellen teils nur 2 Wochen | GET /v1/models liefert pro Modell ein optionales shutdown_date |
| tagchildren | Mindestens 60 Tage für öffentlich veröffentlichte Modelle; Kunden mit aktiven Deployments werden benachrichtigt | Deprecation-Seite mit voraussichtlichen Abschaltdaten; Usage-Export in der Console nach API-Key und Modell |
| tagchildren | Preview-Modelle werden mit mindestens 2 Wochen Vorlauf abgekündigt; der -latest-Alias wird ausgetauscht, bei Breaking Changes mit 2 Wochen Vorlauf per E-Mail | Stabile Modellnamen "ändern sich normalerweise nicht"; Deprecation-Seite |
Zwei praktische Folgen. Setze nie ein Preview-Modell oder einen -latest-Alias hinter ein geschäftskritisches Feature: OpenAIs Doku rät ausdrücklich von Preview-Modellen für solche Workloads ab, sofern du nicht kurzfristig migrieren kannst. Und trag das Abschaltdatum jedes genutzten Modells am Tag der Einführung in einen Kalender ein. Anthropic gibt voraussichtliche Daten derzeit als "nicht früher als" an, das ist eine Untergrenze, kein Versprechen.
Modell-IDs pinnen und wissen, wo sie genutzt werden
Eine Migration, deren Umfang du nicht kennst, kannst du nicht abschließen. Vor jedem Test:
- Exakte Modellbezeichner in Produktion pinnen. Stabile Namen bei Gemini, exakte IDs bei Claude und OpenAI. Ein Alias bewegt sich ohne Deploy, das Verhalten kann sich also ohne Commit ändern.
- Die Modell-ID zentral in der Konfiguration halten, ein Eintrag pro Anwendungsfall ("order-extraction", "support-triage"), kein String-Literal pro Aufrufstelle. Ein Gateway wie LiteLLM oder OpenRouter macht daraus eine Routing-Regel.
- Die tatsächliche Nutzung inventarisieren. Die Codesuche findet die Aufrufstellen, die du kennst. Anthropics Usage-Export in der Console (CSV nach API-Key und Modell) und deine Gateway-Logs finden die vergessenen: den Cronjob, das interne Tool, den Prototyp, der Produktion wurde.
- Die Request-Einstellungen pro Anwendungsfall festhalten: Max Tokens, Thinking- oder Effort-Einstellungen, Tool-Wahl, Schema für Structured Outputs, Sampling-Parameter. Genau diese kann das neue Modell ablehnen.
Die Migrationspipeline
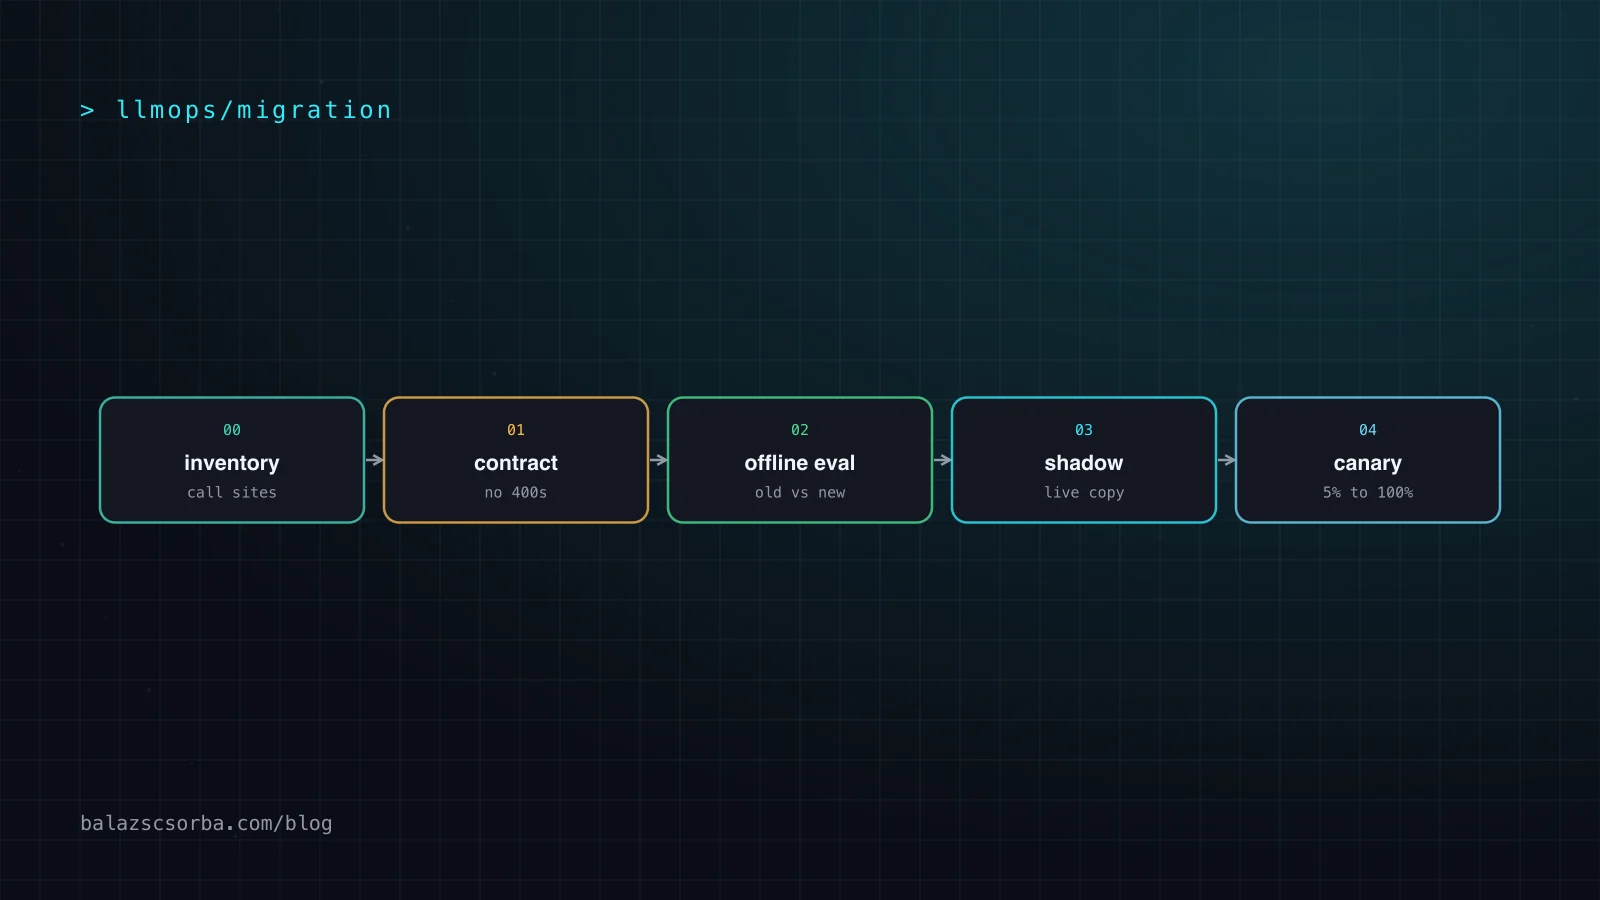
Ich schicke jeden Modellwechsel durch dieselben fünf Stufen. Jede Stufe hat ein Ausstiegskriterium, und jeder Fehler schickt dich einen Schritt zurück, nicht mit einem Fix in Produktion weiter.
Stufe 2: erst den Vertrag reparieren, dann Verhalten testen
Vertragsänderungen sind deterministisch, also behandle sie zuerst und getrennt. Lies den Migrationsleitfaden des Anbieters für dein genaues Quell- und Zielmodell. Als konkretes Beispiel einige der Änderungen, die der Leitfaden für Claude Opus 5.5 für Code von älteren Modellen nennt:
| Alte Einstellung | Bei Claude Opus 5.5 | Lösung |
|---|---|---|
thinking: {type: "disabled"} oder ein budget_tokens-Budget | 400-Fehler | Feld entfernen; Effort-Stufe wählen (Standard ist medium) |
tool_choice any oder ein benanntes Tool | 400-Fehler | auto plus Anweisungen oder Structured Outputs nutzen |
temperature, top_p, top_k mit Nicht-Standardwerten | 400-Fehler | Weglassen; über den Prompt steuern |
| Assistant-Prefill, um ein Format zu erzwingen | 400-Fehler | Structured Outputs oder Anweisungen im System-Prompt |
max_tokens für einen älteren Tokenizer bemessen | Bis zu etwa 35 % mehr Tokens für denselben Text gegenüber Modellen vor Opus 4.7 | Mit Token Counting neu messen; Reserve einplanen |
Das Ausstiegskriterium dieser Stufe ist einfach: Jede im Inventar erfasste Request-Form läuft gegen das neue Modell ohne Fehler durch. Anthropic bietet außerdem einen Skill /claude-api migrate für Claude Code, der den Modell-ID-Wechsel und die Breaking-Parameter-Änderungen in einer Codebasis anwendet und eine Checkliste für die manuelle Prüfung erzeugt. Solche Tools beschleunigen Stufe 2; Stufe 3 ersetzen sie nicht.
Stufe 3: die Regression-Suite für einen Modellwechsel
Anthropics Eval-Leitfaden beschreibt Regression-Evals als diejenigen, die nahe 100 % liegen und Rückschritte erkennen sollen. Für einen Modellwechsel lässt diese Suite beide Modelle auf denselben Eingaben laufen und vergleicht. Baue sie aus der Produktion, nicht aus der Vorstellung: echte Anfragen pro Anwendungsfall ziehen, jeden vergangenen Vorfall ergänzen und das erwartete Ergebnis oder eine Referenzantwort daneben ablegen. Und miss mehr als Genauigkeit:
| Metrik | Warum sie sich beim Modellwechsel bewegt | Beispiel-Gate (meine Standardwerte) |
|---|---|---|
| Task-Erfolg auf dem Golden Set | Verhaltensänderung | Kein Rückgang über das Rauschen hinaus; jeder alte Vorfall besteht weiter |
| Schema- und Parse-Fehler | Formatierungsgewohnheiten unterscheiden sich zwischen Modellen | Null, mit eingeschalteten Structured Outputs |
| Verweigerungs- und Enthaltungsrate | Modelle sind unterschiedlich vorsichtig | Wenige Punkte um das alte Modell; jede neue Verweigerung lesen |
| Ausgabelänge | Geänderte Ausführlichkeit bricht UIs und SMS-Limits | Median innerhalb von ±20 % |
| Tokens und Kosten pro erledigtem Task | Tokenizer, Ausführlichkeit, Thinking | Vor dem Rollout bekannt und akzeptiert |
| Latenz p50 und p95 | Thinking-Standards, Modellgröße | Innerhalb des Latenzbudgets des Features |
Bewerte offene Ausgaben paarweise: Zeig einem Judge die alte und die neue Antwort auf dieselbe Eingabe in zufälliger Reihenfolge und frag, welche die Rubrik besser erfüllt. Paarvergleiche sind für die Frage "ist es so gut wie vorher" stabiler als absolute Scores und bringen die lesenswerten Fälle nach oben. Der Harness selbst ist klein:
import random, statistics

def compare(cases, old_model, new_model, run, judge, checks):
    """run(model, case) -> Result(text, tokens, ms, refused); judge(case, a, b) -> 'a'|'b'|'tie'"""
    rows = []
    for case in cases:
        old, new = run(old_model, case), run(new_model, case)
        flip = random.random() < 0.5                      # hide which answer is new
        verdict = judge(case, *( (new.text, old.text) if flip else (old.text, new.text) ))
        new_wins = (verdict == "a") == flip if verdict != "tie" else None
        rows.append({
            "id": case.id,
            "checks_failed": [c.name for c in checks if not c(case, new)],   # schema, refs, rules
            "new_wins": new_wins,
            "refused": (old.refused, new.refused),
            "len_ratio": len(new.text) / max(1, len(old.text)),
            "token_ratio": new.tokens / max(1, old.tokens),
            "ms": (old.ms, new.ms),
        })
    losses = [r for r in rows if r["new_wins"] is False or r["checks_failed"]]
    print("losses to read:", [r["id"] for r in losses])
    print("median length ratio:", statistics.median(r["len_ratio"] for r in rows))
    return rows
Führe jeden Fall mehr als einmal aus, wenn das Feature agentisch oder gesampelt ist; ein Lauf pro Modell verdeckt die Varianz. Und betrachte die Liste der Niederlagen als eigentliches Ergebnis der Stufe: Die Entscheidung weiterzugehen fällt beim Lesen dieser Fälle, nicht anhand eines einzelnen aggregierten Scores. Promptfoo und ähnliche Tools können denselben Seite-an-Seite-Vergleich per Konfiguration ausführen, wenn du keinen Harness pflegen willst; die Methode beschreibt LLM-Evals für Produktfeatures ausführlicher.
Prompts, Effort und alte Workarounds neu abstimmen
Wenn die Suite Niederlagen zeigt, widerstehe dem Reflex, Anweisungen auf den alten Prompt zu stapeln. Prompts sammeln Workarounds für die Eigenheiten des Vorgängermodells ("nie Aufzählungspunkte verwenden", "das Feld IMMER zurückgeben, auch wenn leer"), und ein neueres Modell befolgt sie womöglich zu wörtlich. Das passt zum Befund von Sclar et al., dass sich Vorlieben für Prompt-Formate schlecht zwischen Modellen übertragen. Meine Reihenfolge:
- Zuerst Workarounds entfernen und neu laufen lassen. Viele Niederlagen verschwinden.
- Die Reasoning-Einstellung neu abstimmen. Bei Claude ersetzt Effort die Thinking-Budgets, und die Standardwerte unterscheiden sich zwischen Modellen (medium bei Opus 5.5). Probiere low, medium und high auf der Suite und wähle pro Anwendungsfall.
- Format-Überredung durch Structured Outputs ersetzen, wo der Anbieter sie unterstützt.
- Erst dann neue Anweisungen ergänzen, einzeln, jeweils gebunden an einen scheiternden Fall.
Stufe 4 und 5: Shadow-Traffic und Canary
Offline-Suites enthalten nur die Fälle, an die du gedacht hast. Shadow-Traffic schickt eine Kopie der Live-Anfragen an das neue Modell, loggt dessen Antwort neben der ausgelieferten und zeigt sie Nutzern nie. Lass das einige Tage über das wöchentliche Traffic-Muster laufen und wende dann dieselben Prüfungen wie in Stufe 3 auf die Shadow-Paare an. Zwei Vorsichtsmaßnahmen: Shadow-Aufrufe kosten Geld, also bei hohem Volumen sampeln; und lass den Shadow-Pfad nie Seiteneffekte ausführen. Bei Agenten nur den lesenden Teil spiegeln oder Tools auf eine Sandbox zeigen lassen.
Der Canary liefert das neue Modell dann hinter einem Feature-Flag an einen kleinen Teil des Traffics aus, mit denselben Dashboards wie für das alte Modell: Fehlerrate, Verweigerungsrate, Nutzerfeedback, Kosten pro Task und Latenz. Erweitere schrittweise (5 %, 25 %, 100 %) mit festem Beobachtungsfenster pro Schritt und halte die alte Konfiguration bis zum Abschaltdatum deploybar, damit ein Rollback ein Flag-Umschalten ist und kein Release. Tracing mit OpenTelemetry macht den Vergleich pro Modell zu einer Abfrage statt zu einem Projekt.
Die Suite nach der Migration weiterlaufen lassen
Die Regression-Suite ist teuer im Aufbau und günstig im Betrieb. Lass sie wöchentlich gegen die Produktionskonfiguration laufen und bei jeder Prompt- oder Modelländerung. So erkennst du Drift hinter einem stabilen Namen (der Fall von Chen et al.), hast eine Baseline, wenn die nächste Deprecation-Mitteilung kommt, und machst aus "sollen wir auf das neue, günstigere Modell wechseln?" eine Messung. Dieselbe Suite macht Modell-Routing für Kosten sicher: Ein günstigeres Modell ist nur dann günstiger, wenn es besteht.
Leaderboards helfen bei der Auswahl von Kandidaten, wie ich es zum aktuellen Ranking von Artificial Analysis beschrieben habe, aber sie sagen dir nicht, ob dein Extraktions-Prompt das Lieferdatum noch findet. Das kann nur deine Suite.
Migrations-Checkliste
- Das Abschaltdatum jedes genutzten Modells in den Kalender eintragen; Preview-Modelle und -latest-Aliase in Produktion vermeiden.
- Exakte Modell-IDs pinnen, pro Anwendungsfall zentralisieren und die echte Nutzung aus Anbieter-Exporten und Gateway-Logs inventarisieren.
- Den Migrationsleitfaden für dein genaues Quell- und Zielmodell lesen; zuerst jeden abgelehnten Parameter reparieren.
- Token-Zahlen neu messen und max_tokens, Budgets und Compaction-Schwellen anpassen.
- Altes und neues Modell Seite an Seite auf einem Golden Set aus Produktion und vergangenen Vorfällen laufen lassen.
- Gates auf Erfolg, Parse-Fehler, Verweigerungen, Länge, Kosten pro Task und Latenz setzen und jede Niederlage lesen.
- Alte Prompt-Workarounds entfernen, bevor neue Anweisungen dazukommen; Effort pro Anwendungsfall neu abstimmen.
- Live-Traffic ohne Seiteneffekte spiegeln, dann Canary hinter einem Flag mit Rollback bis zum Abschaltdatum.
- Die Suite nach der Migration wöchentlich weiterlaufen lassen.
Wenn bei dir ein Abschaltdatum näher rückt und du Unterstützung bei der Migration willst, siehe AI Engineering.
Quellen
- Claude API docs: Model deprecations
- OpenAI API docs: Deprecations
- Gemini API docs: Models and version name patterns
- Claude API docs: Claude Opus 5.5 migration guide
- Chen, Zaharia, Zou: How is ChatGPT's behavior changing over time? (2023)
- Sclar et al.: Quantifying Language Models' Sensitivity to Spurious Features in Prompt Design (2023)
- Anthropic: Demystifying evals for AI agents (Jan 2026)
Häufige Fragen
Wie viel Vorlauf geben LLM-Anbieter vor der Abschaltung eines Modells?
OpenAI dokumentiert mindestens sechs Monate für allgemein verfügbare Modelle, drei Monate für spezialisierte Varianten und unter Umständen zwei Wochen für Preview-Modelle. Anthropic gibt mindestens 60 Tage für öffentlich veröffentlichte Modelle. Google kündigt Gemini-Preview-Modelle mit mindestens zwei Wochen Vorlauf ab und tauscht das Modell hinter -latest-Aliasen aus.
Kann ich einfach die Modell-ID ändern und neu deployen?
Selten. Neuere Modelle können Parameter ablehnen, die das alte akzeptierte, etwa deaktiviertes Thinking, erzwungene Tool-Wahl oder Prefills bei Claude Opus 5.5; auf ein Modell abgestimmte Prompts verhalten sich auf einem anderen anders, und Token-Zahlen können sich ändern. Erst den Vertrag reparieren, dann vor dem Rollout eine Regression-Suite laufen lassen.
Was sollte eine Regression-Suite für eine LLM-Migration messen?
Task-Erfolg auf einem Golden Set aus Produktions-Traffic und vergangenen Vorfällen, Schema- und Parse-Fehler, Verweigerungsrate, Ausgabelänge, Tokens und Kosten pro erledigtem Task sowie Latenz. Vergleiche altes und neues Modell auf denselben Eingaben und lies jeden Fall, in dem das neue Modell verliert.
Was ist Shadow-Testing bei LLMs?
Shadow-Testing schickt eine Kopie der Live-Anfragen an das neue Modell und loggt dessen Antworten neben den ausgelieferten, ohne sie Nutzern zu zeigen. So findest du Fälle, die deiner Offline-Suite fehlen. Stelle sicher, dass der Shadow-Pfad keine Seiteneffekte auslösen kann, besonders bei Agenten mit schreibenden Tools.
Warum schneiden meine Prompts auf einem neueren, besseren Modell schlechter ab?
Prompts sammeln Workarounds für die Eigenheiten des alten Modells, und Forschung zeigt, dass das beste Prompt-Format zwischen Modellen nur schwach korreliert. Entferne zuerst alte Workarounds, stimme Reasoning- oder Effort-Einstellungen neu ab, nutze Structured Outputs statt Format-Überredung und ergänze erst dann neue Anweisungen, gebunden an scheiternde Fälle.