Blog/Retrieval & Suche
Mehrsprachiges RAG für Deutsch und Ungarisch: Embeddings, Komposita und sprachübergreifende Suche
RAG über deutsche und ungarische Inhalte: mehrsprachige Embeddings, Komposita, Stemming, Akzente und Evaluation pro Sprache.
Balázs Csorba··7 Min. Lesezeit
- RAG
- Multilingual
- Embeddings
- German
- Hungarian
Das Wichtigste in Kürze
- Ein mehrsprachiges Embedding-Modell lässt eine deutsche Frage einen ungarischen oder englischen Abschnitt finden, die Keyword-Suche braucht aber weiterhin Analyse pro Sprache.
- Deutsche Komposita und ungarische Suffixe brechen naives BM25: Zerlegung von Komposita fürs Deutsche, ein Snowball-Stemmer fürs Ungarische.
- Nutzer tippen Ungarisch und Deutsch ohne Akzente und Umlaute; im Keyword-Index Diakritika falten und zusätzlich den Originaltext speichern.
- Die Sprache jedes Chunks speichern und bewusst entscheiden, ob man bei der Abfrage nach Sprache filtert, gewichtet oder mischt.
- Leaderboards mitteln über viele Sprachen; vor der Modellwahl ein kleines Eval-Set pro Sprache und ein sprachübergreifendes bauen.
Die meisten RAG-Tutorials setzen englische Dokumente und englische Fragen voraus. Projekte in Österreich, Deutschland und Ungarn sehen selten so aus: Produktdaten auf Deutsch, Support-Tickets auf Ungarisch, Handbücher auf Englisch, und Nutzer, die in der Sprache fragen, in der sie gerade denken, oft ohne Umlaute oder Akzente. Ein Retrieval, das in der Demo funktioniert, verliert still die Hälfte der relevanten Abschnitte.
Dieser Artikel behandelt die Entscheidungen, die bei deutschen und ungarischen Inhalten zählen: Indexstrategie, mehrsprachige Embedding-Modelle, was deutsche Komposita und ungarische Suffixe mit der Keyword-Suche machen, Akzentfaltung, Sprach-Metadaten, die Antwortsprache und die Evaluation pro Sprache. Dieselben Muster gelten für andere morphologisch reiche Sprachen.
Warum ist mehrsprachiges RAG schwieriger als englisches?
Drei Probleme stapeln sich. Erstens die Morphologie: Das Deutsche klebt Substantive zu Komposita zusammen (Kaffeetasse, Druckluftschlauch), das Ungarische ist agglutinierend, ein Stamm erscheint also mit vielen Suffixen (ház, házban, házainkban: Haus, im Haus, in unseren Häusern). Exakte Suche verfehlt die meisten dieser Formen. Zweitens sprachübergreifende Fragen: Eine deutsche Frage, deren Antwort in einem englischen Handbuch steht, findet per Keyword-Suche nichts. Drittens gemischte Korpora: Dasselbe Dokument in drei Sprachen kann die Top-Ergebnisse mit Beinahe-Duplikaten füllen.
Welche Indexstrategie sollte man wählen?
| Strategie | Funktionsweise | Geeignet für | Achtung |
|---|---|---|---|
| Ein mehrsprachiger Index | Ein Embedding-Modell für alle Sprachen, Sprache als Metadatum | Sprachübergreifende Fragen, gemischte Korpora | Keyword-Seite braucht weiter Analyse pro Sprache |
| Index pro Sprache | Getrennte Indizes, Anfrage nach erkannter Sprache geroutet | Vollständig lokalisierte Seiten mit parallelen Inhalten | Verfehlt Antworten, die es nur in einer anderen Sprache gibt |
| Beim Indexieren übersetzen | Alles in eine Pivotsprache übersetzt | Kleine, wertvolle Korpora in schwach unterstützten Sprachen | Kosten, Übersetzungsfehler, verlorene exakte Begriffe |
| Anfrage übersetzen | Anfrage vor der Suche in jede Korpussprache übertragen | Keyword-lastige Suche über Sprachen | Ein zusätzlicher LLM-Aufruf pro Anfrage |
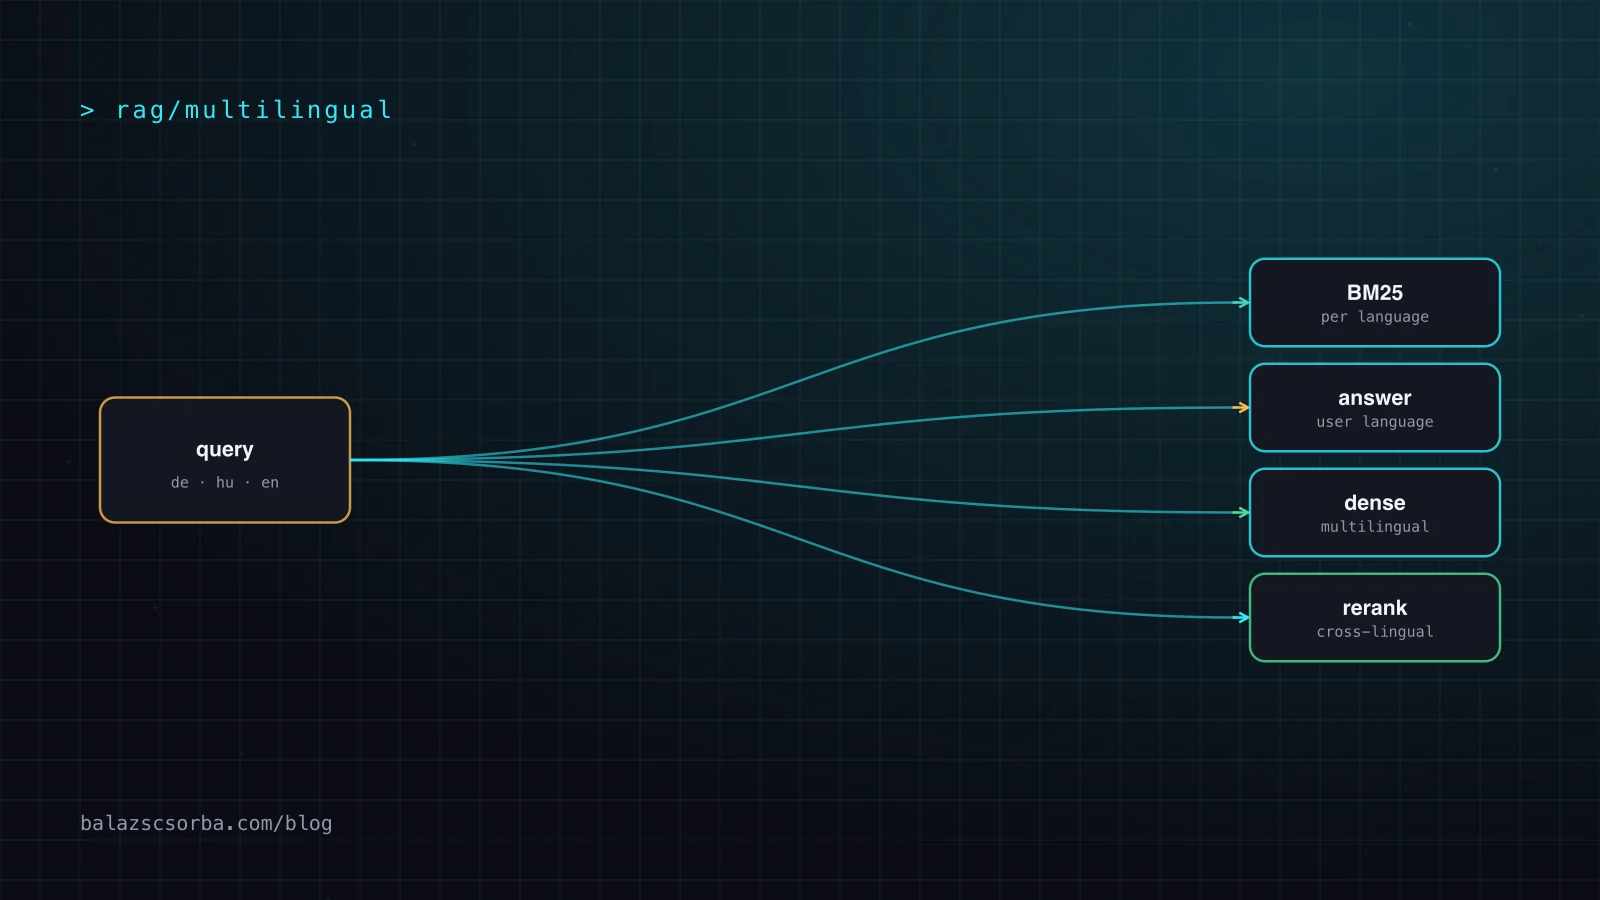
Bei den meisten Projekten beginne ich mit einem mehrsprachigen dichten Index plus einem pro Sprache analysierten Keyword-Index, kombiniert per hybrider Suche wie in Eine produktive RAG-Pipeline, Schritt für Schritt. Das behält den Originaltext, beantwortet sprachübergreifende Fragen über die dichte Seite und gibt jeder Sprache die passende Keyword-Analyse.
Welche mehrsprachigen Embedding-Modelle lohnen einen Test?
| Modell | Größe | Max. Eingabe | Hinweise |
|---|---|---|---|
| multilingual-e5-large-instruct | 560M | 512 Tokens | Bestes öffentliches Modell im MMTEB-Paper; 100 Sprachen aus XLM-R |
| BGE-M3 | auf XLM-R-Basis | 8.192 Tokens | 100+ Sprachen; dichte, sparse und Multi-Vektor-Ausgabe aus einem Modell |
| Qwen3 Embedding | 0.6B / 4B / 8B | Lang | Stark bei mehrsprachigem und sprachübergreifendem Retrieval; passende Reranker |
Das MMTEB-Paper umfasst über 500 Aufgaben in mehr als 250 Sprachen und kam zu dem Ergebnis, dass LLM-basierte Modelle mit Milliarden Parametern zwar bei einzelnen Teilmengen führen, das insgesamt beste öffentlich verfügbare Modell aber multilingual-e5-large-instruct mit 560 Millionen Parametern war. Dessen 512-Token-Grenze ist allerdings wichtig: Längere Chunks werden still abgeschnitten. BGE-M3 verarbeitet bis zu 8.192 Tokens und liefert neben dem dichten auch einen sparse Vektor, also ein gelerntes Keyword-Signal ohne eigenen Analyzer. Die Qwen3-Embedding-Reihe gibt es in drei Größen mit passenden Rerankern.
Durchschnitte verbergen die Sprachen, um die es geht. Ein Modell, das ein mehrsprachiges Leaderboard anführt, kann bei ungarischem Fachtext trotzdem mittelmäßig sein. Auch die gehosteten APIs der großen Anbieter sind mehrsprachig; müssen Daten im Haus bleiben, siehe LLMs für die DSGVO selbst hosten, und zur Speicherung pgvector oder eine Vektordatenbank.
Wie brechen deutsche Komposita die Keyword-Suche?
Wer nach Schlauch sucht, erwartet Druckluftschlauch zu finden. Ein Standard-Tokenizer sieht ein Token und keinen Treffer. Die Lösung ist Decompounding beim Indexieren: Komposita in bekannte Teile zerlegen und Teile wie Gesamtwort indexieren. Der Hyphenation Decompounder von Elasticsearch schlägt über Silbentrennmuster Teilwörter vor und behält nur die aus einer Wortliste; das Beispiel der Dokumentation zerlegt Kaffeetasse in Kaffee und tasse. Der Filter baut auf Lucenes Compound-Word-Filter auf, der für germanische Sprachen entwickelt wurde.
Dichte Embeddings gehen mit Komposita eleganter um, weil der Subword-Tokenizer seltene Wörter ohnehin zerlegt. Ein Grund mehr, beides zu betreiben: BM25 mit Decompounding für exakte Teile, Embeddings für die Bedeutung.
Was brauchen ungarische Suffixe und Akzente?
Fürs Ungarische braucht die Keyword-Seite einen Stemmer, der Kasusendungen und Possessivsuffixe abtrennt, damit számlán, számlák und számláimat auf einen Stamm treffen. Snowball hat Stemmer für Ungarisch und Deutsch, und PostgreSQL liefert Snowball-Wörterbücher mit, also kann schon die Volltextsuche von Postgres das. Dazu die Erweiterung unaccent, denn Nutzer tippen szamla statt számla und Groesse oder Grosse statt Größe.
-- PostgreSQL: one tsvector per chunk, analyzed in the chunk's own language
CREATE EXTENSION IF NOT EXISTS unaccent;

-- unaccent() is not IMMUTABLE, so wrap it for use in a generated column
CREATE FUNCTION unaccent_immutable(t text) RETURNS text
  LANGUAGE sql IMMUTABLE PARALLEL SAFE
  AS $$ SELECT public.unaccent('public.unaccent', t) $$;

ALTER TABLE chunks ADD COLUMN lang regconfig NOT NULL DEFAULT 'simple';
ALTER TABLE chunks ADD COLUMN tsv tsvector
  GENERATED ALWAYS AS (to_tsvector(lang, unaccent_immutable(text))) STORED;
CREATE INDEX chunks_tsv ON chunks USING gin (tsv);

-- Query in the user's language: 'hungarian', 'german' or 'english'
SELECT id, ts_rank(tsv, q) AS score
FROM chunks, websearch_to_tsquery('hungarian', unaccent('számláim')) AS q
WHERE tsv @@ q ORDER BY score DESC LIMIT 20;
Wie nutzt man Sprach-Metadaten bei der Abfrage?
Die Sprache jedes Chunks beim Indexieren erkennen und speichern, nicht nur die jedes Dokuments; Handbücher und Tickets mischen oft Sprachen. Bei der Abfrage gibt es drei Möglichkeiten, und es lohnt sich, bewusst zu wählen:
- Filtern auf die Sprache des Nutzers, wenn jedes Dokument in jeder Sprache existiert, wie in einem vollständig übersetzten Shop. Das entfernt Beinahe-Duplikate.
- Gewichten zugunsten der Nutzersprache, andere aber zulassen, wenn manche Inhalte nur in einer Sprache existieren, etwa rein englische Handbücher.
- Deduplizieren von Übersetzungen derselben Quelle über eine gemeinsame Dokument-ID nach dem Retrieval, wobei die Version in der Nutzersprache bleibt.
In welcher Sprache soll das Modell antworten?
Das Modell ausdrücklich anweisen, in der Sprache der Frage zu antworten, denn ein Kontext voller englischer Chunks zieht Antworten ins Englische. Zitate und Quellen in der Originalsprache belassen und den Originalabschnitt verlinken, damit Leser die Aussage prüfen können, wie bei Grounding und Zitaten. Produktnamen, Artikelnummern und Rechtsbegriffe gar nicht übersetzen.
Wie evaluiert man mehrsprachiges Retrieval?
Das Eval-Set von Anfang an mit dem erwarteten Sprachmix bauen: deutsche Fragen gegen deutsche Dokumente, ungarische gegen ungarische und ein sprachübergreifender Anteil, bei dem die Antwort nur in einer anderen Sprache steht. Fragen ohne Akzente und mit Tippfehlern aufnehmen, denn so tippen Menschen. Recall pro Anteil berichten, nicht als eine Zahl; der Durchschnitt ist genau das, was eine versagende Sprache versteckt. Die Metriken selbst sind dieselben wie in RAG evaluieren.
# Illustrative eval slices; report recall@10 per slice, never only the average
EVAL = [
  {"q": "Wie lang ist die Garantie auf Druckluftschläuche?", "lang": "de", "gold": ["warranty-de#3"]},
  {"q": "mennyi a garancia a tomlokre",                  "lang": "hu", "gold": ["garancia-hu#2"]},   # no accents
  {"q": "Betriebstemperatur Kompressor K40",              "lang": "de", "gold": ["k40-manual-en#7"]}, # answer only in English
]
Quellen
- Enevoldsen et al.: MMTEB: Massive Multilingual Text Embedding Benchmark (2025)
- Chen et al.: M3-Embedding (BGE-M3): Multi-Linguality, Multi-Functionality, Multi-Granularity (2024)
- Zhang et al.: Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models (2025)
- Hugging Face: intfloat/multilingual-e5-large-instruct model card
- Elasticsearch Reference: Hyphenation decompounder token filter
- PostgreSQL 18 Documentation: Text search dictionaries
- Snowball: stemming algorithms by language
Häufige Fragen
Welches Embedding-Modell ist das beste für Deutsch und Ungarisch?
An eigenen Daten testen. Die MMTEB-Autoren fanden das 560M-Parameter-Modell multilingual-e5-large-instruct als bestes öffentlich verfügbares Modell auf ihren mehrsprachigen Benchmarks, BGE-M3 und die Qwen3-Embedding-Reihe sind starke neuere Optionen mit längeren Eingaben. Werte pro Sprache können stark vom Durchschnitt abweichen.
Sollte ich vor dem Indexieren alles ins Englische übersetzen?
Meist nicht. Übersetzung kostet Geld, bringt Fehler, verliert exakte Begriffe und macht Zitate umständlich. Ein mehrsprachiges Embedding-Modell plus Keyword-Suche pro Sprache behält den Originaltext. Für einen kleinen, wertvollen Korpus in einer Sprache, die die Modelle schlecht beherrschen, kann Übersetzung trotzdem helfen.
Wie gehe ich in der Suche mit deutschen Komposita um?
Komposita beim Indexieren mit einem Decompounding-Filter in ihre Teile zerlegen, etwa mit dem Hyphenation Decompounder von Elasticsearch und einer deutschen Wortliste, und das ganze Wort zusätzlich behalten. Dichte Embeddings kommen mit Komposita besser zurecht, ein weiterer Grund für hybride Suche.
Unterstützt PostgreSQL ungarische Volltextsuche?
Ja. PostgreSQL liefert Snowball-Stemmer mit, und Snowball hat Stemmer für Ungarisch und Deutsch, also kann man mit to_tsvector und einer Konfiguration hungarian oder german indexieren und für akzentunabhängige Treffer die Erweiterung unaccent ergänzen.
In welcher Sprache soll der Assistent antworten?
In der Sprache der Frage, außer der Nutzer wünscht etwas anderes. Die Quelle in der Originalsprache zitieren, denn ein übersetztes Zitat lässt sich nicht mehr am Dokument prüfen.