Blog/LLMOps & Evals
LLMs selbst hosten für die DSGVO: wann es nötig ist und was es kostet
LLMs selbst hosten für die DSGVO: wann es nötig ist, GPU-Speicher für offene Modelle, EU-Preise Stand Oktober 2026 und Break-even pro Million Token.
Balázs Csorba··10 Min. Lesezeit
- Self-hosting
- GDPR
- vLLM
- GPU cost
- Open-weight models
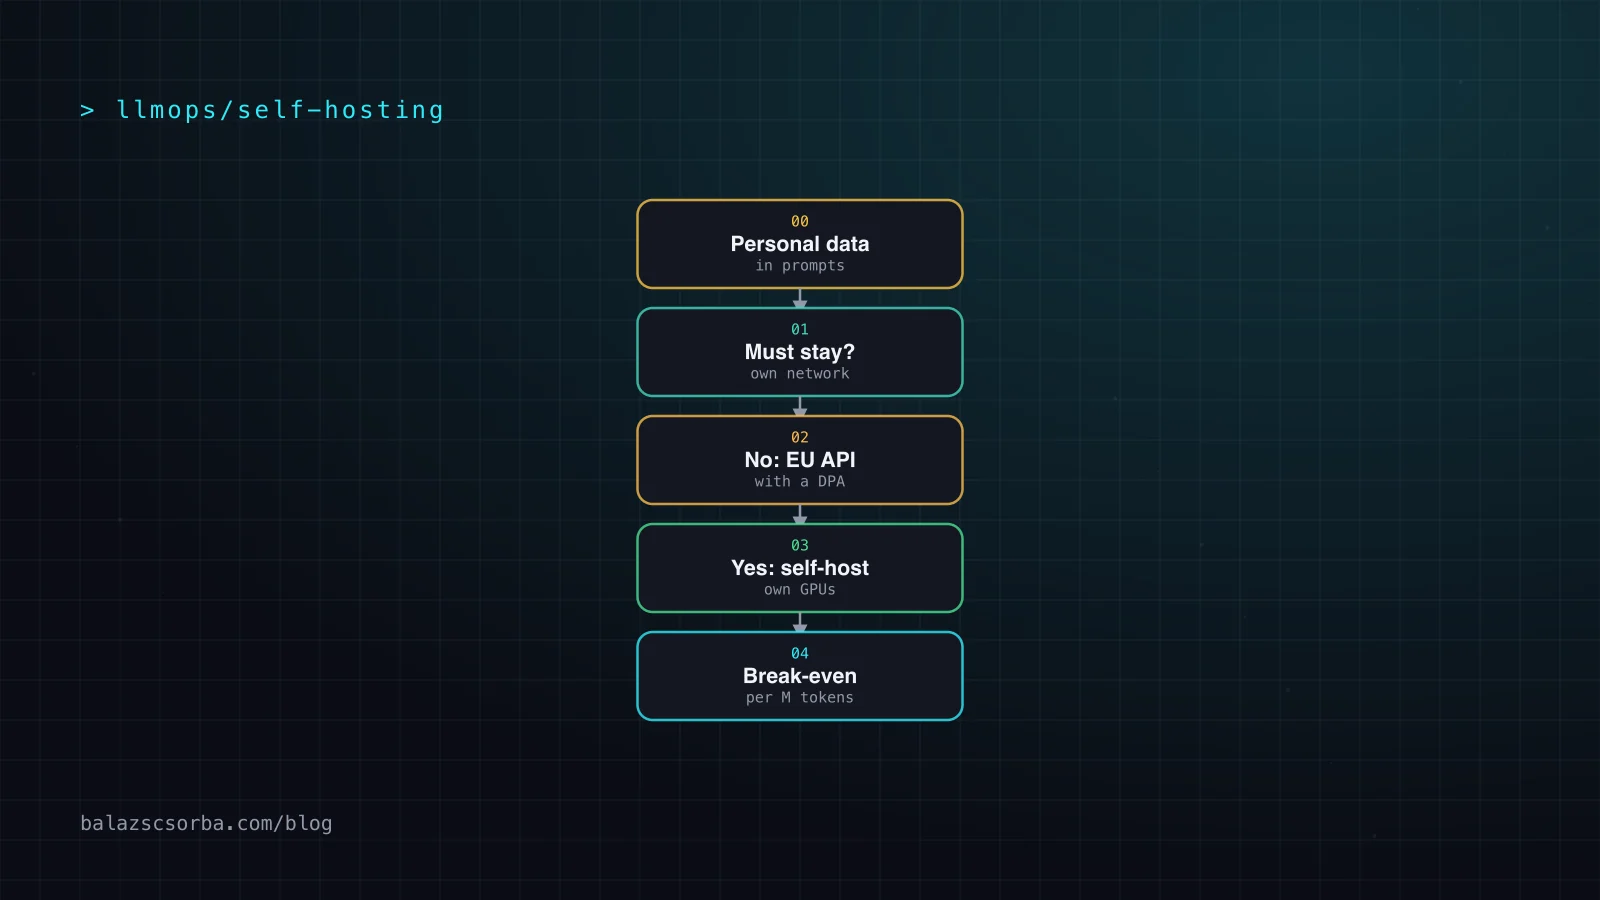
Das Wichtigste in Kürze
- Selbst hosten solltest du nur, wenn personenbezogene Daten in einem Netz bleiben müssen, das du kontrollierst, oder wenn ein Vertrag oder eine Aufsichtsbehörde jeden Auftragsverarbeiter ausschließt, den du nicht prüfen kannst.
- Eine EU-gehostete API mit Auftragsverarbeitungsvertrag (DPA), kurzer Speicherdauer und ohne Training auf deinen Daten kann viele B2B-Textanwendungen abdecken.
- Eine gemietete GPU entfernt den Auftragsverarbeiter nicht: Auch der Hoster braucht einen DPA. Selbst hosten verlagert den Auftragsverarbeiter also, statt ihn abzuschaffen.
- Die Gewichte brauchen etwa 2 GB pro Milliarde Parameter bei 16 Bit, 1 GB bei 8 Bit und 0,5 GB bei 4 Bit, jeweils ohne KV-Cache.
- Zu EU-API-Preisen schlägt eine gemietete H100 die API nur bei hoher Auslastung, und der Betrieb kommt noch dazu.
- Miss den Durchsatz mit deinen eigenen Prompts, bevor du Hardware kaufst oder mietest, mit vllm bench serve, denn veröffentlichte Werte schwanken stark.
Viele Teams wollen ein Sprachmodell aus Datenschutzgründen selbst hosten. Für die meisten B2B-Textanwendungen ist das nicht nötig. Die DSGVO verbietet Auftragsverarbeiter von Drittanbietern nicht. Sie verlangt einen Vertrag mit jedem Auftragsverarbeiter, eine Rechtsgrundlage für jede Übermittlung und bei riskanter Verarbeitung eine dokumentierte Risikobewertung. Eine EU-gehostete API mit Auftragsverarbeitungsvertrag (DPA) kann diese Anforderungen erfüllen. Selbst hosten ist die richtige Antwort, wenn personenbezogene Daten in einem Netz bleiben müssen, das du kontrollierst, oder wenn ein Vertrag oder eine Aufsichtsbehörde jeden Auftragsverarbeiter ausschließt, den du nicht prüfen kannst. Dann ist die GPU-Rechnung der leichte Teil der Planung – das meiste Geld geht in den Betrieb.
Dieser Artikel prüft die Zahlen am 10. Oktober 2026 und stützt sich nur auf Seiten, die ich öffnen konnte. Er behandelt, wann Selbsthosting nötig ist, wie viel GPU-Speicher offene Modelle je Genauigkeitsstufe brauchen, was EU-basierte GPUs kosten, was vLLM leistet, einen Break-even pro Million Token gegenüber EU-gehosteten APIs und die Kosten, die nach dem Go-live entstehen.
Wann Selbsthosting wirklich nötig ist
Die Frage ist nicht, ob ein Modell auf deiner Hardware laufen kann, sondern ob personenbezogene Daten dort bleiben müssen. Drei Situationen bringen mich zu einem selbst gehosteten Modell:
- Ein Vertrag verbietet es. Manche Kundenverträge und interne Richtlinien schließen Unterauftragsverarbeiter aus, die du nicht kontrollierst, oder verlangen, dass Daten ein definiertes Netz nie verlassen.
- Deine Datenschutz-Folgenabschätzung sagt nein. Die DSFA für den Anwendungsfall stuft das Risiko einer Verarbeitungskette als zu hoch ein, etwa bei Gesundheitsdaten oder Personalakten.
- Es gibt keinen passenden Anbieter. Kein EU-gehosteter Anbieter bietet das Modell zu den nötigen Bedingungen an, oder das System muss offline laufen, etwa in der Produktionshalle oder am Edge.
Alles Übrige ist eine Frage an den Auftragsverarbeiter, und eine EU-gehostete API beantwortet sie. Artikel 28 verlangt einen Vertrag, der Gegenstand und Dauer der Verarbeitung, Art und Zweck, die Arten personenbezogener Daten und Kategorien betroffener Personen sowie die Pflichten und Rechte des Verantwortlichen festlegt. Er verlangt außerdem eine vorherige schriftliche Genehmigung für Unterauftragsverarbeiter, allgemein oder für den Einzelfall, wobei dieselben Pflichten an sie weitergegeben werden. Artikel 44 macht jede Übermittlung in ein Drittland von den Bedingungen des Kapitels V abhängig. Für US-Unternehmen, die nach dem EU-US Data Privacy Framework zertifiziert sind, bildet der Angemessenheitsbeschluss der Kommission vom 10. Juli 2023 die Grundlage für die Übermittlung.
Selbst zu hosten klärt auch die Modellfrage nicht. Die Stellungnahme 28/2024 des EDSA, angenommen am 17. Dezember 2024, sagt, dass KI-Modelle, die mit personenbezogenen Daten trainiert wurden, nicht in allen Fällen als anonym gelten können. Anonymitätsbehauptungen sind daher im Einzelfall zu prüfen. Frag den Anbieter deshalb nach Dokumentation zu den Trainingsdaten, bevor du dich auf eine solche Behauptung stützt.
Modellgrößen und GPU-Speicher bei Quantisierung
Der Speicherbedarf der Gewichte ist einfache Rechnung: Parameter mal Bit pro Gewicht, geteilt durch acht. Ein Modell mit 70 Milliarden Parametern braucht etwa 140 GB bei 16 Bit, 70 GB bei 8 Bit und 35 GB bei 4 Bit (meine Berechnung). Dazu kommt der KV-Cache, der mit der Kontextlänge und den gleichzeitigen Anfragen wächst, sowie der Eigenbedarf der Laufzeitumgebung. Standardmäßig darf vLLM 92 Prozent des GPU-Speichers nutzen (gpu_memory_utilization, in der aktuellen Doku 0,92), und der KV-Cache bekommt, was die Gewichte übrig lassen.
| Modell | Größe, gesamt / aktiv | Genauigkeit | Gewichte, GB | benötigte Hardware |
|---|---|---|---|---|
| gpt-oss-20b | 21 Mrd. / 3,6 Mrd. | MXFP4, wie veröffentlicht | unter 16, laut Karte | 16 GB GPU-Speicher, laut Karte |
| Mistral Small 3.2 | 24 Mrd., dicht | bf16 | 48 (meine Berechnung); laut Karte etwa 55 | eine 80-GB-Karte, mit Platz für den Cache (meine Berechnung) |
| Llama 3.3 70B | 70 Mrd., dicht | bf16 / FP8 / 4 Bit | 140 / 70 / 35 (meine Berechnung) | zwei 80-GB-Karten bei bf16; eine 96-GB-Karte bei FP8; eine 48-GB-Karte bei 4 Bit (meine Berechnung) |
| gpt-oss-120b | 117 Mrd. / 5,1 Mrd. | MXFP4, wie veröffentlicht | laut Karte nicht angegeben | eine 80-GB-GPU, laut Karte |
| Mistral Large 3 | 675 Mrd., gesamt | FP8 / 4 Bit | 675 / etwa 340 (meine Berechnung) | mehr als 8 × 80 GB bei FP8; etwa 340 GB bei 4 Bit passen auf 8 × 80 GB (meine Berechnung) |
Zwei Lehren aus der Tabelle. Auf einer 80-GB-Karte bleiben einem 70B-Modell bei 8 Bit, nachdem vLLM seinen Anteil genommen hat, nur wenige Gigabyte für den Cache (meine Berechnung). Plane deshalb zwei Karten oder eine 96-GB-Karte ein. Und welches Modell du betreiben kannst, hängt vom Speicher ab, den du mieten kannst. Prüfe den Speicher also, bevor du einen Benchmark liest.
GPU-Optionen und Preise am 10. Oktober 2026
Das sind die Preise, die ich auf den Anbieterseiten lesen konnte, mit ihren Datumsangaben. Wo ein Anbieter einen Monatspreis nennt, zitiere ich ihn. Wo nicht, rechne ich mit 730 Stunden pro Monat und sage das dazu.
| Option | GPU-Speicher | Preis laut Anbieter | pro Monat | Datum und Quelle |
|---|---|---|---|---|
| Scaleway L4-1-24G, Paris | 24 GB | 0,79 € pro Stunde, netto | etwa 575 € (Scaleway) | 10. Okt. 2026, GPU-Preisseite |
| Scaleway H100-1-80G | 80 GB | 2,868 € pro Stunde ab 1. Juni 2026 | etwa 2.094 € (meine Berechnung) | 27. Apr. 2026, Scaleway-Blogbeitrag |
| OVHcloud l40s-1-gpu | nicht auf der Preisliste | 1,69 $ pro Stunde, ohne USt. | etwa 1.237 $ (OVHcloud) | 10. Okt. 2026, Preisliste Public Cloud |
| OVHcloud h100-1-gpu | 80 GiB | 3,39 $ pro Stunde, ohne USt. | etwa 2.473 $ (OVHcloud) | 10. Okt. 2026, Preisliste Public Cloud |
| RTX 5090, gekauft | 32 GB | 1.999 $ Einführungspreis | etwa 56 $ über 36 Monate (meine Berechnung) | NVIDIA-Newsroom, ab 30. Januar |
| Hetzner GEX63 oder GEX131 | 96 GB | auf der statischen Seite nicht lesbar | entfällt | 10. Okt. 2026, GPU-Server-Matrix |
Hetzner beschreibt seine GPU-Server als DSGVO-konform und in Europa gelegen. Die Matrixseite listet RTX-PRO-6000-Blackwell-Karten mit 96 GB GDDR7 in den Modellen GEX63 und GEX131 auf. Die monatlichen Preise stehen nur im Konfigurator, den ich nicht lesen konnte, deshalb lasse ich sie in der Tabelle weg. Prüfe sie dort, bevor du vergleichst.
Zwei Dinge sind zu beachten. Scaleway hat den Preis einer H100 am 1. Juni 2026 von 2,73 € auf 2,868 € pro Stunde angehoben, ältere Vergleichsseiten sind also veraltet. OVHcloud zeigt seine Preise in Dollar. Rechne sie deshalb am Tag des Vergleichs in Euro um, bevor du sie neben die Euro-Zeilen stellst.
Durchsatz mit vLLM: die Zahlen und wie du sie misst
Die eigenen Benchmarks von vLLM nennen relative Zugewinne statt absoluter Token pro Sekunde. Im Beitrag vom September 2024 zu v0.6.0 berichtete das Team vom 2,7-fachen Durchsatz gegenüber v0.5.3 bei Llama 3 8B auf einer H100 und vom 1,8-fachen bei Llama 3 70B auf vier H100, jeweils mit dem ShareGPT-Datensatz und 500 Prompts. Für den Server würde ich mit vLLM anfangen; meine vLLM-Rezension beschreibt die Abwägungen.
Absolute Zahlen hängen vom Modell, von der Länge der Prompts und Antworten und davon ab, wie schnell jeder Nutzer antworten soll. Der Benchmark von SemiAnalysis InferenceX zeigt diesen Zielkonflikt für Llama 3.3 70B auf H100. Pro GPU erreicht er etwa 1.850 Token pro Sekunde, wenn jeder Nutzer 38 Token pro Sekunde bekommt, etwa 1.170 bei 58 Token pro Sekunde und Nutzer und etwa 880 bei 78. Diese drei Werte sind aus den Datenpunkten der Seite interpoliert (meine Lesart), und der Benchmark nutzt 8K/1K-Sequenzlängen. Die Seite nennt Genauigkeit und Serving-Engine nicht durchgehend, deshalb behandle ich die Zahlen als Größenordnung.
# serve gpt-oss-120b on one 80 GB GPU (model card)
vllm serve openai/gpt-oss-120b

# a 70B model at bf16 needs two 80 GB GPUs (my calculation)
vllm serve meta-llama/Llama-3.3-70B-Instruct --tensor-parallel-size 2

# from a second terminal, send 500 random prompts at 4 requests per second
vllm bench serve --model openai/gpt-oss-120b --dataset-name random --num-prompts 500 --request-rate 4
Miss deine eigenen Zahlen mit vllm bench serve. Die Standardwerte senden 1.000 zufällige Prompts mit unendlicher Anfragerate (inf), deshalb setzt du Anzahl und Rate selbst und nimmst nach Möglichkeit Prompts, die deinen ähneln. Steigere dann die Rate und notiere bei jeder Stufe Time to First Token und Time per Output Token. Die Option --goodput zählt nur die Anfragen, die deine Latenzziele einhalten. Das ist die Zahl, die bei einem Feature mit Nutzerkontakt zählt.
Break-even pro Million Token
Die Formel passt in eine Zeile. Die Kosten pro Million Token ergeben sich aus den monatlichen GPU-Kosten, geteilt durch die im Monat erzeugten Token, mal eine Million. Die Token pro Monat ergeben sich aus den Token pro Sekunde mal 2.628.000 Sekunden (730 Stunden) mal dem Anteil der Zeit, in dem die GPU ausgelastet ist. Ich behandle jeden bedienten Token als einen abrechenbaren Token zum Output-Preis der API. Das hält den Vergleich einfach (meine Methode, kein Benchmark-Ergebnis).
Kosten pro Million Token für eine gemietete H100 bei 2.094 € im Monat, mit den InferenceX-Werten (meine Berechnung):
| Token pro Sekunde (Tempo pro Nutzer) | 25 % ausgelastet | 50 % ausgelastet | 100 % ausgelastet |
|---|---|---|---|
| 877 (78 Token/s pro Nutzer) | 3,63 € | 1,82 € | 0,91 € |
| 1.171 (58 Token/s pro Nutzer) | 2,72 € | 1,36 € | 0,68 € |
| 1.848 (38 Token/s pro Nutzer) | 1,72 € | 0,86 € | 0,43 € |
Gegen die EU-APIs ist Llama 3.3 70B der nähere Fall. OVHcloud verlangt 0,67 € pro Million Token, Scaleway 0,90 €. Bei 58 Token pro Sekunde und Nutzer müsste eine gemietete H100 rund um die Uhr etwa 1.190 Token pro Sekunde liefern, um OVHcloud zu erreichen (meine Berechnung). Der Benchmark liefert bei diesem Tempo 1.171 Token pro Sekunde, also schafft sie es nicht. Gegenüber 0,90 € bei Scaleway liegt der Break-even bei etwa 885 Token pro Sekunde, rund drei Vierteln dieses Benchmark-Werts.
gpt-oss-120b setzt die Latte höher. Die API kostet bei Scaleway 0,60 € pro Million Output-Token und bei OVHcloud 0,40 €. Eine gemietete H100 für 2.094 € im Monat muss daher im Schnitt etwa 1.330 Output-Token pro Sekunde erzeugen, um Scaleway zu erreichen, und etwa 1.990, um OVHcloud zu erreichen (meine Berechnung). Ich habe keine verifizierte H100-Zahl für gpt-oss-120b gefunden, miss also, bevor du entscheidest. Input-Token sind noch günstiger, mit 0,15 € und 0,08 € pro Million.
Die Betriebskosten kommen obendrauf. Jede 1.000 € monatlicher Betriebskosten verschieben den Break-even von gpt-oss-120b bei 0,60 € pro Million Token um etwa 1,7 Milliarden Output-Token im Monat, oder rund 630 Token pro Sekunde rund um die Uhr (meine Berechnung). Der Preis allein rechtfertigt Selbsthosting also selten, wenn eine EU-gehostete API das Modell schon anbietet. Der Fall entsteht, wenn die Hardware dir bereits gehört, wenn die Last eine GPU den ganzen Monat auslastet oder wenn kein EU-Anbieter das gewünschte Modell hat.
Eigene Hardware: die Karte ist günstig, Strom und Lizenz nicht
Eine gekaufte Karte wirkt neben einer gemieteten günstig. NVIDIA hat die GeForce RTX 5090 zum Start mit 1.999 $ angesetzt, mit 32 GB GDDR7 und 575 W Gesamtgrafikleistung. Auf 36 Monate verteilt kostet die Karte etwa 56 $ im Monat (meine Berechnung). Läuft sie rund um die Uhr auf Volllast, verbraucht allein die Karte etwa 420 kWh im Monat (575 W mal 730 Stunden, meine Berechnung). Bei der Beispielannahme von 30 ct/kWh sind das etwa 126 € im Monat (meine Berechnung, kein Tarif-Zitat). Über drei Jahre kommt allein der Strom auf rund 4.500 €, mehr als das Doppelte des Einführungspreises von 1.999 $.
Die Kosten, die nach dem Go-live auftauchen
Sobald der Dienst läuft, ist die GPU-Miete meist der kleinste Posten. Der Rest sind Arbeitszeit und Risiko. Die Planungswerte in der Tabelle sind meine eigenen Annahmen, keine gemessenen Daten, ersetze sie deshalb durch die Zahlen deines Teams.
| Posten | Was dazugehört | Planungsannahme (meine) |
|---|---|---|
| Betrieb | Serving, Monitoring, GPU-Ausfälle, Neustarts, Kapazitätsplanung | 0,1 bis 0,2 der Arbeitszeit einer Person |
| Updates | neue Versionen von vLLM, CUDA und Treiber, OS-Patches, Modellwechsel | zwei bis fünf Ingenieurstage pro Modellwechsel |
| Evals | ein Regressionsset vor jeder Modell- oder Serving-Änderung | zwei bis fünf Tage zum Aufbau, danach etwa ein Tag pro Lauf |
| Bereitschaft | jemand antwortet, wenn der Endpunkt außerhalb der Arbeitszeit ausfällt | mindestens zwei Personen für einen 24/7-Dienst |
| Redundanz | ein zweiter GPU-Knoten für das Failover | verdoppelt die Miete ungefähr |
| Compliance | DPA mit dem Hoster, Aktualisierung der DSFA, Verzeichnis der Verarbeitungstätigkeiten, Logs, die du dann selbst besitzt | ein paar Tage pro Jahr |
Was ich zuerst tun würde
- Schreib die Daten und die Regeln auf. Notiere, welche Datenklassen das Modell erreichen und welche Verträge oder DSFA-Ergebnisse gelten. Schließt keine davon einen Auftragsverarbeiter aus, starte mit einer EU-API mit DPA.
- Hol dir die Hosting-Fakten schriftlich. Frag nach der Hosting-Region, der Liste der Unterauftragsverarbeiter und den Speichereinstellungen. Mistrals Preisseite verlinkt einen DPA, sagt aber nicht, wo die API läuft. Diese Antwort muss deshalb aus dem Vertrag kommen.
- Wähle das kleinste Modell, das deine Evals besteht. Prüfe dann seinen Speicherbedarf bei der Genauigkeit, die du tatsächlich betreiben kannst, nicht bei der auf der Modellkarte.
- Miss mit deinen eigenen Prompts. Führe vllm bench serve mit deinen echten Prompt-Längen und einem Latenzziel aus, bevor du dich auf Hardware festlegst.
- Berechne den Break-even mit deinen eigenen Zahlen neu. Nutze deine gemessenen Token pro Sekunde, deine echte Auslastung und dein Betriebsbudget. Geht es nicht auf, bleib bei der API und halte Selbsthosting als dokumentierte Rückfalloption fest.
- Plane den Betrieb vor dem Go-live ein. Lege zuerst die Eval-Suite, den Bereitschaftsplan und die Update-Regeln fest. Die GPU ist der einfache Teil.
Für die Datenseite der Pipeline lies meine Notizen zu EU-Datenresidenz, Regionskontrollen und Zero Retention und zu PII-Redaktion. Für das Regressionsset siehe LLM-Evals für Produktfeatures.
Quellen
- Modellkarte openai/gpt-oss-120b (Hugging Face)
- Modellkarte mistralai/Mistral-Small-3.2-24B-Instruct-2506 (Hugging Face)
- Modellkarte meta-llama/Llama-3.3-70B-Instruct (Hugging Face)
- Modellkarte mistralai/Mistral-Large-3-675B-Instruct-2512 (Hugging Face)
- vLLM-Blog: Leistungsupdate v0.6.0 (September 2024)
- vLLM-Dokumentation: Engine-Argumente
- vLLM-Dokumentation: vllm bench serve
- SemiAnalysis InferenceX: Llama 3.3 70B auf H100 vs. H200
- Scaleway: Preise für GPU-Instanzen
- Scaleway-Blog: Ein transparentes Update zu den Scaleway-Preisen (27. April 2026)
- Scaleway Generative APIs: Preise
- OVHcloud: Preisliste Public Cloud
- OVHcloud AI Endpoints
- OVHcloud AI Endpoints: Modellkatalog
- Hetzner: dedizierte GPU-Server
- NVIDIA-Newsroom: Start der GeForce-RTX-50-Serie
- NVIDIA GeForce RTX 5090
- NVIDIA GeForce-Softwarelizenz
- DSGVO Artikel 28: Auftragsverarbeiter
- DSGVO Artikel 44: allgemeiner Grundsatz für Übermittlungen
- Europäische Kommission: EU-US-Datenübermittlungen (Data Privacy Framework)
- EDSA-Stellungnahme 28/2024 zu KI-Modellen (angenommen am 17. Dezember 2024)
- Mistral AI: Preise
Häufige Fragen
Macht ein selbst gehostetes LLM die DSGVO-Konformität automatisch?
Nein. Du streichst einen Auftragsverarbeiter, brauchst aber weiterhin eine Rechtsgrundlage, eine Risikobewertung, ein Verzeichnis der Verarbeitungstätigkeiten, Löschregeln und einen DPA mit dem Unternehmen, das deine Server betreibt. Der EDSA sagt außerdem, dass KI-Modelle, die mit personenbezogenen Daten trainiert wurden, nicht in allen Fällen als anonym gelten können.
Wie viel GPU-Speicher braucht ein 70B-Modell?
Etwa 140 GB Gewichte bei 16 Bit, 70 GB bei 8 Bit und 35 GB bei 4 Bit, jeweils ohne KV-Cache (meine Berechnung). Bei 8 Bit bleibt auf einer 80-GB-Karte wenig Platz für den Kontext. Plane deshalb zwei Karten oder eine Karte mit 96 GB.
Wann reicht eine EU-gehostete API mit DPA?
Wenn keine besonderen Kategorien personenbezogener Daten im Spiel sind und weder ein Kundenvertrag noch eine Folgenabschätzung einen Auftragsverarbeiter ausschließt. Prüfe die Liste der Unterauftragsverarbeiter, die Hosting-Region, die Speichereinstellungen und ob der Anbieter mit deinen Daten trainiert.
Was kostet eine gemietete H100 pro Million Token?
Bei 2.094 € im Monat (meine Berechnung: 2,868 € pro Stunde über 730 Stunden) etwa 0,68 € pro Million Output-Token bei 1.171 Token pro Sekunde über den ganzen Monat (58 Token pro Sekunde und Nutzer), und etwa 1,36 € bei der halben Auslastung (meine Berechnung).