Blog/Retrieval és keresés
Többnyelvű RAG német és magyar tartalomra: embeddingek, összetett szavak és nyelvek közötti keresés
RAG német és magyar tartalom fölött: többnyelvű embeddingek, összetett szavak, szótövezés, ékezetek és nyelvenkénti értékelés.
Balázs Csorba··7 perc olvasás
- RAG
- Multilingual
- Embeddings
- German
- Hungarian
A lényeg röviden
- Egy többnyelvű embedding-modellel egy német kérdés magyar vagy angol szövegrészt is megtalál, a kulcsszavas keresésnek viszont továbbra is nyelvenkénti elemzés kell.
- A német összetett szavak és a magyar toldalékok elrontják a naiv BM25-öt: németre szóösszetétel-bontás, magyarra Snowball-szótövező kell.
- A felhasználók ékezetek és umlautok nélkül gépelnek magyarul és németül; a kulcsszóindexben hajtsd le az ékezeteket, de az eredeti szöveget is tárold.
- Minden chunk nyelvét tárold, és döntsd el tudatosan, hogy lekérdezéskor nyelv szerint szűrsz, súlyozol vagy kevered a nyelveket.
- A ranglisták sok nyelv átlagát mutatják; modellválasztás előtt építs egy kis értékelőkészletet nyelvenként és egyet nyelvek közötti keresésre.
A legtöbb RAG-oktatóanyag angol dokumentumokat és angol kérdéseket feltételez. Az ausztriai, németországi és magyarországi projektek ritkán ilyenek: a termékadatok németül, az ügyfélszolgálati jegyek magyarul, a kézikönyvek angolul vannak, a felhasználók pedig azon a nyelven kérdeznek, amelyen éppen gondolkodnak, sokszor umlautok és ékezetek nélkül. A demóban működő visszakeresés csendben elveszíti a releváns szövegrészek felét.
Ez a cikk a német és magyar tartalomnál fontos döntéseket veszi sorra: indexstratégia, többnyelvű embedding-modellek, mit tesznek a német összetett szavak és a magyar toldalékok a kulcsszavas kereséssel, ékezet-lehajtás, nyelvi metaadatok, a válasz nyelve és a nyelvenkénti értékelés. Ugyanezek a minták más, morfológiailag gazdag nyelvekre is érvényesek.
Miért nehezebb a többnyelvű RAG, mint az angol?
Három probléma adódik össze. Az első a morfológia: a német összetett szavakká ragasztja a főneveket (Kaffeetasse, Druckluftschlauch), a magyar pedig ragozó nyelv, így egy szótő sokféle toldalékkal jelenik meg (ház, házban, házainkban). A pontos egyezésen alapuló keresés ezeknek az alakoknak a többségét nem találja meg. A második a nyelvek közötti kérdés: egy német kérdés, amelyre a válasz egy angol kézikönyvben van, kulcsszavas kereséssel semmit sem talál. A harmadik a vegyes korpusz: ugyanaz a dokumentum három nyelven majdnem azonos találatokkal töltheti meg a lista elejét.
Melyik indexstratégiát válaszd?
| Stratégia | Működés | Mire jó | Figyelj |
|---|---|---|---|
| Egy többnyelvű index | Egy embedding-modell minden nyelvre, a nyelv metaadatként | Nyelvek közötti kérdések, vegyes korpusz | A kulcsszavas oldalnak továbbra is nyelvenkénti elemzés kell |
| Nyelvenkénti index | Külön indexek, a kérdés a felismert nyelv szerint irányítva | Teljesen lokalizált oldalak párhuzamos tartalommal | Elveszíti a csak más nyelven létező válaszokat |
| Fordítás indexeléskor | Mindent egy közvetítő nyelvre fordítunk | Kis, értékes korpusz gyengén támogatott nyelven | Költség, fordítási hibák, elveszett pontos kifejezések |
| A kérdés fordítása | A kérdést keresés előtt a korpusz minden nyelvére átírjuk | Kulcsszóra építő keresés több nyelven | Kérdésenként egy plusz LLM-hívás |
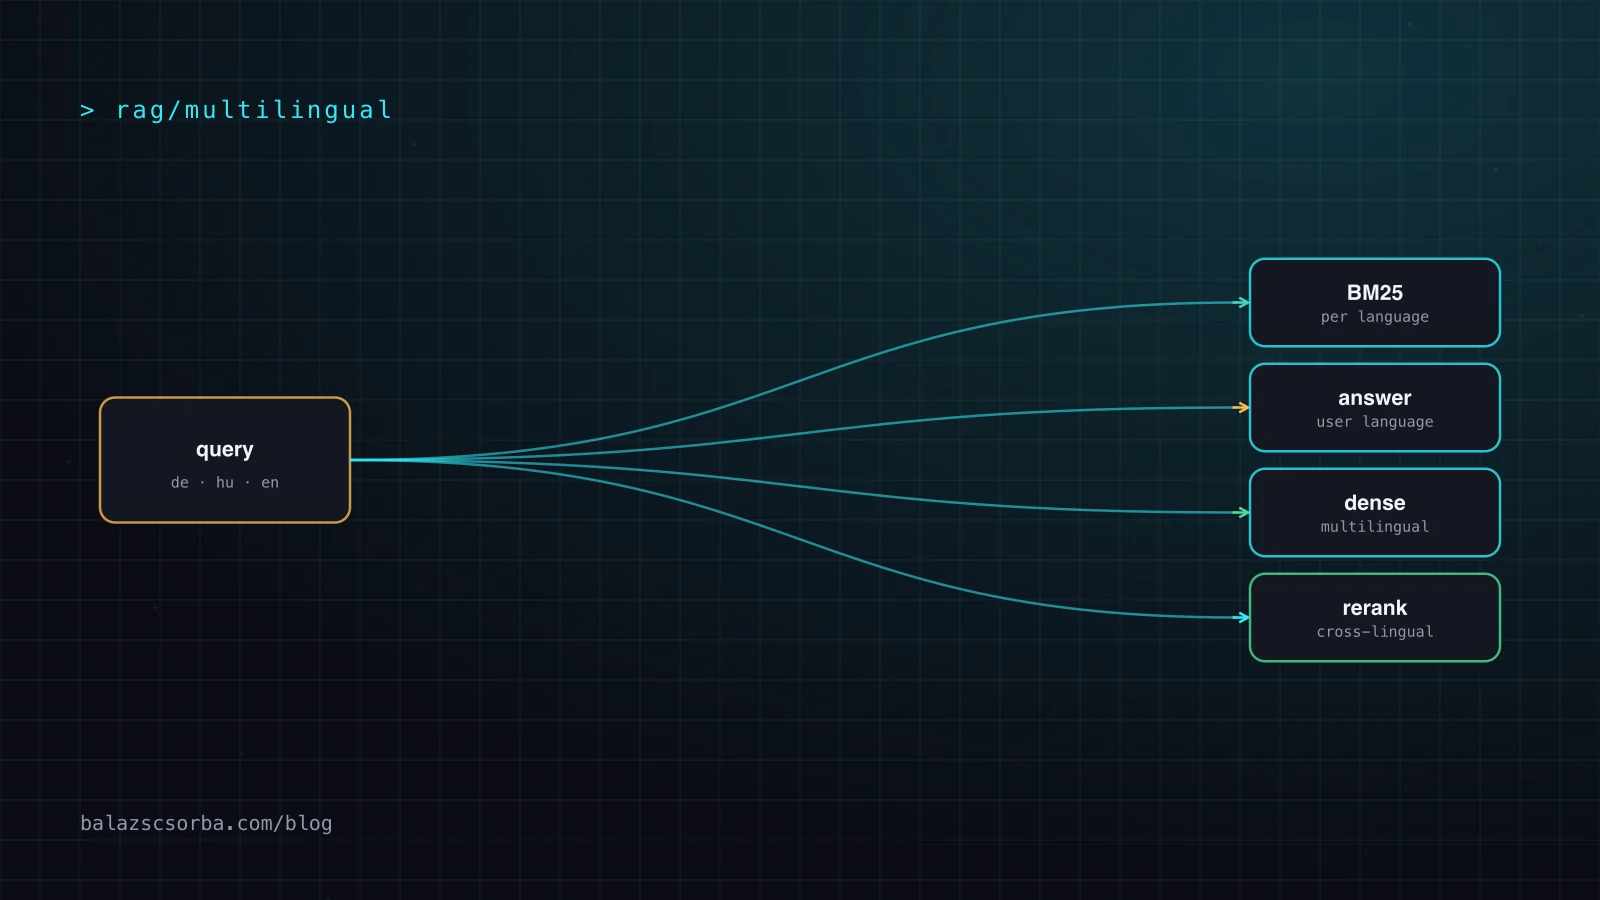
A legtöbb projektnél egy többnyelvű sűrű indexszel és egy nyelvenként elemzett kulcsszóindexszel kezdek, hibrid kereséssel kombinálva, ahogy az Éles RAG-pipeline lépésről lépésre cikkben. Ez megtartja az eredeti szöveget, a sűrű oldalon kezeli a nyelvek közötti kérdéseket, és minden nyelv megkapja a megfelelő kulcsszavas elemzést.
Mely többnyelvű embedding-modelleket érdemes kipróbálni?
| Modell | Méret | Max. bemenet | Megjegyzés |
|---|---|---|---|
| multilingual-e5-large-instruct | 560M | 512 token | Az MMTEB-tanulmányban a legjobb nyilvános modell; 100 nyelv az XLM-R-ből |
| BGE-M3 | XLM-R alapú | 8192 token | 100+ nyelv; sűrű, ritka és többvektoros kimenet egy modellből |
| Qwen3 Embedding | 0.6B / 4B / 8B | Hosszú | Erős a többnyelvű és a nyelvek közötti visszakeresésben; hozzá illő rerankerek |
Az MMTEB-tanulmány több mint 500 feladatot fed le több mint 250 nyelven, és azt találta, hogy bár a milliárdos paraméterszámú LLM-alapú modellek egyes részhalmazokon vezetnek, összességében a legjobb nyilvánosan elérhető modell az 560 millió paraméteres multilingual-e5-large-instruct volt. Az 512 tokenes korlátja viszont számít: a hosszabb chunkokat szó nélkül levágja. A BGE-M3 8192 tokenig kezeli a bemenetet, és a sűrű mellett ritka vektort is ad, vagyis tanult kulcsszó-jelet külön elemző nélkül. A Qwen3 Embedding sorozat három méretben érhető el, hozzá illő rerankerekkel.
Az átlag elrejti azokat a nyelveket, amelyek számodra fontosak. Egy többnyelvű ranglistát vezető modell magyar szakszövegen még lehet közepes. A nagy szolgáltatók hosztolt API-jai is többnyelvűek; ha az adatnak házon belül kell maradnia, lásd a saját LLM-ek a GDPR-ban cikket, a tároláshoz pedig a pgvector vagy vektoradatbázis cikket.
Hogyan rontják el a német összetett szavak a kulcsszavas keresést?
Aki a Schlauch szóra keres, a Druckluftschlauch szót is meg akarja találni. Egy szabványos tokenizáló egyetlen tokent lát, és nincs találat. A megoldás az indexeléskori szóösszetétel-bontás: az összetett szavakat ismert részekre bontjuk, és a részeket és a teljes szót is indexeljük. Az Elasticsearch hyphenation decompounder szűrője elválasztási minták alapján javasol részszavakat, és csak a szólistában szereplőket tartja meg; a dokumentáció példája a Kaffeetasse szót Kaffee és tasse részekre bontja. A szűrő a Lucene összetettszó-szűrőjére épül, amelyet germán nyelvekre terveztek.
A sűrű embeddingek elegánsabban kezelik az összetett szavakat, mert a részszó-tokenizáló amúgy is szétbontja a ritka szavakat. Ez is amellett szól, hogy mindkettőt futtasd: szóbontásos BM25-öt a pontos részekre, embeddinget a jelentésre.
Mire van szükség a magyar toldalékokhoz és ékezetekhez?
Magyarnál a kulcsszavas oldalnak olyan szótövező kell, amely leválasztja az esetragokat és a birtokos személyjeleket, hogy a számlán, a számlák és a számláimat egy tőben találkozzon. A Snowballnak van magyar és német szótövezője, a PostgreSQL pedig Snowball-szótárakat tartalmaz, így már a Postgres teljes szöveges keresése is megoldja. Tedd mellé az unaccent bővítményt, mert a felhasználók szamla-t írnak számla helyett, és Groesse-t vagy Grosse-t Größe helyett.
-- PostgreSQL: one tsvector per chunk, analyzed in the chunk's own language
CREATE EXTENSION IF NOT EXISTS unaccent;

-- unaccent() is not IMMUTABLE, so wrap it for use in a generated column
CREATE FUNCTION unaccent_immutable(t text) RETURNS text
  LANGUAGE sql IMMUTABLE PARALLEL SAFE
  AS $$ SELECT public.unaccent('public.unaccent', t) $$;

ALTER TABLE chunks ADD COLUMN lang regconfig NOT NULL DEFAULT 'simple';
ALTER TABLE chunks ADD COLUMN tsv tsvector
  GENERATED ALWAYS AS (to_tsvector(lang, unaccent_immutable(text))) STORED;
CREATE INDEX chunks_tsv ON chunks USING gin (tsv);

-- Query in the user's language: 'hungarian', 'german' or 'english'
SELECT id, ts_rank(tsv, q) AS score
FROM chunks, websearch_to_tsquery('hungarian', unaccent('számláim')) AS q
WHERE tsv @@ q ORDER BY score DESC LIMIT 20;
Hogyan használd a nyelvi metaadatot lekérdezéskor?
Indexeléskor minden chunk nyelvét ismerd fel és tárold, ne csak a dokumentumokét; a kézikönyvek és a jegyek gyakran keverik a nyelveket. Lekérdezéskor három lehetőséged van, és érdemes tudatosan választani:
- Szűrés a felhasználó nyelvére, ha minden dokumentum minden nyelven megvan, mint egy teljesen lefordított webshopban. Ez eltávolítja a majdnem azonos találatokat.
- Súlyozás a felhasználó nyelve javára, de a többi nyelv engedése, ha egyes tartalmak csak egy nyelven léteznek, például a csak angol kézikönyvek.
- Duplikátumszűrés: ugyanannak a forrásnak a fordításait a visszakeresés után közös dokumentumazonosító alapján vond össze, és a felhasználó nyelvén írt változatot tartsd meg.
Milyen nyelven válaszoljon a modell?
Kifejezetten utasítsd a modellt, hogy a kérdés nyelvén válaszoljon, mert az angol chunkokkal teli kontextus az angol felé húzza a választ. Az idézeteket és a hivatkozásokat hagyd a forrás nyelvén, és linkeld az eredeti szövegrészt, hogy az olvasó ellenőrizhesse az állítást, ahogy a grounding és hivatkozások cikkben. A termékneveket, cikkszámokat és jogi kifejezéseket egyáltalán ne fordítsd.
Hogyan értékeld a többnyelvű visszakeresést?
Az értékelőkészletet már az elejétől a várt nyelvi keverékkel építsd: német kérdések német dokumentumokra, magyarok magyarokra, és egy nyelvek közötti szelet, ahol a válasz csak más nyelven létezik. Vegyél fel ékezet nélküli és elgépelt kérdéseket is, mert az emberek így gépelnek. A felidézést szeletenként jelentsd, ne egyetlen számként; éppen az átlag rejti el a gyengén teljesítő nyelvet. Maguk a metrikák ugyanazok, mint a RAG értékelése cikkben.
# Illustrative eval slices; report recall@10 per slice, never only the average
EVAL = [
  {"q": "Wie lang ist die Garantie auf Druckluftschläuche?", "lang": "de", "gold": ["warranty-de#3"]},
  {"q": "mennyi a garancia a tomlokre",                  "lang": "hu", "gold": ["garancia-hu#2"]},   # no accents
  {"q": "Betriebstemperatur Kompressor K40",              "lang": "de", "gold": ["k40-manual-en#7"]}, # answer only in English
]
Források
- Enevoldsen et al.: MMTEB: Massive Multilingual Text Embedding Benchmark (2025)
- Chen et al.: M3-Embedding (BGE-M3): Multi-Linguality, Multi-Functionality, Multi-Granularity (2024)
- Zhang et al.: Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models (2025)
- Hugging Face: intfloat/multilingual-e5-large-instruct model card
- Elasticsearch Reference: Hyphenation decompounder token filter
- PostgreSQL 18 Documentation: Text search dictionaries
- Snowball: stemming algorithms by language
Gyakori kérdések
Melyik embedding-modell a legjobb németre és magyarra?
A saját adataidon teszteld. Az MMTEB szerzői a többnyelvű benchmarkjaikon az 560 millió paraméteres multilingual-e5-large-instructot találták a legjobb nyilvánosan elérhető modellnek, a BGE-M3 és a Qwen3 Embedding sorozat pedig erős, újabb, hosszabb bemenetet kezelő lehetőségek. A nyelvenkénti eredmények sokat eltérhetnek az átlagtól.
Indexelés előtt fordítsak le mindent angolra?
Általában nem. A fordítás pénzbe kerül, hibákat visz be, elveszti a pontos kifejezéseket, és nehézkessé teszi a hivatkozást. Egy többnyelvű embedding-modell és a nyelvenkénti kulcsszavas keresés megtartja az eredeti szöveget. Kis, értékes korpusznál, olyan nyelven, amelyet a modellek gyengén kezelnek, a fordítás ettől még segíthet.
Hogyan kezeljem a német összetett szavakat a keresésben?
Indexeléskor bontsd részeire az összetett szavakat egy decompounding szűrővel, például az Elasticsearch hyphenation decompounderével és egy német szólistával, a teljes szót pedig is tartsd meg. A sűrű embeddingek jobban boldogulnak az összetett szavakkal, ez is a hibrid keresés mellett szól.
Támogatja a PostgreSQL a magyar teljes szöveges keresést?
Igen. A PostgreSQL Snowball-szótövezőket tartalmaz, a Snowballnak pedig van magyar és német szótövezője is, így a to_tsvector függvénnyel hungarian vagy german konfigurációval indexelhetsz, ékezetfüggetlen találatokhoz pedig hozzáadhatod az unaccent bővítményt.
Milyen nyelven válaszoljon az asszisztens?
A kérdés nyelvén, hacsak a felhasználó mást nem kér. A forrást eredeti nyelven idézd és hivatkozd, mert egy lefordított idézet már nem ellenőrizhető a dokumentumon.