Blog/RAG és keresés
LLM-hallucinációk csökkentése éles rendszerben: grounding, hivatkozások és a nemet mondás tudománya
Hallucinációk csökkentése éles RAG-ban: hivatkozás-API-k, tartózkodás, állításszintű ellenőrzés, faithfulness-mérés, forrás-UI és ami mégis átcsúszik.
Balázs Csorba··13 perc olvasás
- Hallucinations
- RAG
- Citations
- Grounding
- Faithfulness
A lényeg röviden
- A retrieval nem szünteti meg a hallucinációt. Egy Stanford-tanulmány szerint vezető RAG-alapú jogi eszközök az esetek 17–33 százalékában még mindig hallucináltak, gyakran úgy, hogy valódi forrásra hivatkoztak, amely nem támasztja alá az állítást.
- A groundingot pipeline-ként kezeld, ne promptként: evidencia-kapu generálás előtt, natív hivatkozások közben, állításszintű ellenőrzés utána, és olyan felület, amely megmutatja a bizonyítékot.
- A tartózkodás (abstention) termékállapot, nem hibaüzenet. Tervezd meg a „ezt a dokumentumokból nem tudom megválaszolni” utat, mérd, és adj neki következő lépést.
- A hivatkozás-API-k a mutatót teszik érvényessé, nem a következtetést igazzá. Az Anthropic érvényes dokumentummutatókat garantál; hogy a szakasz alátámasztja-e az állítást, azt tovább kell ellenőrizni, mert egy vizsgálatban a hivatkozások akár 57 százaléka utólagos racionalizálás volt.
- A faithfulnesst (a lekért kontextus által támogatott állítások aránya) a helyességtől külön mérd, olyan tesztkészleten, amely tartalmaz a dokumentumokból megválaszolhatatlan kérdéseket is.
Minden csapat, amely retrieval-augmented asszisztenst ad ki, ugyanazokon a szakaszokon megy át. Először jön a demó, amely gyönyörűen válaszol. Aztán jön az első valódi felhasználó, aki a második napon talál egy magabiztos, folyékony, téves választ. Aztán valaki megkérdezi: „hiszen már RAG-ot használunk, miért talál ki mégis dolgokat?”
Az őszinte válasz: a retrieval a valószínűségeket változtatja meg, nem a rendszer természetét. A nyelvi modell továbbra is hihető szöveget gyárt; a retrieval csak jobb alapanyagot ad neki, és esélyt arra, hogy megmutassa a munkáját. Ez a cikk arról szól, hogyan építeném meg a modell körüli részt úgy, hogy a téves válaszok ritkábbak, láthatók és javíthatók legyenek. A chunkolásról, hibrid keresésről és rerankingről és a termékfunkciók evaljairól írt bejegyzéseimre épül; itt arra figyelek, mi történik a szakaszok lekérése után.
Mi számít hallucinációnak egy RAG-rendszerben
Egy zárt könyves chatbotban a hallucináció hamis állítás. Egy RAG-rendszerben két külön hiba van, és más-más orvosság kell rájuk:
- Téves tartalom: a válasz valami hamisat állít, vagy azért, mert a retrieval rossz vagy elavult szakaszt hozott, vagy azért, mert a modell figyelmen kívül hagyta a kontextust, és emlékezetből válaszolt.
- Misgrounded tartalom: a válasz hivatkozik egy forrásra, de a forrás ezt nem mondja. A kereskedelmi jogi kutatóeszközöket értékelő Stanford–Yale csapat pontosan definiálja: egy válasz hallucinált, ha téves vagy misgrounded, vagyis hamisan állítja, hogy egy forrás alátámaszt egy állítást („falsely asserts that a source supports a statement”).
A második típus a veszélyes. Ugyanez a vizsgálat a LexisNexis és a Thomson Reuters „hallucinációmentes” hivatkozásokkal hirdetett eszközeit tesztelte, és az esetek 17–33 százalékában talált hallucinációt. A szerzők megjegyzik, hogy az ilyen hibák ellenőrzése azt jelenti, hogy rá kell kattintani, el kell olvasni a forrást és össze kell vetni az állítással, pontosan azt a munkát, amelyet a felhasználók elvárnak, hogy az eszköz már elvégzett.
Miért találgatnak egyáltalán a modellek? A „Why Language Models Hallucinate” tanulmány szerint a tanítási és értékelési eljárások a találgatást jutalmazzák a bizonytalanság beismerése helyett, mert a találgató modell jobban teljesít a benchmarkokon, mint a tartózkodó. Ez gyakorlati következménnyel jár: a modell alapviselkedése a válaszadás, ezért a tartózkodást bele kell tervezni a rendszerbe, nem remélni.
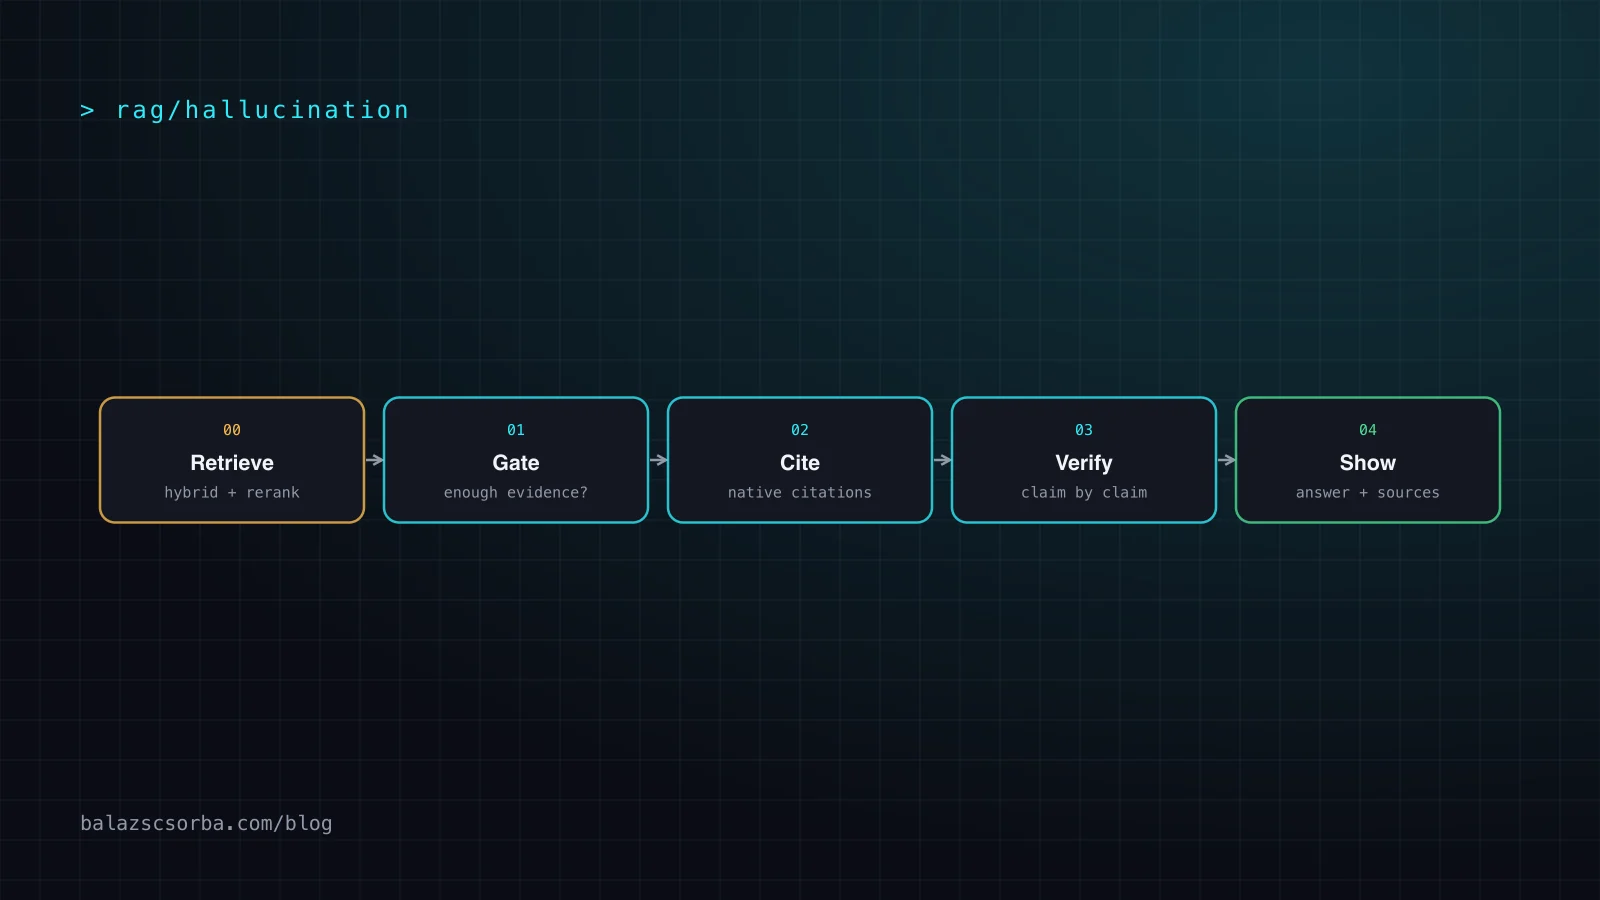
A pipeline: négy kapu, nem egy prompt
A groundingot kapuk sorozatának látom. Mindegyik elkap valamit, amit az előző nem tud, és mindegyik késleltetésbe és bonyolultságba kerül.
- Jó lekérés. A hibrid keresés és a reranking dönti el, hogy a megfelelő szakasz egyáltalán eljut-e a modellhez. A legtöbb „hallucináció”, amit debuggolok, retrieval-melléfogás, ahol a modell a rossz anyagból azt csinálta, amit tudott.
- Kapu az evidenciára. Ha a legjobb szakaszok gyengék, ne generálj; tartózkodj, és mondd meg, mi hiányzik.
- Generálás hivatkozásokkal. Használj natív hivatkozási mechanizmust, hogy minden állítás mutatót hordozzon az általad adott dokumentumba.
- Állításonkénti ellenőrzés. Ellenőrizd, hogy a hivatkozott szakasz alátámasztja-e a mondatot, amelyhez tartozik, és dobd el vagy jelöld, ami megbukik.
Ezután jön a megjelenítés, amely szintén kontroll: a felület dönti el, hogy az olvasó öt másodperc alatt ellenőrizheti-e a választ, vagy hinnie kell neki.
Első lépés: korlátozd a modellt arra, amit adtál neki
Az Anthropic hallucinációcsökkentő útmutatója néhány alaptechnikát sorol fel, amelyek annyira olcsók, hogy alapértelmezésben mindet használnám:
- Engedd meg a „nem tudom” választ. Kifejezetten engedélyezd a modellnek, hogy beismerje a bizonytalanságot. Az Anthropic szerint ez az egyszerű technika drasztikusan csökkentheti a téves információt.
- Hosszú dokumentumoknál előbb idézz. A nagyjából 20 000 tokennél hosszabb dokumentumoknál kérd, hogy a modell először szó szerinti idézeteket vonjon ki, és a válaszát csak ezekre alapozza.
- Korlátozd a külső tudást. Utasítsd a modellt, hogy csak a megadott dokumentumokat használja, ne az általános tudását.
- Piszkozat után ellenőrizz. Kérd, hogy a modell minden állításhoz keressen alátámasztó idézetet, és vonjon vissza minden állítást, amelyet nem tud igazolni.
Ugyanez az útmutató haladó lehetőségként említi a best-of-N összehasonlítást (futtasd többször ugyanazt a promptot, és az eltéréseket tekintsd figyelmeztetésnek) és az iteratív finomítást, és egy fenntartással zár, amelyet meg akarok ismételni: ezek a technikák jelentősen csökkentik a hallucinációt, de nem szüntetik meg, és a kritikus információt továbbra is validálni kell.
Saját gyakorlati kiegészítésem: a prompt-szabályokat gyenge rétegként kezeld. A prompt kéri, hogy a modell jól viselkedjen; a kapu vagy az ellenőrző megnézi, hogy tényleg így tett-e. A promptot az alapszint emelésére használd, a későbbi szakaszokat a maradék elkapására.
Második lépés: hivatkozás-API-t használj ahelyett, hogy szépen kérnéd
Megkérheted a modellt, hogy írjon „[1]”-et a mondatok után, és prototípusnak ez elég. Élesben a mutató a gond: a modellek hihető forrásneveket találnak ki, rosszul számoznak, vagy olyan szöveget idéznek, amely nincs a dokumentumban. A natív hivatkozási funkciók ezt a munkát a szabad szövegből az API-válaszba viszik át.
Anthropic: citations és search results
Az Anthropic citations funkciója három dokumentumtípussal működik, és a hivatkozás formátuma a típust követi:
| Dokumentumtípus | Chunkolás | A hivatkozás erre mutat |
|---|---|---|
| Egyszerű szöveg | Mondatok | Karakterindexek (0-tól) |
| Mondatok | Oldalszámok (1-től) | |
| Egyedi tartalom | Nincs további: a blokkjaid változtatás nélkül használódnak | Blokkindexek (0-tól) |
RAG-hoz maga a dokumentáció azt tanácsolja, hogy minden lekért chunkot tegyél egy egyszerű szöveges dokumentumba, vagy használj `search_result` tartalomblokkokat, amelyek forrást és címet hordoznak, és visszaadhatók a saját kereső eszközeidből, vagy közvetlenül a felhasználói üzenetbe tehetők. A hivatkozások ekkor azokon a szövegblokkokon jelennek meg, amelyek a tartalmadat használják, külön promptolás nélkül. Tapasztalatom szerint a „chunk dokumentumonként” megközelítés a legtisztább módja annak is, hogy a saját chunk-azonosítóid követhetők maradjanak a válaszban.
A termelésben számító részletek, mind a dokumentációból:
- Érvényes mutatók. Mivel az API maga értelmezi a hivatkozásokat és vonja ki a `cited_text` mezőt, a hivatkozások garantáltan érvényes mutatókat tartalmaznak az általad megadott dokumentumokra. Ez a kitalált hivatkozásokat szünteti meg, a félreolvasottakat nem.
- Költség. A citations bekapcsolása kissé növeli a bemeneti tokeneket, de a `cited_text` nem számít a kimeneti tokenek közé, így olcsóbb lehet, mint a modellel idéztetni.
- Caching. A forrásdokumentumok gyorsítótárazhatók `cache_control`-lal; a válaszokban lévő hivatkozásblokkok nem. Hogy mikor éri meg, azt a prompt cachingről és routingról szóló bejegyzésemben írtam le.
- Streaming. A hivatkozások `citations_delta` eseményekként érkeznek, eseményenként egy, az aktuális szövegblokkhoz csatolva.
- Korlátok. A citationst egy kérés összes dokumentumán vagy egyiken sem kell bekapcsolni, csak a szöveg hivatkozható (a kinyerhető szöveg nélküli szkennelt PDF-ek nem), és a structured outputtal való kombinálás 400-as hibát ad.
A funkció indulásakor az Anthropic azt közölte, hogy belső értékelései szerint a beépített hivatkozások a legtöbb saját megvalósítást akár 15 százalékkal megelőzik a recall pontosságban, egy ügyfél, az Endex pedig azt mondta, hogy a forrás-hallucinációk és formázási hibák aránya 10 százalékról 0-ra esett. Ezek szolgáltató által közölt számok konkrét felállásokra; indokként használnám a funkció kipróbálására, nem elvárható értékként.
Más szolgáltatók
Az Anthropic nem áll egyedül. Az OpenAI webkereső eszköze `url_citation` annotációkat ad vissza URL-lel, címmel és a szövegbeli pozícióval, és a dokumentáció előírja, hogy webes találatok megjelenítésekor a beágyazott hivatkozások legyenek jól láthatók és kattinthatók a felületen. A Cohere chat API-ja kezdő és záró pozíciót, a hivatkozott szöveget és a mögötte álló forrásdokumentumokat tartalmazó hivatkozás-objektumokat ad. A közös gondolat ugyanaz: a modell állítása és a bizonyítéka strukturált adatként együtt utazik, és a felületednek ezt tiszteletben kell tartania.
Egy szerkezeti fenntartás mindegyikre igaz: a modell dönti el, melyik szakaszra mutasson. A hivatkozás azt mutatja, mit csatolt a modell egy mondathoz, nem azt, hogy a mondat következik belőle.
Harmadik lépés: tervezd meg a „erre nem tudok válaszolni” utat
Ha a modell alapviselkedése a válaszadás, két helyen kell megszakítani.
Retrieval-kapu generálás előtt. Nézd meg a retrieval eredményét: nincs szakasz a hasonlósági vagy reranker-küszöb felett, nagy a rés a kérdés és a talált anyag között, vagy ellentmondanak egymásnak a legjobb szakaszok. Ilyenkor hagyd ki teljesen a modellhívást, és válaszolj azzal, mi hiányzik és mit tehet a felhasználó. Ez olcsóbb a generálásnál, és a legmegbízhatóbb tartózkodás is, mert nem függ a modell önértékelésétől. A küszöböt valós lekérdezéseken kalibráld, ne érzésre.
Engedély a promptban. Mondd meg a modellnek, hogy az „a dokumentumok ezt nem tartalmazzák” érvényes és kívánatos válasz, ha hiányzik az evidencia. Ez az engedély nélkül a benchmark-szerű ösztönzés a találgatásra tovább hat.
A tartózkodó választ a termék részeként tervezd meg:
- Mondd meg, mit kerestél és mit nem találtál, a puszta „nem tudom” helyett.
- Kínálj következő lépést: átfogalmazás, szűkítés, másik forrás keresése vagy átadás egy embernek.
- Engedj részleges választ: válaszold meg az alátámasztott részt, és jelöld egyértelműen az alá nem támasztottat.
- Számold. A tartózkodási arány olyan metrika, amelynek van egészséges tartománya; a nulla azt jelenti, hogy a rendszer találgat, a túl magas azt, hogy a kapu túl szigorú vagy a retrieval rossz.
Negyedik lépés: állítások ellenőrzése generálás után
A leginkább megbízható minta, amelyet ismerek a misgrounded válaszok elkapására, a válasz állításokra bontása és mindegyik ellenőrzése a bizonyítéka ellen. Ugyanaz az ötlet, mint a Ragas faithfulness-metrikája, amely a választ egyedi kijelentésekre bontja, ellenőrzi, hogy mindegyik levezethető-e a lekért kontextusból, és kiszámolja az alátámasztott állítások arányát.
Megépítheted magad egy második modellhívással, vagy használhatsz menedzselt ellenőrzőt:
| Opció | Mit csinál | Említésre méltó korlátok (a dokumentáció szerint) |
|---|---|---|
| Promptolt önellenőrzés (Anthropic-útmutató) | A modell állításonként keres alátámasztó idézetet, a többit visszavonja | Ugyanaz a modellcsalád ítéli meg a saját piszkozatát; plusz hívás |
| Google check grounding API | Állításokra bontja a választ, 0 és 1 közötti support score-t, hivatkozásokat és opcionális állításonkénti pontszámot ad | A válasz legfeljebb 4096 token, legfeljebb 200 tény; a részigazság alá nem támasztottnak számít; 500 ms alattiként dokumentált |
| Amazon Bedrock contextual grounding check | Forrás és kérdés ellen pontozza a groundingot és a relevanciát; a küszöb alattit blokkolja | Nem beszélgetéses QA-ra; a forrás legfeljebb 100 000 karakter; streamingnél az irrelevancia csak a válasz elküldése után jelölhető |
Három tervezési döntés minden alkalommal előkerül:
- Mi történik hiba esetén? Lehetőségek: újragenerálás a hibás állítás nélkül, a mondat eldobása, megtartása „nem ellenőrzött” jelöléssel, vagy az egész válasz megtagadása. Nagy téttel bíró területeken az eldobást vagy jelölést részesítem előnyben a néma újragenerálással szemben, mert a felhasználónak látnia kell, hogy valami el lett távolítva.
- Hol fut? A blokkoló ellenőrző késleltetést ad az első megjelenő token előtt, ha megvárod. Streaming felületeknél streameld a piszkozatot hivatkozásokkal, és frissítsd minden mondat állapotát, ahogy az ítéletek megérkeznek, vagy ellenőrizz streaming előtt azokban a kevés folyamatban, ahol a téves válasz drága. A szállítási oldalt a streaming LLM-funkciók Nuxtban bejegyzésem tárgyalja.
- Ki ellenőrzi az ellenőrzőt? Az ellenőrző modell vagy osztályozó, és hibázik. Címkézz fel kézzel néhány száz ítéletet, és kövesd az ellenőrző saját precision és recall értékét, különben csak egyik nem mért komponensről a másikra tetted át a bizalmat.
Technika és hatás
Így rangsorolom a technikákat aszerint, mit kezelnek valójában. Sorokra szándékosan nem adok százalékot: a hatás a korpuszodtól, a kérdéseidtől és a modelltől függ, és az egyetlen számok, amelyekben megbíznék, azok, amelyeket a saját tesztkészleteden mérsz.
| Technika | Célzott hiba | Költség | Hol csődöl még |
|---|---|---|---|
| Jobb retrieval (hibrid, rerank) | Rossz vagy hiányzó szakaszok | Fejlesztési idő; némi késleltetés | Hiányzó korpusz-tartalom, elavult dokumentumok |
| „Csak a dokumentumokat használd” prompt-szabályok | Válasz a modell emlékezetéből | Szinte semmi | A prompt kérés, nem garancia |
| Engedély a „nem tudom” kimondására | Kikényszerített találgatás | Nincs | Túlzott tartózkodás, ha nem teszteled |
| Retrieval evidencia-kapu | Generálás gyenge evidenciából | Egy kalibrálandó küszöb | Az erős, de irreleváns szakaszok átjutnak |
| Előbb idézés (quote-first) | Parafrázis-elcsúszás hosszú dokumentumoknál | Extra tokenek vagy egy lépés | Az idézeteket is lehet félreolvasni |
| Natív hivatkozások | Kitalált vagy érvénytelen hivatkozások | Kicsit több bemeneti token | Érvényes mutató, alá nem támasztott állítás |
| Állításszintű ellenőrzés | Misgrounded állítások | Extra hívás és késleltetés | Ellenőrző hibák; többlépéses következtetés |
| Forrás-első UI | Ellenőrizetlen bizalom | Dizájn- és frontend-munka | Akik soha nem kattintanak |
A faithfulness mérése
Mérés nélkül a cikk minden változtatása hit. Négy számot követnék egy rögzített értékelőkészleten, és CI-ban futtatnám őket, mint a unit teszteket (lásd termékfunkciók evaljai):
- Faithfulness: a lekért kontextus által támogatott állítások aránya, a Ragas definíciója szerint. Különbözik a helyességtől: egy rossz dokumentumból származó hű válasz téves.
- Hivatkozás precision és recall: a mutatott hivatkozások közül hány támasztja alá valóban a mondatot; az állítások közül hánynak van alátámasztó hivatkozása.
- Tartózkodás minősége: a korpuszból megválaszolhatatlan kérdéseknél milyen gyakran utasít el a rendszer; a megválaszolható kérdéseknél milyen gyakran utasít el tévesen.
- Válasz helyessége egy referenciaválasszal szemben, hogy a faithfulness ne legyen az egyetlen jel.
A készletet három csoportból építsd: megválaszolható kérdések ismert szakaszokkal, megválaszolhatatlan kérdések és adverzális kérdések (elavult információ, közel azonos dokumentumok, kérdések, amelyek a modellt a saját tudása használatára csábítják). A legtöbb csapat kihagyja a megválaszolhatatlan csoportot, és ezért a tartózkodási viselkedésüket soha nem tesztelik.
Források megjelenítése a felületen
A felület az utolsó védvonal, és az egyetlen, amelyet a felhasználó lát. Ezeket a mintákat használnám:
- Számozott beágyazott jelölők az általuk alátámasztott mondat mellett, nem egy linkblokk a végén. Az állításonkénti kapcsolat teszi lehetővé az ellenőrzést.
- Előnézet rámutatásra vagy koppintásra, a hivatkozott szakasszal és a dokumentum címével. Itt hasznos a `cited_text`, és ettől reális az ötmásodperces ellenőrzés.
- Mélylinkek, amelyek a forrást a hivatkozott helyen nyitják meg (oldalszám, horgony vagy kiemelt tartomány), nem egy 60 oldalas PDF elején.
- Látható ellenőrzési állapot mondatonként vagy válaszonként: ellenőrzött, nem ellenőrzött vagy eltávolított. Ha az ellenőrző eldobott valamit, mondd ki.
- Megtervezett tartózkodási állapot következő lépésekkel, ahogy fent, normál kimenetként, nem hibaként megformázva.
- Valóban kattintható és látható hivatkozások. Az OpenAI dokumentációja ezt a webes találatokra kötelezővé teszi, és bárhol jó szabály.
A Stanford-vizsgálat egyik figyelmeztetése a dizájnra is vonatkozik: a valódi, tekintélyesnek tűnő hivatkozások meggyőzőbbé teszik a téves választ. Ne hagyd, hogy egy lábjegyzet jelenléte nagyobb biztonságot sugalljon, mint amennyit az ellenőrzésed megalapoz. Ha az ellenőrződ nem futott le, ne jeleníts meg „ellenőrzött” jelvényt.
A mérnöki oldalra is figyelj: a hivatkozásos válaszok már nem sima szövegfolyamok. Simon Willison a funkció indulásakor rámutatott, hogy ez olyan absztrakciót kényszerít ki, amely a szöveg helyett annotált darabokból álló válaszokat kezel. A streaming protokollodat és az üzenettárolásodat kezdettől strukturált szegmensekre tervezd.
Ahol a hallucináció még átcsúszik
Mind a négy kapu után ezekre a hibákra számítanék még, és ezt tenném velük:
- Válasznak tűnő retrieval-melléfogások. Egy részben releváns szakasz átjut a kapun, és a modell kitölti a hiányt. Ellenszer: reranker-küszöbök és kifejezett ellenőrzés, hogy „megválaszolja-e ez a szakasz a kérdést”.
- Rossz vagy elavult források. A válasz hű egy elavult dokumentumhoz. Ellenszer: dokumentumdátum és verzió a metaadatokban, a felületen megjelenítve, valamint frissességi szűrők.
- Misgrounded hivatkozások. Az „érvényes mutató, alá nem támasztott állítás” probléma. Ellenszer: állításszintű ellenőrzés és mintavételes emberi átnézés.
- Szakaszokon átívelő következtetés. Az összegek, összehasonlítások és többlépéses következtetések szó szerint egyik szakaszban sincsenek benne, ezért az ellenőrzők nehezen kezelik őket. Ellenszer: a számokat kóddal számold, és mutasd a bemeneteket.
- Megmérgezett dokumentumok. Ha egy lekért dokumentum utasításokat tartalmaz, a modell követheti őket. A nem megbízható szövegre alapozás biztonsági kérdés; lásd a prompt injectiont és a lethal trifectát.
- Formátumkorlátok. A structured outputs és a citations az Anthropic API-n jelenleg nem kombinálható, ezért egy kinyerő pipeline-nak más grounding-stratégia kell, például ellenőrző menet a JSON-értékeken.
- Az ellenőrző vakfoltjai. Az ellenőrző mindkét irányban tévedhet. Mérd.
A hosszabb távú irány, amelyről a hibrid, ágenses és hosszú kontextusú RAG bejegyzésemben írok, ezt a problémát sem szünteti meg. Egy többször lekérdező ügynöknek több esélye van megtalálni a helyes szakaszt, és több esélye is arra, hogy egy téves következtetést láncoljon.
Ellenőrzőlista, amellyel ezen a héten elindulhatsz
- Add hozzá az „a dokumentumok ezt nem tartalmazzák” utasítást, és teszteld legalább 20 megválaszolhatatlan kérdéssel.
- Adj hozzá retrieval-kaput valós lekérdezéseken kalibrált küszöbbel; naplózz minden tartózkodást.
- Kapcsold be a natív citationst; tegyél minden chunkot saját dokumentumba vagy `search_result` blokkba, a source mezőben a saját azonosítóddal.
- Minden válaszhoz tárold a választ, a hivatkozott szakaszokat és a retrieval-pontszámokat.
- Adj hozzá állításszintű ellenőrzőt előbb mintán, majd azokban a folyamatokban, ahol a téves válasz pénzbe vagy bizalomba kerül.
- Kövesd a faithfulnesst, a hivatkozás precision és recall értékét és a tartózkodás minőségét CI-ban, rögzített értékelőkészleten.
- Mutass számozott, kattintható hivatkozásokat szakasz-előnézettel és látható ellenőrzési állapottal.
- Hetente nézz át kézzel egy véletlen mintát a hivatkozásos válaszokból, mert a hivatkozások utólag racionalizáltak lehetnek.
Ha csak egyet viszel magaddal: tedd olcsóvá a téves válaszok észrevételét. Az a rendszer, amely olykor téved, de megmutatja a bizonyítékait, eszköz; az, amely olykor téved, és magabiztosan hangzik, kockázat. Ha segítségre van szükséged egy ilyen pipeline megépítéséhez vagy átvilágításához, nézd meg az AI-mérnöki munkáimat.
Források
- Anthropic: Citations (Claude API documentation)
- Anthropic: Search results (Claude API documentation)
- Anthropic: Reduce hallucinations (Claude API documentation)
- Anthropic: Introducing Citations on the Anthropic API
- Simon Willison: Anthropic's new Citations API (24 January 2025)
- OpenAI: Web search guide (url_citation annotations and display requirement)
- Cohere: Documents and citations
- Google Cloud: Check grounding API
- AWS: Amazon Bedrock Guardrails contextual grounding check
- Ragas: Faithfulness metric
- Kalai, Nachum, Vempala, Zhang: Why Language Models Hallucinate (arXiv 2509.04664)
- Magesh et al.: Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools (arXiv 2405.20362)
- Wallat, Heuss, de Rijke, Anand: Correctness is not Faithfulness in RAG Attributions (arXiv 2412.18004)
Gyakori kérdések
Hogyan csökkenthető a hallucináció egy RAG-alkalmazásban?
Rétegezz több védelmet, ne egyre építs. Először a retrievalt javítsd, majd korlátozd a modellt a megadott dokumentumokra, engedd meg neki, hogy kimondja, nem tudja, kérd, hogy hivatkozzon a felhasznált szakaszokra, ellenőrizd minden állítást ezek ellen, és mutasd a forrásokat a felületen. Egyetlen réteg sem szünteti meg a hallucinációt; az Anthropic saját útmutatója szerint ezek a technikák jelentősen csökkentik, de nem iktatják ki.
Megszünteti a RAG a hallucinációt?
Nem. A Stanford és a Yale kereskedelmi jogi kutatóeszközökről szóló vizsgálatában a RAG-ot megoldásként hirdető termékek az esetek 17–33 százalékában hallucinált választ adtak. A tanulmány akkor számít egy választ hallucinációnak, ha téves vagy „misgrounded”, vagyis azt állítja, hogy egy forrás alátámaszt valamit, amit nem.
Mi a különbség a faithfulness és a helyesség között?
A faithfulness azt kérdezi, hogy a válasz minden állítását támogatja-e a lekért kontextus. A helyesség azt, hogy az állítás igaz-e a valóságban. Egy elavult dokumentumra épülő hű válasz téves, de faithful; a modell emlékezetéből származó, a dokumentumok által nem támogatott helyes válasz helyes, de nem faithful. RAG-nál általában mindkettőt akarod, és külön méred.
Hogyan működnek az Anthropic citations?
Dokumentumokat vagy search_result blokkokat adsz át bekapcsolt citationsszel, és a válasz szövegblokkjai hivatkozás-objektumokat hordoznak, amelyek a forrásaid karaktertartományaira, oldalszámaira vagy tartalomblokkjaira mutatnak. A cited_text mező nem számít bele a kimeneti tokenekbe, és az API garantálja a mutatók érvényességét. A citations nem kombinálható structured outputtal, és jelenleg csak szöveget fed le.
Mikor kell egy LLM-nek azt mondania, hogy „nem tudom”?
Amikor a lekért evidencia nem tartalmazza a választ. Két helyen valósítsd meg: egy retrieval-kapu, amely leállítja a generálást, ha a legjobb szakaszok gyengék, és egy prompt, amely kifejezetten megengedi a modellnek, hogy kimondja, a dokumentumok nem tartalmazzák az információt. Utána teszteld olyan kérdésekkel, amelyekre a korpuszod nem tud válaszolni, különben a viselkedést soha nem ellenőrzöd.
Hogyan mutassa a forrásait egy chatbot?
Számozott jelölők az általuk alátámasztott állítások mellett, a hivatkozott szakasz megjelenítése rámutatásra vagy koppintásra, link az eredeti dokumentum megfelelő pontjára, és jelölés azokra a válaszokra vagy mondatokra, amelyeket nem sikerült ellenőrizni. Soha ne mutass olyan hivatkozást, amelyről nem ellenőrizted, hogy valódi szövegre mutat, mert egy magabiztosnak tűnő lábjegyzet hihetőbbé teszi a téves választ.