Blog/RAG és keresés
Szemantikus termékkeresés B2B webshopokban: cikkszámok, hibrid keresés és amit mérned kell
Szemantikus keresés B2B shopban a cikkszámos keresés tönkretétele nélkül: BM25 és vektorok hibridje, szűrők, DE/EN/HU, LLM-es lekérdezés-értelmezés, reranking, mérőszámok.
Balázs Csorba··13 perc olvasás
- B2B search
- Hybrid search
- Semantic search
- Spryker
- OpenSearch
A lényeg röviden
- B2B-ben a cikkszám a legfontosabb keresés. Adj az azonosítóknak saját sávot normalizált pontos és előtag-egyezéssel, a szemantikus keresés pedig csak akkor segítsen, ha ez a sáv nem ad erős választ.
- A hibrid keresés (BM25 és vektorok, reciprocal rank fusionnel összefésülve) mindkét módszert felülmúlja, mert a vásárlók ugyanabba a mezőbe írják be a „10-32-4711”-et és a „csavar kültéri fához”-t.
- A választékot, az árlistát és a készletet pre-filterként kell a vektoros keresésbe tenni, nem post-filterként, különben eltűnnek a találatok, vagy ügyfelek között szivárognak.
- LLM-mel bontsd a kérdést terméktípusra, attribútumokra és mértékegységekre, ellenőrizd a kimenetet a katalógussal szemben, és a gyakori kérdéseket offline cache-eld, ne hívj modellt minden billentyűleütésre.
- A rendszert kérdéstípusonként értékeld: zero-result arány, keresésből kilépési arány és átkattintási arány, mellé egy kis kézzel értékelt kérdéskészlet, ahol a pontos azonosítóknak mindig az első helyen kell lenniük.
Egy szaniterkereskedés vásárlója beírja: „4711-32”. A második ezt: „rozsdamentes csavar kültéri fához”. A harmadik ezt: „hex bolt M8x40 A2”. Mindhárom ugyanazt a keresőmezőt használja, és a legtöbb általam látott B2B shopban legalább egyikük üres oldalt kap.
A szemantikus keresés a második és harmadik esetet ígéri megoldani. A kockázat, hogy az elsőt tönkreteszi. Ez a cikk azt mutatja meg, hogyan építenék szemantikus keresést egy B2B katalógusba úgy, hogy a pontos cikkszámos keresés megmaradjon: az architektúrát, a kérdéstípusokat, a hibrid fúziót, a szűrőket, a három nyelvet, a szinonimákat, az LLM-es lekérdezés-értelmezést, a rerankinget, a mérést, és hogy mindez mit jelent egy Elasticsearchre vagy OpenSearchre épülő Spryker shopnál.
Miért más a B2B keresés, mint a fogyasztói
A B2B kérdések változatosabbak, mint a fogyasztóiak. A vásárlók cikkszámot másolnak egy rajzról, begépelik a beszállítói számot egy régi rendelésből, rövidítik a szakmai szlenget, vagy felhasználási esetet írnak le. A fogyasztói shopokat vizsgáló Baymard nyolc keresőkérdés-típust különböztet meg, és azt találta, hogy a tesztelt oldalak 56%-a nem szolgálja ki megfelelően a felhasználók keresési igényeit. A B2B katalógusok ráadásul azonosító- és specifikációnehéz adatokat hoznak.
A gyakorlati következmény: egyetlen keresési módszer sem megfelelő mindenre. Ezzel a taxonómiával indulok egy projektben. A példák kitaláltak, de a minták megjelennek a valódi keresési naplókban.
| Kérdéstípus | Példa | Legjobb keresés | Tipikus hiba |
|---|---|---|---|
| Cikkszám vagy alkatrészszám | „4711-32”, „4711 32” | Azonosító sáv: normalizált pontos, majd előtag | A kötőjel és a szóköz megtöri a pontos egyezést; a vektoros ág hasonlókat ad |
| Beszállítói szám, EAN | „4006381333931” | Azonosító sáv külön mezőn | Számként tárolva, az elöl álló nullák elvesznek |
| Terméktípus | „Sechskantschraube” | Lexikális és vektoros, kategória-boost | Az összetett szavak és a többes számok mellémennek lexikálisan |
| Specifikáció | „M8x40 A2 DIN 933” | Szűrőkre bontva és lexikális | A beágyazások elmosják a számokat és mértékegységeket |
| Felhasználási eset | „csavar kültéri fához” | Vektoros és attribútumszűrők | A lexikális keresés nulla találatot ad |
| Rövidítés vagy szleng | „VA Schraube” | Szinonimák, majd vektor | Az analyzer nem ismeri a rövidítést |
| Nyelvek közötti | „hex bolt” német katalógusban | Többnyelvű vektor és szinonimák | A lexikális keresés nulla találatot ad |
| Nem termék | „szállítási idő”, „adatlap” | Súgó vagy CMS-tartalom felé irányítani | A termékindex véletlen termékeket ad |
Mielőtt bármit választasz, számold meg, hogy a valódi kérdéseid közül hány esik az egyes sorokba. Műszaki alkatrészek katalógusában az első két sor nagy hányadot tehet ki, és pont ezekben a szemantikus keresés semmit sem ad, és árthat is.
Az architektúra: sávok, fúzió, rerank
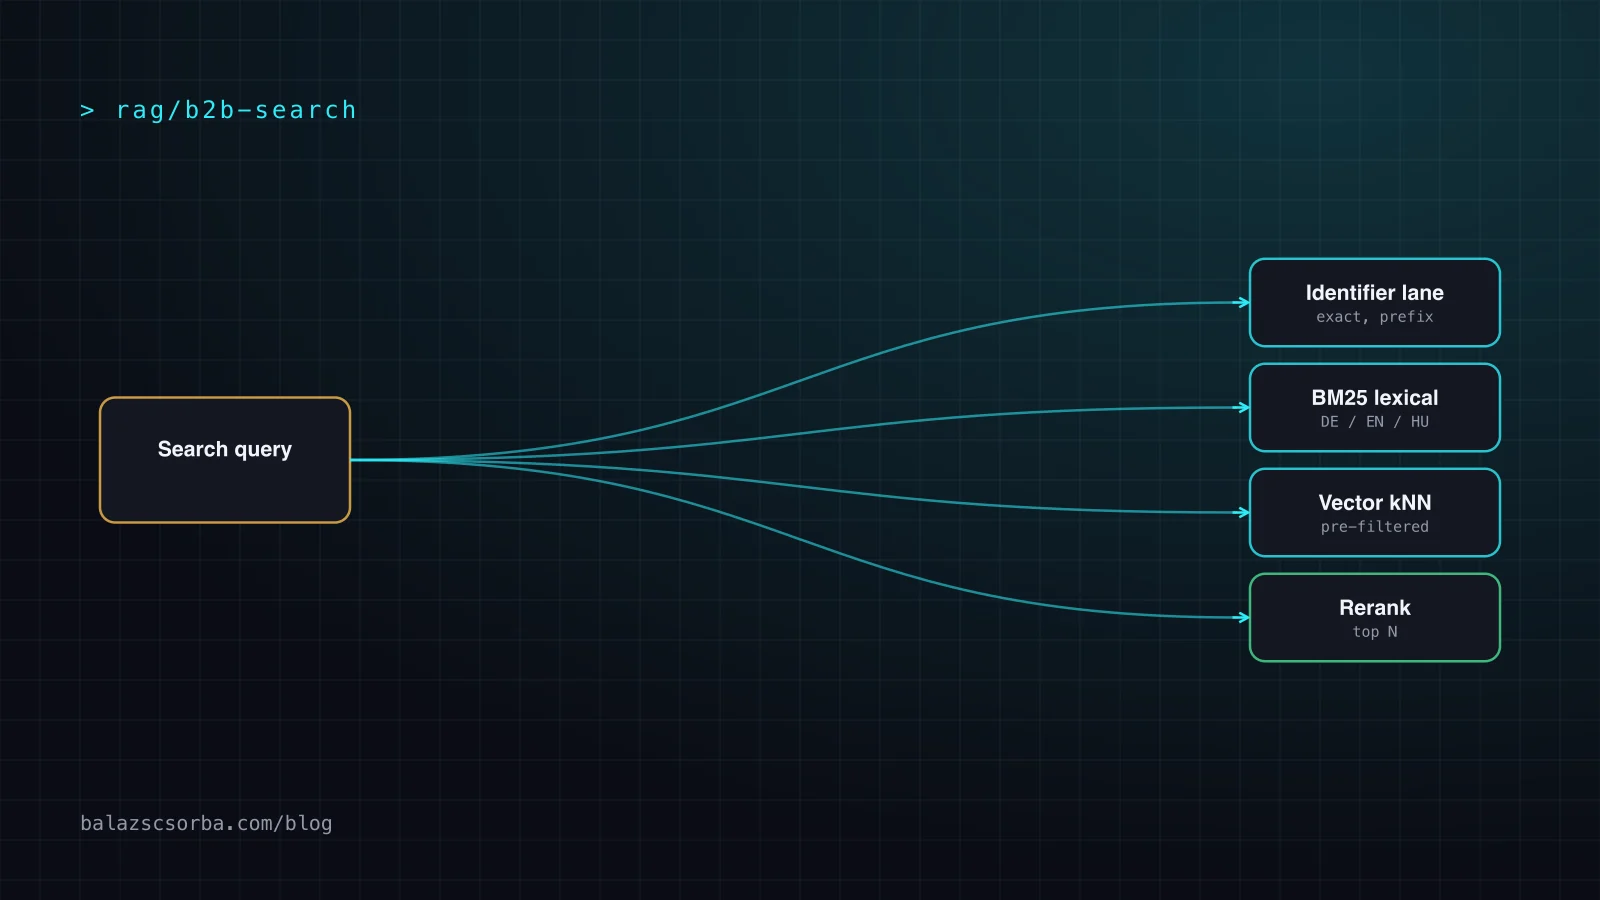
A referencia-tervemben egy belépési pont és három párhuzamos keresési sáv van. Egy olcsó értelmező lépés normalizálja a kérdést, és felismeri, hogy azonosítónak látszik-e. Az azonosító sáv, a lexikális BM25-lekérdezés és a vektoros kNN-lekérdezés ugyanazok alatt a szűrők alatt fut. A rangsoraikat összefésüljük, egy reranker csak a lista elejét rendezi újra, a válasz pedig tartalmazza a shop által igényelt facetteket.
Két tervezési döntés viszi a súly nagy részét. Először: az azonosító sáv nem a lexikális sáv egyik funkciója, hanem saját lekérdezés saját mezőkön, és a találatai rövidre zárhatják a többit. Másodszor: a szűrők minden sáv előtt állnak, mert B2B-ben nem egyszerűen facettek, hanem jogosultságok.
Motornak az Elasticsearch és az OpenSearch egyaránt megfelel. Mindkettő támogatja a BM25-öt, a közelítő kNN-t és a rangfúziót. Azt választanám, amit a platformod már üzemeltet, és nem vezetnék be második keresőmotort, amíg az elsőt ki nem nőtted.
A cikkszámok és a pontos egyezés az első
A B2B keresés tönkretételének legolcsóbb módja, ha egy szemantikus modellre bízod, mennyire hasonló két alkatrészszám. Egy beágyazás szemében a „4711-32” és a „4711-33” szinte azonos, egy vásárlónak két különböző alkatrész. Ezért az azonosítók külön kezelést kapnak.
Ezt teszem az azonosító sávba:
- Dedikált keyword mezők a cikkszámnak, a gyártói számnak, a beszállítói számnak, az ügyfélspecifikus számnak és az EAN-nak, mindig szövegként tárolva.
- Egy normalizer, amely indexeléskor és kereséskor is kisbetűsít, és eltávolítja a kötőjeleket, pontokat, perjeleket és szóközöket, így a „4711-32”, a „4711 32” és a „471132” ugyanabban az alakban találkozik.
- Először pontos, utána előtag. A teljes egyezés az előtag-egyezés fölé kerül, így aki az első számjegyeket írja, jelölteket lát, aki a teljes számot, az egyetlen terméket kapja.
- Rövidre zárás. Ha a normalizált kérdés pontos azonosító-találat, add vissza, anélkül hogy a vektoros ágra vagy a rerankerre várnál.
Légy óvatos a helyetted tokenekre bontó analyzerekkel. Az Elasticsearch word delimiter graph szűrője betű-szám átmeneteknél is vághat, így az „XL500” „XL” és „500” lesz. Ez segít a modellnevek szabad szöveges egyeztetésében, azonosítóknál viszont káros, ami újabb ok arra, hogy külön mezőkben, saját elemzéssel tartsd őket.
Hibrid keresés: BM25 és vektorok, rang szerint összefésülve
A lexikális keresés pontos az általa ismert szavakon. A vektoros keresés jelentést talál olyan szavak között, amelyek sosem fordultak elő együtt. Az Elastic a hibrid keresést gyakran a két rész összegénél sokkal jobbnak írja le, és két fúziós módszert nevez meg: a normalizált pontszámok konvex kombinációját, valamint a reciprocal rank fusiont (RRF), amely az egyes listákban elfoglalt helyet használja, ezért nem kell pontszám-normalizálás.
RRF-fel indulok. A BM25-pontszámok és a vektorhasonlóságok eltérő skálán élnek, a súlyozott összeghez pedig normalizálás kell, amelyet könnyű elrontani, és a katalógus változásával elcsúszik. Az RRF listánként 1/(k + rang) értéket ad hozzá, így a skáláknak sosem kell egyezniük. Az OpenSearch ugyanezt a score ranker processzoron keresztül kínálja, amely a 2.19-ben jelent meg, 1 és 10 000 közötti rank constanttal: a nagyobb konstans elsimítja a felső helyezések hatását, a kisebb előnyben részesíti őket. Van mellé normalization processor is min-max, L2 és z-score technikával, ha pontszám-alapú fúziót szeretnél.
Két dolgot hangolj, miután az első változat működik: a rangablakot (hány jelöltet ad egy sáv) és a sávonkénti súlyt. Mindkettő olcsó kísérlet egy értékelt kérdéskészlettel szemben, amelyre az értékelésről szóló részben visszatérek.
Egy hibamód külön figyelmeztetést érdemel. Pontos azonosító-kérdésnél a vektoros ág is ad valamit, és a fúzió egy majdnem találatot a helyes alkatrész fölé tolhat. Ezért zár rövidre az azonosító sáv, és ezért kell az értékelt készletben olyan azonosító-kérdéseknek lenniük, amelyek az első helyet ellenőrzik.
Attribútumtudatos szűrés, és miért kell struktúra a számoknak
A szűrők B2B-ben nem kozmetikák. Egy vásárló csak a megtárgyalt választékát, az árlistáját és azt láthatja, ami a címére szállítható. Ha a vektoros keresés után szűrsz, a tíz legközelebbi terméket kéred, majd eldobod azokat, amelyeket az ügyfél nem vásárolhat, és rövid vagy üres lista marad. Az Elasticsearch kNN query dokumentációja leírja a különbséget: a pre-filter a közelítő keresés közben érvényesül, így k egyező dokumentum jön vissza, a post-filter utána fut, és k-nál kevesebb találatot adhat, akkor is, ha van elég egyező.
A választék, az elérhetőség, a nyelv és a láthatóság ezért pre-filterként kerül minden sávra. Ezt biztonsági tulajdonságnak tekintem, nem relevanciarészletnek: a jogosultsági szűrő nélküli vektoros sáv olyan termékeket mutathat, amelyeket az ügyfél nem láthat.
A beágyazások gyengék a számokon és mértékegységeken. Az „M8x40” és az „M8x50” szinte ugyanoda esik, az „1,5 hüvelyk” és a „38 mm” pedig alig hasonlít. Specifikációknál a kérdést strukturált attribútumokra bontom (menetméret, hossz, anyag, szabvány), és szűrőként vagy boostként alkalmazom azokon az attribútummezőkön, amelyeket a PIM-ed amúgy is karbantart. A vektoros ág ekkor a mondat bizonytalan részét kezeli, a felhasználási esetet és a terméktípust, az attribútumok pedig a pontos részt.
Német, angol és magyar egy katalógusban
Egy többnyelvű katalógus három külön problémát hoz. A német hosszú összetett szavakat képez, így a „Sechskantschraube” lexikálisan nem feltétlenül talál rá a „Schraube” szóra. A magyar erősen ragozó, ezért a vásárló által begépelt alak nem biztos, hogy egyezik a terméktextben szereplővel. Az angol kérdések egy német katalógusban lexikálisan semmit sem találnak, mert nincs közös szó.
A megközelítésem a két világ kombinálása. A lexikális elemzés nyelvenként fut, az adott nyelvnek szükséges szótöveződéssel és összetett szavak kezelésével, locale-onkénti külön mezőkön. A vektoros ág egy többnyelvű modellt használ, hogy az egyik nyelven feltett kérdés egy másik nyelven leírt terméket is megtalálhasson. A BGE-M3 tanulmány ilyen modellt ír le, több mint 100 munkanyelven végzett szemantikus kereséssel és legfeljebb 8192 tokenes bemenettel. Én ettől még két-három jelöltet összemérnék a saját kérdéseimen, mert a katalógus szókincse messze áll az általános szövegtől.
Két gyakorlati szabály. Azt a szöveget ágyazd be, amelyet a vásárló felismer, vagyis a címet, a kulcsattribútumokat és egy rövid leírást, ne a teljes adatlapot. És minden mérőszámot nyelvenként jelents, mert a három nyelv átlaga elrejti azt az egyet, amelyben a keresés elromlott.
A szinonimák és az alkatrészszámok továbbra is számítanak
A vektorok nem szüntetik meg a szinonimák szükségességét, csak csökkentik. A szakmai rövidítéseket, márkarövidítéseket, a régi és új terméknevet és a beszállítói számokat továbbra is explicit szabályokkal kezelni a legjobb, mert elolvashatod, tesztelheted és visszavonhatod őket. Az Elasticsearch synonym graph szűrőjét csak kereső analyzerekhez tervezték, updateable jelöléssel újraindexelés nélkül újratölthető, és kezelt szinonimakészletekből veszi a szabályokat (alapértelmezésben készletenként legfeljebb 100 000 szabály).
A szinonimák legjobb forrása a saját zero-result naplód. Hetente nézd át a leggyakoribb sikertelen kérdéseket, döntsd el, hogy hiányzó szinonima, hiányzó termék vagy olyasmire irányuló kérdés-e, amit nem árulsz, és rögzítsd a döntést. Ez a kis rituálé többet ér bármely modellfrissítésnél, és tiszta kiindulópontot ad a vektoros ágnak, amelyet felül kell múlnia.
Lekérdezés-értelmezés LLM-mel
Az LLM a középső lépésben jó: a „rozsdamentes hatlapfejű csavar 8 szor 40 kültérre” kérdést strukturált lekérdezéssé alakítja terméktípussal, anyaggal, menetmérettel, hosszal és nyelvvel. Keresőmotornak gyenge. Szigorú kimeneti sémájú parserként használom (lásd a típusos döntésekről és az LLM-funkciók kiértékeléséről szóló írásaimat), és semmi másra.
Az Instacart beszámolója a lekérdezés-értelmezés LLM-ekkel való újraépítéséről hasznos referencia a mintához. A katalógus taxonómiáját beletették a promptokba, guardraileket adtak, amelyek szemantikus hasonlósággal ellenőrzik a kimeneteket, az eredményt pedig egy kisebb, finomhangolt modellbe desztillálták. A gyakori kérdéseket offline cache-ből szolgálták ki, csak a ritka farok ment valós idejű modellhez, így 300 ms-os késleltetési célt értek el. Ez fogyasztói élelmiszeres eset, de a forma átvihető B2B-re.
- Ellenőrizd a katalógussal. Ha az LLM olyan anyagot, attribútumértéket vagy alkatrészszámot ad vissza, amely nincs az adataidban, dobd el. Soha ne hagyd, hogy azonosítókat találjon ki.
- Cache-eld a gyakori kérdéseket. A B2B kérdéseloszlás rövid fejű, ezért egy éjszakai batch a top kérdéseken kiveszi a valós idejű hívások nagy részét.
- Állíts be késleltetési keretet és fallbacket. Ha a parser késik vagy hibázik, fusson az egyszerű hibrid lekérdezés. A keresés sosem eshet ki azért, mert egy modell lassú. Lásd a költség- és késleltetés-routingról szóló írásomat.
- Tartsd távol az azonosítóktól. Ha az azonosító sávnak pontos találata van, a parsert meg sem hívjuk.
A parsolt mezőket tippként kezeld, ne igazságként. A parsolt attribútumra tett boost megbocsátó, egy rosszul parsolt attribútumra tett kemény szűrő viszont találat nélküli oldalt eredményez, ezért boosttal kezdek, és egy attribútumot csak akkor léptetek elő szűrővé, ha a parse-pontossága bizonyított.
A lista elejének újrarangsorolása
A fúzió tisztességes listát ad, a reranker az első tízet teszi jobbá. Az Elastic szemantikus rerankingről szóló dokumentációja elmagyarázza a kompromisszumot: a cross-encoder a kérdést és a dokumentumot együtt olvassa, és jobban ítéli meg a relevanciát, nagyobb modellek, nagyobb késleltetés és több számítás árán. Ezért jelöltek ablakán (a rank window size-on) fut, nem a teljes találati halmazon, és ezért kínál a dokumentáció módokat a küldött tokenek korlátozására, mivel a hosszú dokumentumok levágódhatnak, mielőtt a modellhez érnek.
Csak nem azonosító kérdésekre alkalmaznám, talán a top 50-100 jelöltet rangsorolnám újra, és rövid terméktextet küldenék, nem az adatlapot. Utána jönnek az üzleti jelek: elérhetőség, az ügyfél korábbi rendelései, preferált beszállítók. Az általános keresés-és-rerank mintáról bővebben a RAG-pipeline cikkem szól.
Értékelés: zero result, kilépések és egy értékelt készlet
Mérés nélkül a szemantikus keresés demó. Egy kis mérőszámkészletet követek, mindig kérdéstípus és nyelv szerint bontva.
| Mérőszám | Mit mond neked | Csapda |
|---|---|---|
| Zero-result arány | A találat nélküli keresések aránya; az analitikai eszközök, például az Algolia no results rate néven jelentik | A szemantikus keresés úgy csökkenti, hogy hulladékot ad vissza; az átkattintással együtt olvasd |
| Keresésből kilépési arány | Azon keresések aránya, amelyek után a látogató elmegy (saját definícióm: nincs kattintás, nincs finomítás, a munkamenet véget ér) | Saját eseménykövetés kell hozzá; a botok és a könyvjelzők zajt adnak |
| Átkattintási arány | Azon keresések aránya, ahol legalább egy találatra kattintottak | Pozíciótorzítás: egy jobb első találat növeli, egy rossz a görgetés alatt rejtőzik |
| Újrafogalmazási arány | Azon keresések aránya, amelyeket ugyanabban a munkamenetben újabb kérdés követ | Némi újrafogalmazás egészséges finomítás |
| Első helyes találat az azonosítóknál | Értékelt készlet: a pontos alkatrész van-e az élen | 100% kell maradnia; minden visszaesés regresszió |
Az értékelt készletet a legtöbb csapat kihagyja. Néhány száz valódi kérdést veszek a naplókból, az első táblázat kérdéstípusai szerint rétegezve, és rögzítem, mely termékek helyesek. Az azonosító-kérdések pontosan az első helyet ellenőrzik, a leíró kérdések azt, hogy egy releváns termék a top tízben van. Futtasd minden analyzer-, szinonima-, beágyazás- vagy fúziós beállítás változtatásakor, lehetőleg CI-ban.
Ezután jön egy A/B-teszt éles forgalmon, amely kérdéstípusonként veti össze az átkattintást, a keresésből kosárba tételt és a keresésből kilépési arányt. Egy találat nélküli kérdés néha helyes, mert az alkatrész nincs a kínálatban, ezért ne a nulla felé hajszold az arányt, hanem azon zero-result kérdések számát, amelyeknek találnia kellett volna valamit.
Integráció Sprykerrel, Elasticsearchcsel és OpenSearchcsel
A Spryker alapértelmezett keresőként Elasticsearchcsel érkezik, és indexeli a termék nevét, leírását és SKU-ját, a termékattribútumokat, az értékeléseket és a CMS-oldalakat. A dokumentáció harmadik féltől származó keresőintegrációkat és egy tutorialt is leír tetszőleges keresőmotor integrálásához, valamint egy OpenSearch-migrációs utat az 1.3-ról a 2.19-en át a 3.5-re. Ez a frissítés itt azért számít, mert a hibrid fúzióhoz OpenSearchben friss verzió kell.
Az általam javasolt integráció tervjavaslat, nem Spryker-funkció, és négy lépésből áll. Számíts beágyazást minden abstract termékhez és locale-hoz a publish-and-sync folyamatban, amely a keresési dokumentumokat építi, és tárold egy vektormezőben a szövegmezők mellett. Bővítsd a keresőlekérdezést úgy, hogy az azonosító, a lexikális és a vektoros klauzulát a shop meglévő szűrői alatt adja ki, és fésüld össze őket RRF-fel. Tedd az LLM-parsert elé, timeout mögött. Az egészet csomagold feature flagbe store-onként és locale-onként.
Két fenntartás ezeken a platformokon szerzett tapasztalatból. A vektorok növelik az index méretét és a publikálási időt, ezért méretezd ennek megfelelően a klasztert, és csak akkor ágyazz újra, ha a beágyazott szöveg változik. És tartsd meg a meglévő keresést fallback útvonalként: ha a vektoros sáv nem elérhető, a shop továbbra is válaszoljon a lexikális és az azonosító sávon át.
Ha nulláról építesz, alternatíva egy hosztolt keresőtermék, és a Spryker dokumentál integrációkat erre az útra. Bármely szállítótól ugyanezt a négy dolgot követelném: azonosítókezelés, jogosultsági pre-filterek, nyelvenkénti mérőszámok és lehetőség az értékelt készleted futtatására.
Bevezetési ellenőrzőlista
Ebben a sorrendben dolgoznék.
- Exportálj három hónapnyi keresési naplót, és sorold a kérdéseket az első táblázat típusaiba. Számold meg őket.
- Építsd fel az értékelt készletet olyan azonosító-kérdésekkel, amelyek az első helyet ellenőrzik, és mérd a jelenlegi keresést kiindulópontként.
- Javítsd a lexikális alapokat: azonosítómezők normalizerrel, nyelvenkénti analyzerek, karbantartott szinonimakészlet.
- Add hozzá a vektoros sávot többnyelvű modellel, jogosultsági pre-filterekkel és RRF-fúzióval, feature flag mögött.
- Zárd rövidre az azonosító-találatokat, hogy a vektoros ág és a reranker sosem érjen hozzájuk.
- Add hozzá az LLM-parsert séma-validációval, offline cache-sel a gyakori kérdésekre, timeouttal és boost-first szabállyal.
- Adj hozzá rerankert kis ablakon a nem azonosító kérdésekre, és ellenőrizd a késleltetést p95-ön.
- Futtass A/B-tesztet, vesd össze a mérőszámokat kérdéstípusonként és nyelvenként, és hetente nézd át a zero-result naplót.
Az ilyen projektek nyereségének nagy része a 3. és 4. lépésből jön, nem a legdivatosabb modellből, a bizalmat pedig a 2. lépés teremti. Először tedd unalmasan megbízhatóvá az azonosító sávot, és a szemantikus keresés fejlesztésnek fog tűnni, nem kockázatnak.
Források
- Baymard Institute: E-commerce search query types
- Elastic Search Labs: Hybrid search in Elasticsearch
- Elasticsearch documentation: kNN query (pre-filters and post-filters)
- Elasticsearch documentation: Semantic reranking
- Elasticsearch documentation: Word delimiter graph token filter
- Elasticsearch documentation: Synonym graph token filter
- OpenSearch documentation: Score ranker processor (RRF)
- OpenSearch documentation: Normalization processor
- Spryker documentation: Search feature overview
- Spryker documentation: Migrate from OpenSearch 1.3 to 3.5
- Instacart via ZenML: Rebuilding query understanding for e-commerce search with LLMs
- arXiv: M3-Embedding, multilingual, multi-functionality, multi-granularity text embeddings
- Algolia documentation: Search analytics metrics
Gyakori kérdések
Mi az a szemantikus keresés a B2B e-kereskedelemben?
A szemantikus keresés a termékszövegeket és a kérdéseket vektorokká alakítja, így a „csavar kültéri fához” kérdés közös szavak nélkül is megtalálja a megfelelő termékeket. B2B shopban kiegészítenie kell a lexikális keresést, nem helyettesítenie, mert a cikkszámokhoz, EAN-kódokhoz és pontos specifikációkhoz továbbra is pontos egyezés kell.
Mi a hibrid keresés, és miért kell a B2B shopoknak?
A hibrid keresés párhuzamosan futtat egy lexikális (BM25) és egy vektoros lekérdezést, majd összefésüli a két rangsort, gyakran reciprocal rank fusionnel. A B2B shopoknak azért kell, mert a vásárlók keverik a pontos azonosítókat és a természetes nyelvű leírásokat, és egyik módszer sem kezeli mindkettőt jól egyedül.
Hogyan marad pontos a cikkszámos keresés vektoros keresés mellett?
Az azonosítókat külön mezőkben indexeld egy normalizerrel, amely eltávolítja a kis- és nagybetűk közti különbséget, a kötőjeleket, pontokat és szóközöket, először pontosan és előtag alapján egyeztess, és ezeket a találatokat rangsorold a vektoros ág bármely eredménye fölé. Azonosítóknál ne a beágyazásokra építs, mert azok a hasonlónak látszó számokat hasonlónak tekintik.
Működik a szemantikus keresés német, angol és magyar katalógusra?
Igen, többnyelvű beágyazási modellel és nyelvenkénti szövegelemzéssel. Az olyan többnyelvű modellek, mint a BGE-M3, több mint 100 nyelvet fednek le, de a német összetett szavakat és a magyar ragozást a saját kérdéseiden tesztelned kell, az eredményeket pedig nyelvenként mérned.
Hogyan mérem, hogy javult-e a termékkeresés?
Szegmentálj kérdéstípus szerint, és kövesd a zero-result arányt, a keresésből kilépési arányt, az átkattintási arányt és a keresésből kosárba tételt. Egészítsd ki egy offline készlettel az értékelt kérdésekből, ahol minden pontos azonosítónak az első helyen kell lennie. A csökkenő zero-result arány önmagában elrejtheti a lényegtelen találatokat, ezért mindig az átkattintás mellett olvasd.
Hozzáadhatok szemantikus keresést Sprykerhez?
Igen. A Spryker alapból Elasticsearchcsel érkezik, és dokumentál egy OpenSearch frissítési utat, így publikáláskor vektormezőket adhatsz a keresési dokumentumokhoz, a keresőlekérdezést pedig kiegészítheted vektoros klauzulával. Pilotként építeném meg feature flag mögött, és összevetném a meglévő kereséssel.