Blog/LLMOps és értékelés
Saját LLM-üzemeltetés a GDPR miatt: mikor kell és mibe kerül
Saját LLM a GDPR miatt: mikor kell, mennyi GPU-memória kell a nyílt modellekhez, az EU-s árak 2026 októberében és a break-even millió tokenenként.
Balázs Csorba··10 perc olvasás
- Self-hosting
- GDPR
- vLLM
- GPU cost
- Open-weight models
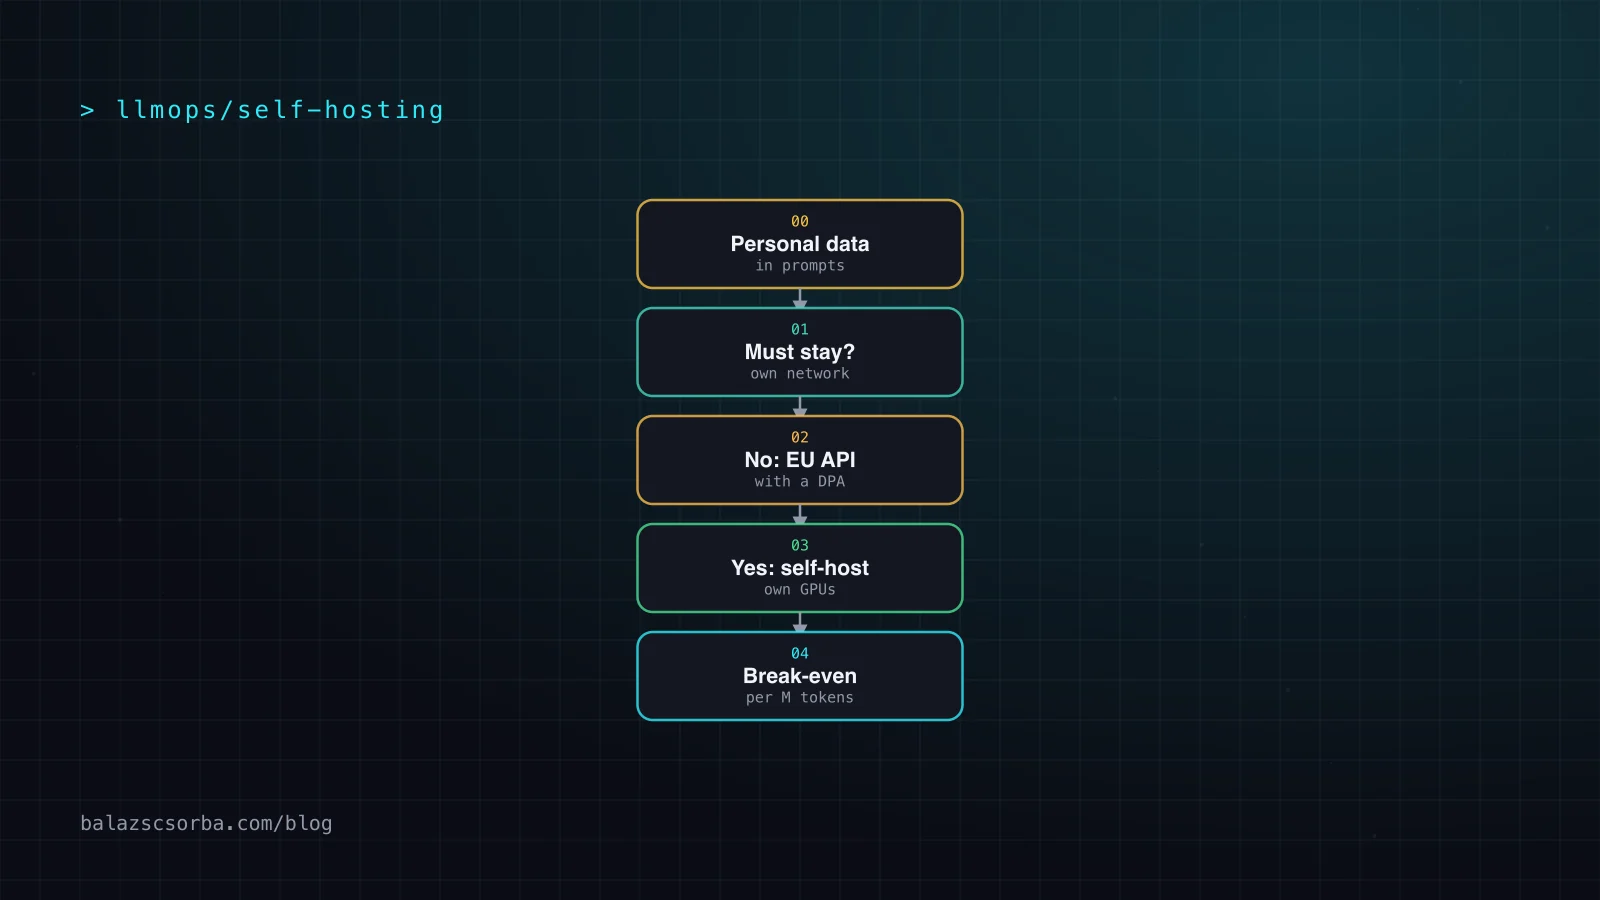
A lényeg röviden
- Saját üzemeltetést csak akkor válassz, ha a személyes adatoknak a te irányításod alatt álló hálózaton belül kell maradniuk, vagy ha szerződés vagy hatóság kizár minden olyan feldolgozót, amelyet nem tudsz ellenőrizni.
- Egy EU-ban üzemeltetett API adatfeldolgozási szerződéssel (DPA), rövid megőrzéssel és az adataid tanítás nélkül sok B2B szöveges feladatot lefedhet.
- A bérelt GPU nem szünteti meg a feldolgozót: a hosting cégnek is kell DPA. A saját üzemeltetés tehát a feldolgozót áthelyezi, nem megszünteti.
- A súlyokhoz milliárd paraméterenként nagyjából 2 GB kell 16 bites pontossággal, 1 GB 8 bitnél és 0,5 GB 4 bitnél, a KV-cache nélkül.
- Az EU-s API-árak mellett egy bérelt H100 csak nagy kihasználtságnál éri meg az API-t, és az üzemeltetés költsége még rákerül.
- Mérd meg az áteresztőképességet a saját promptjaiddal a vllm bench serve paranccsal, mielőtt hardvert vennél vagy bérelnél, mert a közzétett értékek erősen eltérnek.
Sokan szeretnének adatvédelmi okokból saját nyelvi modellt üzemeltetni, de a legtöbb B2B szöveges feladathoz ez nem szükséges. A GDPR nem tiltja a harmadik fél feldolgozóit. Szerződést kér minden feldolgozóval, jogalapot minden továbbításhoz, és kockázatos feldolgozásnál dokumentált kockázatelemzést. Egy EU-ban üzemeltetett API adatfeldolgozási szerződéssel (DPA) teljesítheti ezeket a követelményeket. A saját üzemeltetés akkor a helyes válasz, ha a személyes adatoknak a te irányításod alatt álló hálózaton belül kell maradniuk, vagy ha szerződés vagy hatóság kizár minden olyan feldolgozót, amelyet nem tudsz ellenőrizni. Ilyenkor a GPU-számla a könnyebben tervezhető rész – a pénz nagy része az üzemeltetésbe megy.
Ez a cikk 2026. október 10-én ellenőrzi a számokat, és csak olyan oldalakra támaszkodik, amelyeket meg tudtam nyitni. Bemutatja, mikor kötelező a saját üzemeltetés, mennyi GPU-memória kell a nyílt súlyú modelleknek az egyes pontossági szinteken, mibe kerülnek az EU-s GPU-k, mit nyújt a vLLM, egy millió tokenre vetített break-even számítást az EU-s API-kkal szemben, és a bevezetés utáni költségeket.
Mikor kell valóban saját üzemeltetés
A kérdés nem az, hogy a modell fut-e a te hardveredén, hanem az, hogy a személyes adatoknak ott kell-e maradniuk. Három helyzet terel saját modell felé:
- Szerződés tiltja. Egyes ügyfélszerződések és belső szabályzatok kizárják azokat az alfeldolgozókat, amelyeket nem irányítasz, vagy előírják, hogy az adatok soha ne hagyják el a meghatározott hálózatot.
- A hatásvizsgálatod nemet mond. Az adott felhasználási esetre készült adatvédelmi hatásvizsgálat szerint egy feldolgozói lánc kockázata túl nagy, például egészségügyi adatoknál vagy munkavállalói nyilvántartásnál.
- Nincs megfelelő szolgáltató. Egyetlen EU-s szolgáltató sem kínálja a modellt a szükséges feltételekkel, vagy a rendszernek offline kell futnia, például a gyártósoron vagy az edge-en.
Minden más feldolgozói kérdés, és erre egy EU-s API válaszol. A 28. cikk olyan szerződést ír elő, amely rögzíti a feldolgozás tárgyát és időtartamát, jellegét és célját, a személyes adatok típusait és az érintettek körét, valamint az adatkezelő kötelezettségeit és jogait. Előírja azt is, hogy az alfeldolgozókhoz előzetes írásbeli hozzájárulás kell, akár egyedi, akár általános formában, és ugyanezek a kötelezettségek rájuk is átszállnak. A 44. cikk minden harmadik országba irányuló továbbítást a rendelet továbbítási fejezetének feltételeihez köt. Az Európai Bizottság 2023. július 10-i megfelelőségi határozata az EU–USA adatvédelmi keretrendszerben (Data Privacy Framework) tanúsított amerikai cégekre a továbbítások alapját adja.
A saját üzemeltetés a modellkérdést sem oldja meg. Az Európai Adatvédelmi Testület (EDPB) 28/2024. számú véleménye, amelyet 2024. december 17-én fogadtak el, szerint a személyes adatokkal tanított AI-modellek nem minden esetben tekinthetők anonimnak. Az anonimitásra hivatkozást ezért esetenként kell megítélni. Kérdezd meg a szolgáltatótól a tanítóadatokra vonatkozó dokumentációt, mielőtt egy ilyen állításra támaszkodnál.
Modellméretek és GPU-memória kvantálással
A súlyok memóriaigénye egyszerű számítás: paraméterek száma szorozva a bitekkel súlyonként, osztva nyolccal. Egy 70 milliárd paraméteres modell nagyjából 140 GB-ot igényel 16 biten, 70 GB-ot 8 biten és 35 GB-ot 4 biten (saját számítás). Ebbe nem tartozik bele a KV-cache, amely a kontextushosszal és a párhuzamos kérésekkel nő, sem a futtatókörnyezet saját terhelése. Alapértelmezés szerint a vLLM a GPU-memória 92 százalékát használhatja (gpu_memory_utilization, az aktuális dokumentációban 0,92), a KV-cache pedig azt kapja, amit a súlyok meghagynak.
| Modell | Méret, összes / aktív | Pontosság | Súlyok, GB | Szükséges hardver |
|---|---|---|---|---|
| gpt-oss-20b | 21 Mrd / 3,6 Mrd | MXFP4, ahogy megjelent | 16 alatt, a kártya szerint | 16 GB GPU-memória, a kártya szerint |
| Mistral Small 3.2 | 24 Mrd, sűrű | bf16 | 48 (saját számítás); a kártya szerint kb. 55 | egy 80 GB-os kártya, a cache-nek marad hely (saját számítás) |
| Llama 3.3 70B | 70 Mrd, sűrű | bf16 / FP8 / 4 bit | 140 / 70 / 35 (saját számítás) | két 80 GB-os kártya bf16-on; egy 96 GB-os kártya FP8-on; egy 48 GB-os kártya 4 biten (saját számítás) |
| gpt-oss-120b | 117 Mrd / 5,1 Mrd | MXFP4, ahogy megjelent | a kártyán nincs megadva | egy 80 GB-os GPU, a kártya szerint |
| Mistral Large 3 | 675 Mrd, összes | FP8 / 4 bit | 675 / kb. 340 (saját számítás) | több mint 8 × 80 GB FP8-on; kb. 340 GB 4 biten nyolc 80 GB-os kártyára fér (saját számítás) |
Két tanulság a táblázatból. Egy 80 GB-os kártyán egy 70B-s modell 8 biten, miután a vLLM a maga részét elvette, csak néhány gigabájtot hagy a cache-nek (saját számítás), ezért tervezz két kártyát vagy egy 96 GB-os kártyát. A futtatható modell attól függ, mennyi memóriát tudsz bérelni, ezért ellenőrizd a memóriát, mielőtt benchmarkot olvasol.
GPU-opciók és árak 2026. október 10-én
Ezek azok az árak, amelyeket a szolgáltatói oldalakon olvashattam le, a dátumukkal együtt. Ahol a szolgáltató havi összeget ad meg, azt idézem; ahol nem, 730 órás hónappal számolok, és ezt jelzem.
| Opció | GPU-memória | Listaár | havonta | Dátum és forrás |
|---|---|---|---|---|
| Scaleway L4-1-24G, Párizs | 24 GB | 0,79 € óránként, adó nélkül | kb. 575 € (Scaleway) | 2026. okt. 10., GPU-árlap |
| Scaleway H100-1-80G | 80 GB | 2,868 € óránként 2026. június 1-től | kb. 2 094 € (saját számítás) | 2026. ápr. 27., Scaleway-blogbejegyzés |
| OVHcloud l40s-1-gpu | nincs az árlistán | 1,69 $ óránként, ÁFA nélkül | kb. 1 237 $ (OVHcloud) | 2026. okt. 10., public cloud árlista |
| OVHcloud h100-1-gpu | 80 GiB | 3,39 $ óránként, ÁFA nélkül | kb. 2 473 $ (OVHcloud) | 2026. okt. 10., public cloud árlista |
| RTX 5090, megvásárolva | 32 GB | 1 999 $ indulási ár | kb. 56 $ 36 hónapra osztva (saját számítás) | NVIDIA-hírszoba, január 30-tól |
| Hetzner GEX63 vagy GEX131 | 96 GB | a statikus oldalon nem olvasható | n/a | 2026. okt. 10., GPU-szerver mátrix |
A Hetzner GDPR-kompatibilisnek és Európában elhelyezettnek írja le a GPU-szervereit. A mátrixoldalán 96 GB GDDR7 memóriás RTX PRO 6000 Blackwell kártyák szerepelnek a GEX63 és a GEX131 típusban. A havi árak csak a konfigurátorban jelennek meg, amelyet nem tudtam elolvasni, ezért kihagytam őket a táblázatból. Ellenőrizd ott, mielőtt összehasonlítasz.
Két dologra figyelj. A Scaleway 2026. június 1-jétől 2,73 €-ról 2,868 €-ra emelte az H100 óradíját, így a régebbi összehasonlító oldalak elavultak. Az OVHcloud dollárban mutatja az áraikat, ezért az összehasonlítás napján váltsd át őket euróra, mielőtt az eurós sorok mellé teszed.
Áteresztőképesség vLLM-mel: a számok és a mérés módja
A vLLM saját benchmarkjai relatív nyereséget közölnek, nem abszolút token/másodperc értéket. A csapat 2024 szeptemberi, a v0.6.0-ról szóló bejegyzésében a v0.5.3-hoz képest 2,7-szeres áteresztőképességet jelentett Llama 3 8B modellen egy H100-on, és 1,8-szorosat Llama 3 70B modellen négy H100-on, a ShareGPT adatkészlettel és 500 prompttal. A szerverhez a vLLM-mel kezdeném; a vLLM-áttekintésem a kompromisszumokat tárgyalja.
Az abszolút számok függnek a modelltől, a promptok és a válaszok hosszától, és attól, milyen gyorsan kell egy-egy felhasználónak választ kapnia. A SemiAnalysis InferenceX benchmarkja ezt a kompromisszumot mutatja Llama 3.3 70B modellre H100-on. GPU-nként nagyjából 1 850 token/másodpercet ér el, ha minden felhasználó 38 token/másodpercet kap, nagyjából 1 170-et 58 token/másodperc/felhasználó mellett, és nagyjából 880-at 78 mellett. A három érték az oldal adatpontjaiból interpolált (az én olvasatom), a benchmark pedig 8K/1K sorozathosszokat használ. Az oldal a pontosságot és a szerver-motort nem következetesen adja meg, ezért a számokat nagyságrendnek tekintem.
# serve gpt-oss-120b on one 80 GB GPU (model card)
vllm serve openai/gpt-oss-120b

# a 70B model at bf16 needs two 80 GB GPUs (my calculation)
vllm serve meta-llama/Llama-3.3-70B-Instruct --tensor-parallel-size 2

# from a second terminal, send 500 random prompts at 4 requests per second
vllm bench serve --model openai/gpt-oss-120b --dataset-name random --num-prompts 500 --request-rate 4
Mérd a saját számaidat a vllm bench serve paranccsal. Az alapértelmezett beállítás 1 000 véletlen promptot küld, végtelen kérési rátával, ezért a prompt-számot és a rátát magadnak kell beállítanod, és ahol lehet, a saját promptjaidhoz hasonló promptokat használj. Utána növeld a rátát, és minden szinten jegyezd fel a Time to First Tokent és a Time per Output Tokent. A --goodput opció csak azokat a kéréseket számolja, amelyek teljesítik a késleltetési céljaidat. Ez az a szám, amely egy felhasználóknak szánt funkciónál számít.
Break-even millió tokenenként
A képlet egy sorba fér. A millió tokenre jutó költség a havi GPU-költség osztva az adott hónapban megtermelt tokenekkel, szorozva egymillióval. A havi tokenek a másodpercenkénti tokenek szorozva 2 628 000 másodperccel (730 óra), szorozva azzal az időhányaddal, amelyben a GPU ki van használva. Minden kiszolgált tokent egy számlázható tokennek veszek az API output-árán, így az összehasonlítás egyszerű marad (saját módszer, nem benchmark-eredmény).
Millió tokenre jutó költség egy bérelt H100-on, havi 2 094 €-val, az InferenceX-értékekkel (saját számítás):
| Token/másodperc (sebesség felhasználónként) | 25%-ban kihasználva | 50%-ban kihasználva | 100%-ban kihasználva |
|---|---|---|---|
| 877 (78 token/s felhasználónként) | 3,63 € | 1,82 € | 0,91 € |
| 1 171 (58 token/s felhasználónként) | 2,72 € | 1,36 € | 0,68 € |
| 1 848 (38 token/s felhasználónként) | 1,72 € | 0,86 € | 0,43 € |
Az EU-s API-kkal szemben a Llama 3.3 70B a közelebbi eset. Az OVHcloud 0,67 €-t kér egymillió tokenért, a Scaleway 0,90 €-t. 58 token/másodperc/felhasználó mellett egy bérelt H100-nak az óra körül nagyjából 1 190 token/másodpercet kellene szolgáltatnia ahhoz, hogy elérje az OVHcloud árát (saját számítás). A benchmark ezen a sebességen 1 171-et ad, így nem jut el oda. A Scaleway 0,90 €-s árához a break-even körülbelül 885 token/másodperc, vagyis a benchmark-érték nagyjából háromnegyede.
A gpt-oss-120b magasabbra teszi a lécet. Az API a Scaleway-nél 0,60 €-t kér millió output tokenért, az OVHcloud-nál 0,40 €-t. Egy bérelt H100, havi 2 094 €-val, átlagosan nagyjából 1 330 output tokent kell másodpercenként termelnie, hogy elérje a Scaleway árát, és nagyjából 1 990-et, hogy elérje az OVHcloud árát (saját számítás). Nem találtam ellenőrzött H100-as értéket a gpt-oss-120b-re, ezért mérd meg, mielőtt döntesz. A bemeneti tokenek még olcsóbbak: millióra 0,15 €, illetve 0,08 €.
Az üzemeltetési költségek ráadásul rákerülnek. Minden 1 000 € havi üzemeltetési költség nagyjából 1,7 milliárd output tokennel tolja feljebb a gpt-oss-120b break-even pontját 0,60 €-nál millió tokenenként, vagyis az óra körül nagyjából 630 token/másodperccel (saját számítás). Az ár önmagában ezért ritkán indokolja a saját üzemeltetést, ha egy EU-s API már kínálja a modellt. A saját üzemeltetés akkor éri meg, ha a hardver már a tiéd, ha a terhelés egész hónapban leköti a GPU-t, vagy ha egyetlen EU-s szolgáltató sem kínálja a szükséges modellt.
Saját hardver: a kártya olcsó, az áram és a licenc nem
A megvásárolt kártya a bérelthez képest olcsónak látszik. Az NVIDIA a GeForce RTX 5090 indulási árát 1 999 $-ban adta meg, 32 GB GDDR7 memóriával és 575 W összes grafikai teljesítménnyel. 36 hónapra osztva a kártya havonta nagyjából 56 $-ba kerül (saját számítás). Ha 24 órában, teljes terhelésen fut, egymagában nagyjából 420 kWh-t fogyaszt havonta (575 W × 730 óra, saját számítás), ami a 30 ct/kWh példafeltevéssel nagyjából 126 € havonta (saját számítás, nem idézett tarifa). Három év alatt az áram önmagában nagyjából 4 500 €-ra jön ki, ami több mint kétszerese az 1 999 $-os indulási árnak.
A bevezetés után megjelenő költségek
Amint a szolgáltatás él, a GPU bérleti díja általában a legkisebb tétel. A többi munkaidő és kockázat. A táblázat tervezési számai saját feltételezéseim, nem mért adatok, ezért cseréld le őket a csapatod számaira.
| Költségtétel | Hogyan néz ki | Tervezési feltételezés (saját) |
|---|---|---|
| Üzemeltetés | kiszolgálás, monitorozás, GPU-hibák, újraindítások, kapacitástervezés | egy mérnök munkaidejének 0,1–0,2-e |
| Frissítések | új vLLM-, CUDA- és driververziók, OS-foltok, modellcserék | két–öt mérnöknap modellcserénként |
| Evalok | regressziós készlet futtatása minden modell- vagy kiszolgálás-változtatás előtt | két–öt nap a felépítésre, utána nagyjából egy nap futásonként |
| Ügyelet | valaki válaszol, ha a végpont munkaidőn kívül leáll | legalább két ember egy 24/7 szolgáltatáshoz |
| Redundancia | második GPU-csomópont a meghibásodás kezelésére | nagyjából megduplázza a bérleti díjat |
| Megfelelőség | DPA a hostinggal, DPIA-frissítés, adatkezelési nyilvántartás, a logok, amelyek most már a tiéd | néhány nap évente |
Mit tennék először
- Írd le az adatokat és a szabályokat. Sorold fel, mely adatkategóriák érik el a modellt, és mely szerződések vagy DPIA-következtetések érvényesek. Ha egyik sem zárja ki a feldolgozót, kezdj egy DPA-s EU-s API-val.
- Szerezd meg írásban a hosting-tényeket. Kérdezd meg a hosting régiót, az alfeldolgozók listáját és a megőrzési beállításokat. A Mistral árazási oldala egy DPA-ra linkel, de nem mondja meg, hol fut az API, ezt a választ a szerződésből kell megkapnod.
- Válaszd a legkisebb modellt, amely átmegy az evalokon. Utána ellenőrizd a memóriáját azon a pontosságon, amelyen ténylegesen ki tudod szolgálni, ne a modellkártyán szereplőn.
- Mérj a saját promptjaiddal. Futtasd a vllm bench serve parancsot a valós prompt-hosszokkal és egy latenciacéllal, mielőtt bármilyen hardverre elköteleznéd magad.
- Számold újra a break-even-t a saját számaiddal. Használd a mért token/másodperc értékeidet, a valós kihasználtságodat és az üzemeltetési költségvetésedet. Ha nem jön ki, maradj az API-nál, és tartsd nyilván a saját üzemeltetést tartalék lehetőségként.
- Tervezd meg az üzemeltetést az élesítés előtt. Előbb rögzítsd az evalkészletet, az ügyeleti beosztást és a frissítési szabályokat. A GPU a könnyű rész.
A pipeline adatoldalához olvasd el ezeket: EU-s adatrezidencia, régiókezelés és zero retention és PII-redakció. A regressziós készlethez lásd: LLM-evalok termékfunkciókhoz.
Források
- openai/gpt-oss-120b modellkártya (Hugging Face)
- mistralai/Mistral-Small-3.2-24B-Instruct-2506 modellkártya (Hugging Face)
- meta-llama/Llama-3.3-70B-Instruct modellkártya (Hugging Face)
- mistralai/Mistral-Large-3-675B-Instruct-2512 modellkártya (Hugging Face)
- vLLM-blog: v0.6.0 teljesítményfrissítés (2024. szeptember)
- vLLM-dokumentáció: motor-argumentumok
- vLLM-dokumentáció: vllm bench serve
- SemiAnalysis InferenceX: Llama 3.3 70B H100 vs H200
- Scaleway GPU-példányok árai
- Scaleway-blog: átlátható frissítés a Scaleway-árakról (2026. április 27.)
- Scaleway Generative APIs árai
- OVHcloud public cloud árlista
- OVHcloud AI Endpoints
- OVHcloud AI Endpoints modellkatalógus
- Hetzner dedikált GPU-szerverek
- NVIDIA hírszoba: a GeForce RTX 50 sorozat bevezetése
- NVIDIA GeForce RTX 5090
- NVIDIA GeForce szoftverlicenc
- GDPR 28. cikk: feldolgozó
- GDPR 44. cikk: az átadások általános elve
- Európai Bizottság: EU–USA adattovábbítás (Data Privacy Framework)
- EDPB 28/2024. számú vélemény az AI-modellekről (elfogadva 2024. december 17-én)
- Mistral AI árai
Gyakori kérdések
Automatikusan megfelelővé teszi a GDPR-nak, ha saját LLM-et üzemeltetsz?
Nem. Egy feldolgozót kiiktatsz, de továbbra is szükséged lesz jogalapra, kockázatelemzésre, adatkezelési nyilvántartásra, megőrzési szabályokra és DPA-ra a szervereidet üzemeltető céggel. Az Európai Adatvédelmi Testület (EDPB) szerint a személyes adatokon tanított AI-modellek nem minden esetben tekinthetők anonimnak.
Mennyi GPU-memória kell egy 70B-s modellhez?
Nagyjából 140 GB súly 16 biten, 70 GB 8 biten és 35 GB 4 biten, a KV-cache nélkül (saját számítás). 8 biten egy 80 GB-os kártyán kevés marad a kontextusnak, ezért számolj két kártyával vagy egy 96 GB-os kártyával.
Mikor elég egy EU-ban üzemeltetett API DPA-val?
Ha nincs benne különleges kategóriájú személyes adat, és sem ügyfélszerződés, sem hatásvizsgálat nem zárja ki a feldolgozót. Nézd meg az alfeldolgozók listáját, a hosting régiót, a megőrzési beállításokat, és azt, hogy a szolgáltató tanít-e az adataiddal.
Mennyibe kerül egy bérelt H100 millió tokenre?
Havi 2 094 €-nál (saját számítás: 2,868 € óránként, 730 órára) nagyjából 0,68 € millió output tokenre, ha egész hónapban 1 171 token/másodperc az áteresztőképesség (felhasználónként 58 token/másodperc), és nagyjából 1,36 €, ha ennek a felét használja ki (saját számítás).