Blog/Retrieval és keresés
PDF-feldolgozás RAG-hoz: layout-pipeline-ok, OCR és vizuális modellek összevetve
Miért a PDF-feldolgozáson múlik a RAG minősége, miben más a Docling, a Marker, a MinerU és a VLM-OCR, és hogyan teszteld a parsert saját dokumentumokon.
Balázs Csorba··9 perc olvasás
- RAG
- PDF parsing
- OCR
- Docling
- Document AI
A lényeg röviden
- A PDF-ekre adott rossz RAG-válaszok többsége a feldolgozásnál kezdődik: a hibás olvasási sorrend, a szétesett táblázatok és az ismétlődő fejlécek minden chunkot elrontanak.
- A digitálisan készült PDF-ekhez a szövegréteget olvasó layout-pipeline kell; a szkennelt és képletes oldalakhoz OCR vagy teljes oldalt olvasó vizuális modell.
- A közzétett parser-benchmarkokat többnyire a gyártó futtatja egyetlen dokumentumkeveréken, ezért választás előtt teszteld 30–50 saját oldalon.
- A táblázatokat HTML- vagy Markdown-táblázatként tartsd meg, táblázatonként egy chunkban a fejléccel és a felirattal, ne hagyd, hogy folyó szöveggé essenek szét.
- A feldolgozott dokumentumot a parser verziójával együtt tárold, hogy újra chunkolhass és embeddelhess az OCR újbóli megfizetése nélkül.
Aki egy gyengén teljesítő RAG-rendszert debuggol, általában az embedding-modellel, a chunkmérettel vagy a prompttal kezdi. PDF-eknél a hiba gyakran korábban van: a parser egy kéthasábos adatlapot összefésült félmondatokká alakított, egy ártáblázatot számsorrá lapított, és az oldal láblécét minden chunkba bemásolta. Egy reranker sem javítja meg azt a szöveget, amely már az embedding előtt hibás volt.
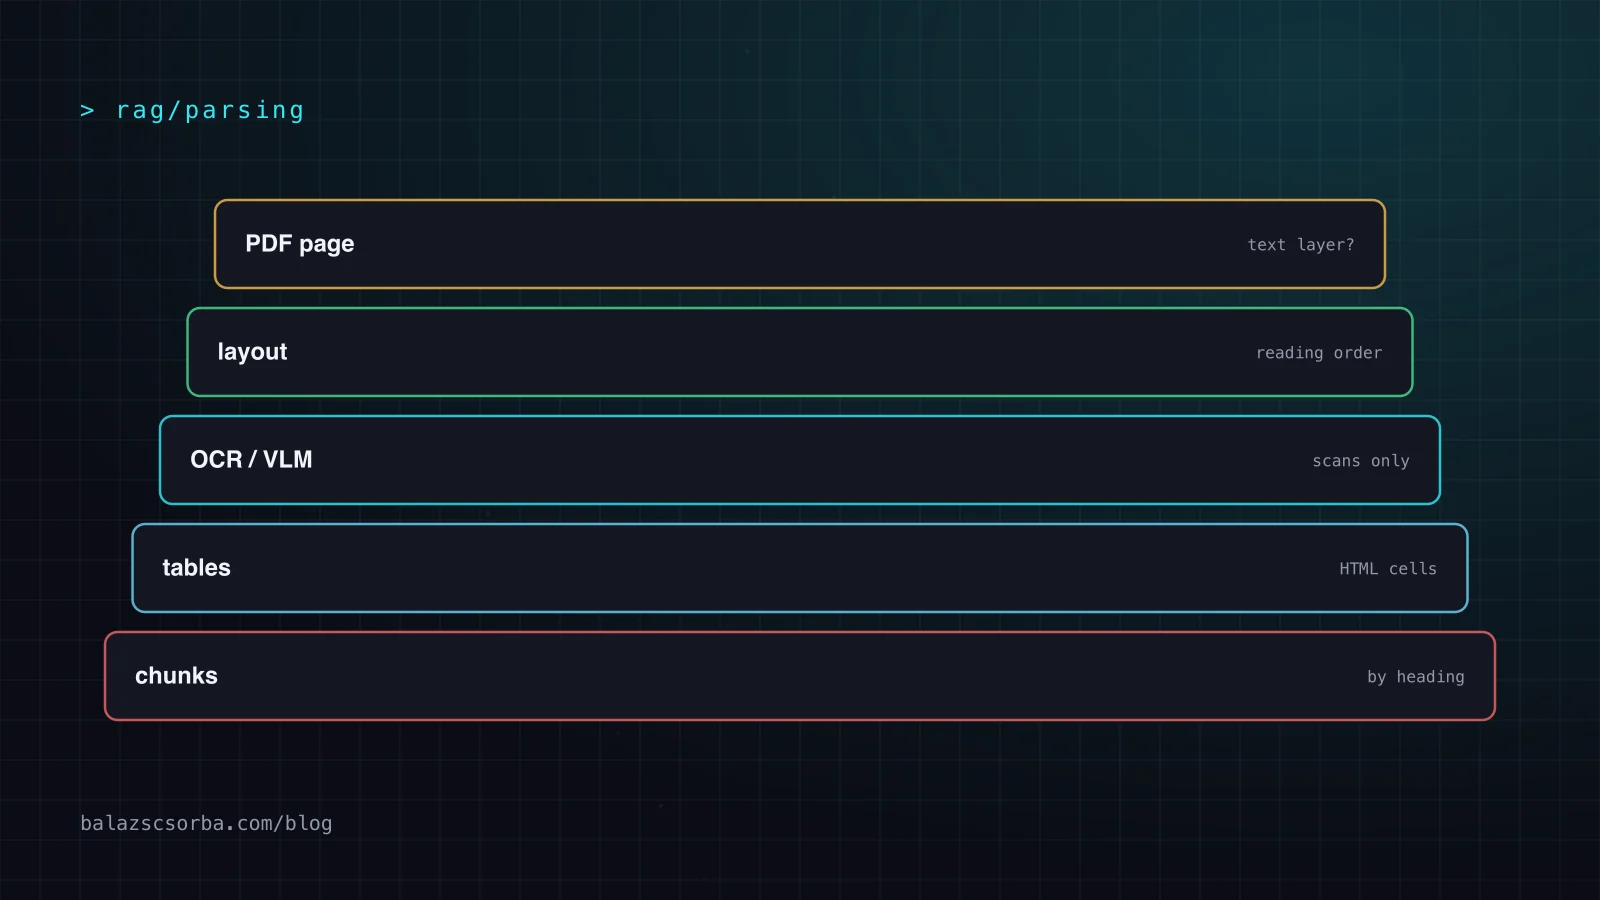
Ez a cikk a PDF-parserek három családját veti össze 2026-ban: a szövegréteg-kinyerést, az olyan layout-pipeline-okat, mint a Docling, a Marker és a MinerU, valamint a teljes oldalt olvasó vizuális modelleket, a projektek által közölt számok alapján. Utána a táblázatokról, a szerkezetet követő chunkolásról, a PDF közvetlen modellnek küldéséről, a licencekről és egy kis tesztről lesz szó, amelyet a döntés előtt a saját dokumentumaidon futtathatsz.
Miért a PDF-feldolgozáson múlik a RAG minősége?
A PDF koordinátákon elhelyezett karaktereket tárol, nem bekezdéseket. Mindent, amire egy RAG-pipeline-nak szüksége van – az olvasási sorrendet, hogy mi címsor, hol kezdődik egy táblázatcella –, rekonstruálni kell. Minden hiba közvetlenül az indexbe kerül:
- Olvasási sorrend: a többhasábos elrendezés, a széljegyzetek és a képaláírások soronként összekeverednek, így egy chunkba két, egymáshoz nem tartozó mondat kerül.
- Táblázatok: szerkezet-helyreállítás nélkül a táblázat oszlopnevek nélküli értéksorrá válik, és a modell találgat, melyik szám melyik termékhez tartozik.
- Ismétlődő elemek: a fejlécek, láblécek és oldalszámok minden oldalon megjelennek, és lényegtelen chunkokat húznak a találati lista elejére.
- Szkennelt oldalak és rossz szövegréteg: a szkennelt oldalakon egyáltalán nincs szöveg, egyes exportált PDF-ek pedig hibás szövegréteget hordoznak, amely a képernyőn jól néz ki, de kinyerve értelmetlen karaktersor.
Ezért a visszakeresést és a generálást külön értékelem, ahogy a RAG értékelése cikkben leírtam. Ha PDF-eknél a visszakeresés hibázik, mielőtt bármi máshoz nyúlnál, nyisd meg a hibás oldal feldolgozott szövegét.
Melyik a PDF-parserek három családja?
A parserek elsősorban abban különböznek, mit olvasnak: a beágyazott szövegréteget, az oldal renderelt képét vagy mindkettőt.
| Család | Példák | Erősség | Gyengeség |
|---|---|---|---|
| Szövegréteg-kinyerés | PyMuPDF, pdfplumber, pypdf | Gyors, csak CPU, pontos karakterek | Nincs layout és táblázat, szkennelt oldalon semmi |
| Layout-pipeline-ok | Docling, Marker, MinerU (pipeline), Unstructured | Olvasási sorrend, táblázatok, címsorok; OCR csak ahol kell | Több modellt kell futtatni; a bonyolult, egymásba ágyazott layout még mindig elromlik |
| Teljes oldalt olvasó vizuális modellek | olmOCR, Chandra, MinerU (VLM), GraniteDocling | Szkennelt, képletes és rendezetlen oldalakon a legjobb | GPU-költség; olyan szöveget is hallucinálhat, ami nincs az oldalon |
A határok elmosódnak. A Docling (MIT-licenc) alapból a szövegrétegen futtat layout- és táblázatszerkezet-modelleket, de átkapcsolható egy VLM-pipeline-ra a 258M paraméteres GraniteDocling modellel. A Marker ma már a layoutot, az OCR-t és a táblázatfelismerést a helyben futó surya VLM-en keresztül végzi, a digitális szöveget viszont továbbra is a PDF-ből olvassa. A MinerU pipeline- és VLM-backendet is kínál. A gyakorlatban nem az a kérdés, melyik eszköz, hanem hogy melyik mód melyik oldalakhoz.
Mit mondanak valójában a benchmarkok?
Jelenleg a leghasznosabb közös mérce az Allen Institute for AI olmOCR-bench-e, amelyet az olmOCR-tanulmány vezetett be: nagyjából 1400 PDF több ezer sikeres/sikertelen egységteszttel képletekre, táblázatokra, olvasási sorrendre, fej- és láblécekre és régi szkennelt oldalakra. Az egységtesztek jobban illenek a RAG-hoz, mint a szerkesztési távolság, mert olyan tényeket ellenőriznek, amelyek számítanak, például hogy egy táblázatcella a megfelelő fejléc mellett áll-e.
| Rendszer (Datalab mérése, GPU) | Összesen | Csak digitális | Áteresztés |
|---|---|---|---|
| Marker, balanced mód | 76.0 | 83.5 | 2.9 pg/s |
| MinerU, pipeline-backend | 72.7 | 83.3 | 0.54 pg/s |
| Docling | 50.3 | 64.0 | 2.1 pg/s |
A táblázatot fenntartással kell olvasni: a Markert a Datalab fejleszti, mindhárom eszközt a saját hardverén mérte, a Docling az alapértelmezett pipeline-jával futott, a MinerU VLM-backendje pedig – amely a Datalab szerint is jobb eredményt ér el – nincs benne. A Datalab a saját, teljes oldalt olvasó dokumentum-VLM-jét, a Chandrát ugyanezen a benchmarkon 85,8-cal tünteti fel. Két dolog ettől még áll. Digitális PDF-eken a két élen álló pipeline szinte fej fej mellett van, így a sebesség és a licenc is dönthet. A nehéz oldalakon pedig a teljes oldalt olvasó VLM-ek nyernek, ezért éri meg oldalanként irányítani.
Hogyan nyerjük ki és chunkoljuk a táblázatokat?
A műszaki és kereskedelmi dokumentumokban éppen a táblázatok hordozzák azokat a tényeket, amelyekre a felhasználók a leggyakrabban kérdeznek: méretek, tűrések, árak, szállítási idők. Kezeld őket önálló objektumként:
- Maradjon meg a szerkezet a kimenetben. A táblázatokat HTML- vagy Markdown-táblázatként exportáld, ne szövegként. A Marker HTML-blokként adja ki a táblázatokat, a Docling Markdownt, HTML-t és veszteségmentes JSON-t exportál.
- Egy táblázat, egy chunk, a feliratával és a legközelebbi címsorral együtt, hogy a chunkból kiderüljön, miről szól.
- A hosszú táblázatot sorok mentén vágd szét, és minden részben ismételd meg a fejlécsort; egy oszlopnevek nélküli sor csak zaj.
- Az oldalakon átnyúló táblázatokat egyesítsd. Ez ismert gyenge pont; a Marker opcionális
--use_llmmódja LLM-mel egyesíti az oldalakon átnyúló táblázatokat és javítja a formázásukat, plusz költségért. - Ha az adat máshol is megvan, azt használd. Az ERP-ből származó árlista egy lekérdezhető adatbázisba való, nem egy PDF-be, amelyet aztán visszafejtünk.
Hogyan chunkoljuk a feldolgozott dokumentumokat?
Ha a parser helyreállította a címsorokat, azok mentén chunkolj, ne N tokenenként vágj. Egy címsor alatti szakasz általában egy téma, a címsor-útvonal (dokumentumcím, fejezet, szakasz) pedig rövid és olcsó kontextus-előtagot ad minden chunknak. A chunkméretekről, a hibrid keresésről és a rerankingről az Éles RAG-pipeline lépésről lépésre cikkben írtam.
Az Anthropic Contextual Retrieval módszere egy lépéssel tovább megy: az embedding előtt egy LLM a teljes dokumentum alapján rövid kontextusmondatot ír minden chunkhoz. Prompt cachinggel az Anthropic az egyszeri költséget millió dokumentumtokenenként 1,02 dollárra becsülte. Tiszta feldolgozásra építve működik a legjobban, mert a kontextusmondat csak annyira jó, amennyire a modell által olvasott dokumentumszöveg.
# Illustrative: chunk a parsed Markdown document by headings, keep tables whole
import re

def chunks(md: str, doc_title: str, max_chars: int = 3000):
    path, buf = [doc_title], []
    for block in re.split(r"\n(?=#{1,3} )|\n\n", md):
        if m := re.match(r"(#{1,3}) (.+)", block):
            yield from flush(path, buf); buf = []
            level = len(m.group(1)); path = path[:level] + [m.group(2)]
        elif block.lstrip().startswith(("|", "<table")):
            yield from flush(path, buf); buf = []
            yield {"context": " > ".join(path), "text": block, "kind": "table"}
        else:
            buf.append(block)
            if sum(map(len, buf)) > max_chars:
                yield from flush(path, buf); buf = []
    yield from flush(path, buf)

def flush(path, buf):
    if buf:
        yield {"context": " > ".join(path), "text": "\n\n".join(buf), "kind": "text"}
Mikor küldd a PDF-et közvetlenül a modellnek?
A frontier modellek natívan olvasnak PDF-et. A Claude PDF-támogatása 32 MB-ig és 600 oldalig fogad kéréseket (100 oldalig, ha a kérés kontextusablaka egymillió token alatt van), és minden oldalt képként dolgoz fel. Ha egy felhasználó egy szerződést tölt fel a chatbe, ez a legegyszerűbb és gyakran a legjobb megoldás.
Egy korpusznál megfordul a számítás. Minden lekérdezés újra fizetne az oldalak elolvasásáért, nem tudsz rangsorolni olyan oldalakat, amelyeket nem embeddeltél, a hivatkozásokhoz pedig stabil oldal- és chunkazonosítók kellenek. Az olmOCR szerzői szerint egymillió oldal konvertálása GPT-4o-val több mint 6240 dollár, a saját GPU-ikon futó nyílt 7B modelljükkel 176 dollár. Egyszer dolgozd fel, indexeld, és a modellnek csak a visszakeresett chunkokat küldd.
Mely licenc- és adatvédelmi kérdések számítanak?
| Parser | Kód licence | Modellsúlyok |
|---|---|---|
| Docling | MIT | Az egyes modellek saját licence |
| Marker | Apache 2.0 | Módosított OpenRAIL-M: ingyenes kutatásra, magáncélra és 5 millió dollár finanszírozás vagy bevétel alatti startupoknak; felette fizetős |
| MinerU | MinerU Open Source License (Apache 2.0 kiegészítő feltételekkel) | Lásd a repót |
Egy ügyfélprojekt élesítése előtt a súlyok licencét is ellenőrizd, ne csak a kódét; különösen a Marker feltételei függnek a cég méretétől. Mindhárom fut helyben, ami akkor fontos, ha a dokumentumok személyes adatot tartalmaznak, például számlákat, HR-aktákat vagy ügyfélszolgálati jegyeket. Ha mégis hosztolt parsert vagy LLM API-t használsz, a GDPR és LLM-adattárolás cikk kérdései változatlanul érvényesek.
Hogyan teszteld a parsert a saját dokumentumaidon?
Vedd át az olmOCR-bench ötletét, és írj egységteszteket a saját oldalaidra. Válassz 30–50 oldalt, amelyek jól képviselik a korpuszt, a csúnyákat is: egy szkennelt szállítólevelet, egy kéthasábos adatlapot, egy oldalon átnyúló táblázatot. Minden oldalhoz írj néhány ellenőrzést, amelyen egy helyes feldolgozásnak át kell mennie, és futtasd le rajtuk az összes jelöltet.
# Illustrative page checks, scored per parser
CHECKS = [
  {"page": "datasheet-p2", "present": "Operating temperature -20 to 60 °C"},
  {"page": "datasheet-p2", "order": ["Dimensions", "Weight", "Material"]},
  {"page": "pricelist-p1", "cell": {"row": "ART-10001", "col": "Unit price", "value": "12.40"}},
  {"page": "delivery-note-scan", "present": "Lieferschein Nr. 48211"},
  {"page": "manual-p7", "absent": "Page 7 of 112"},   # footer must not leak into text
]
Minden parsert értékelj a sikeres ellenőrzések aránya, a saját hardvereden mért oldal/másodperc és a költség alapján. Utána futtasd le a visszakeresési értékelést a győztes kimenetén, mert az ellenőrzéseket megnyerő parser általában, de nem mindig nyeri a visszakeresést is.
Mi változik B2B-adatlapoknál és kézikönyveknél?
Az ipari dokumentumok tele vannak cikkszámokkal, mértékegységekkel és táblázatokkal, és éppen itt fájnak a szövegréteg hibái: egy elveszett kötőjel az ART-10001-ben, kérdőjellé vált fokjel, kimaradt mértékegység-oszlop. A pontos azonosítókat a vektorok mellett kulcsszóindexszel is tedd kereshetővé, ahogy a szemantikus termékkeresés B2B-webshopokban cikkben leírtam, és vegyél fel cikkszám-ellenőrzéseket a parser-tesztkészletbe.
Sok adatlap strukturált adatként is megvan egy PIM-ben. Ahol igen, ott a PIM-attribútumokat indexeld, a PDF-et pedig hivatkozásként linkeld, ahelyett hogy visszafejtenéd a PIM által előállított PDF-et. Ha csak PDF-ed van, az ésszerű alapértelmezés egy szelektív OCR-rel dolgozó layout-pipeline, a teljes oldalt olvasó VLM-et pedig tartsd meg azokra az oldalakra, amelyeken elbukik.
Források
- Docling: README, features and license (GitHub)
- Auer et al.: Docling: An Efficient Open-Source Toolkit for AI-driven Document Conversion (2025)
- Datalab: Marker README, olmOCR-bench results and license (GitHub)
- OpenDataLab: MinerU README and license (GitHub)
- Poznanski et al.: olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models (2025)
- Claude Platform Docs: PDF support
- Anthropic: Introducing Contextual Retrieval (Sep 2024)
Gyakori kérdések
Melyik a legjobb PDF-parser RAG-hoz?
Egyértelmű győztes nincs. A Datalab által közölt olmOCR-bench számokban a Marker balanced módja megelőzi a MinerU pipeline-backendjét és a Doclingot, de ezek a gyártó saját mérései. A Docling licence a legmegengedőbb (MIT), és a legtöbb formátumot kezeli. Tesztelj két-három parsert a saját dokumentumaid mintáján.
Minden PDF-hez kell OCR?
Nem. A Wordből, PIM-ből vagy CMS-ből exportált PDF-eknek van szövegrétege, amelyet a layout-pipeline-ok közvetlenül és olcsón olvasnak. OCR a szkennelt oldalakhoz, fotókhoz és a használhatatlan beágyazott szövegű oldalakhoz kell, a jó pipeline-ok ezeket felismerik, és csak ezeken futtatnak OCR-t.
Nem küldhetem egyszerűen a PDF-et a Claude-nak vagy a GPT-nek?
Néhány dokumentumnál egy beszélgetésben igen: a Claude kérésenként 32 MB-ig és 600 oldalig fogad PDF-et. Egy egyszer indexelt, de sokszor lekérdezett korpusznál sokkal olcsóbb előbb szöveggé alakítani, és így oldalanként chunkolhatsz, embeddelhetsz és hivatkozhatsz.
Hogyan chunkoljuk a táblázatokat RAG-hoz?
Minden táblázat maradjon egyben HTML- vagy Markdown-táblázatként, a feliratával és a legközelebbi címsorral, saját chunkban. Ha túl hosszú, sorok mentén vágd szét, és minden részben ismételd meg a fejlécsort.
GDPR-szempontból rendben van felhős API-val feldolgozni?
Ez az adatokon és a szerződésen múlik. A Docling, a Marker és a MinerU is fut helyben, így a személyes adatok a saját gépeiden maradnak. Hosztolt parsernél vagy LLM API-nál adatfeldolgozási szerződés kell, és tudnod kell, hol történik a feldolgozás.