Blog/Retrieval és keresés
Cross-encoder rerankerek: Cohere, bge, Voyage, Jina és késői interakció (2026)
Rerankerek 2026 októberében: pointwise, listwise és késői interakció, Cohere, Voyage, bge, Qwen3, Jina és mxbai, árak, saját üzemeltetés és a k választása.
Balázs Csorba··frissítve ·8 perc olvasás
- Reranking
- RAG
- Search
- Cross-encoders
- Evaluation
A lényeg röviden
- A reranker együtt pontozza a lekérdezést és a dokumentumot, ami pontos, de túl lassú a teljes korpuszhoz, ezért egy gyors első lépés top k találatát rendezi újra.
- Három architektúra verseng: pointwise cross-encoderek, az összes jelöltet egyszerre olvasó listwise rerankerek és a tárolt tokenvektoros késői interakció; az RRF-hez egyáltalán nem kell modell.
- 2026 októberében a Cohere keresésenként számláz (1000 keresésenként 2,00–2,50 dollár), a Voyage tokenenként (millió tokenenként 0,02–0,05 dollár); a nyílt modellek, mint a bge-reranker-v2-m3 és a Qwen3-Reranker, Apache-2.0 licencűek.
- A többletkésleltetés lineárisan nő k-val, ezért induljon egy gyártói alapértékről, például az Azure top 50-éről, és egy kis címkézett kiértékeléssel hangoljon, ne ranglistákkal.
- A gyártói benchmarkállítások nem függetlenek; egy 50 lekérdezéses kiértékelés a saját adatain dönti el a modellt, a k-t, és azt, hogy egyáltalán kell-e reranker.
A reranker együtt olvassa a lekérdezést és egy jelölt dokumentumot, és relevanciapontszámot ad, ami pontosabb két beágyazás összevetésénél, de túl lassú ahhoz, hogy egy teljes korpuszon fusson. Ezért kétlépcsős a visszakeresés: egy gyors visszakereső 50–250 jelöltet talál, egy cross-encoder pedig újrarendezi őket, hogy a legjobb néhány jusson a modellhez. A döntés az, melyik reranker, hány jelölt, és megéri-e a javulás a késleltetést.
Ez a cikk összeveti a pontozási architektúrákat, a 2026 októberében elérhető modelleket, a hosztolt árakat és a saját üzemeltetést, alternatívaként a késői interakciót és az LLM-rerankereket, valamint egy kis kiértékelést k megválasztásához. Hogy a teljes folyamatban hol a helye az újrarangsorolásnak, azt a RAG-folyamatok: darabolás, hibrid keresés és újrarangsorolás című cikk írja le.
Mit ad a reranker, és mibe kerül
A reranker pontosságot ad a lista elején, és k-val arányos késleltetésbe kerül. Hogy miért nem váltja ki a visszakeresést, az aritmetika: a Sentence-BERT-tanulmány szerint 10 000 mondat közül a leghasonlóbb pár megtalálása körülbelül 50 millió BERT-következtetést, nagyjából 65 órát igényel, ami „alkalmatlanná teszi szemantikus hasonlósági keresésre” (SBERT). A dokumentált éles felépítés ezért egy jelölteket kereső bi-encoder és egy azokat újrarangsoroló cross-encoder (Sentence Transformers).
A két szám, amelyet bevezetés előtt ismerni kell: az első lépcső recallja k mellett és k pár pontozásának többletkésleltetése. Ha a megfelelő dokumentum nincs a top 100-ban, semmilyen reranker nem találja meg; ha a 30. helyen van, és Ön öt találatot mutat, a reranker pontosan a megoldás. A cikkszámokat és hosszú német összetett szavakat tartalmazó termékkeresés tipikus eset, ahol a megfelelő tételt megtalálja, de túl hátra sorolja a rendszer, lásd szemantikus termékkeresés B2B-ben.
A második szám ugyanolyan fontos, mint az első. Pointwise modellnél minden jelölt egy újabb futás, így 50-ről 200 jelöltre lépve nagyjából négyszeresére nő az újrarangsorolás ideje. Egy interaktív keresőmezőben ezt a felhasználó észreveszi; egy háttérben készülő RAG-válasznál, amely amúgy is másodperceket vár a generálásra, talán egyáltalán nem számít. Írja le a késleltetési keretet, mielőtt modelleket hasonlít össze, mert ez dönti el, a lenti táblázat melyik fele jöhet egyáltalán szóba.
Hogyan pontoznak a rerankerek: párok, listák és tokenvektorok
Három architektúra van, és a modell nélküli összefésülés. A pointwise cross-encoder összefűzi a lekérdezést egy dokumentummal, és egy relevancia-logitot ad, így k jelölt k futást jelent. A listwise reranker a lekérdezést és az összes jelöltet egy kontextusablakba teszi, és egyetlen menetben rendezi őket. A késői interakció indexeléskor tokenenként egy vektort tárol, és lekérdezéskor MaxSim-mel illeszti hozzájuk a lekérdezés tokenjeit, így a munka nagy része kikerül a lekérdezés útjából.
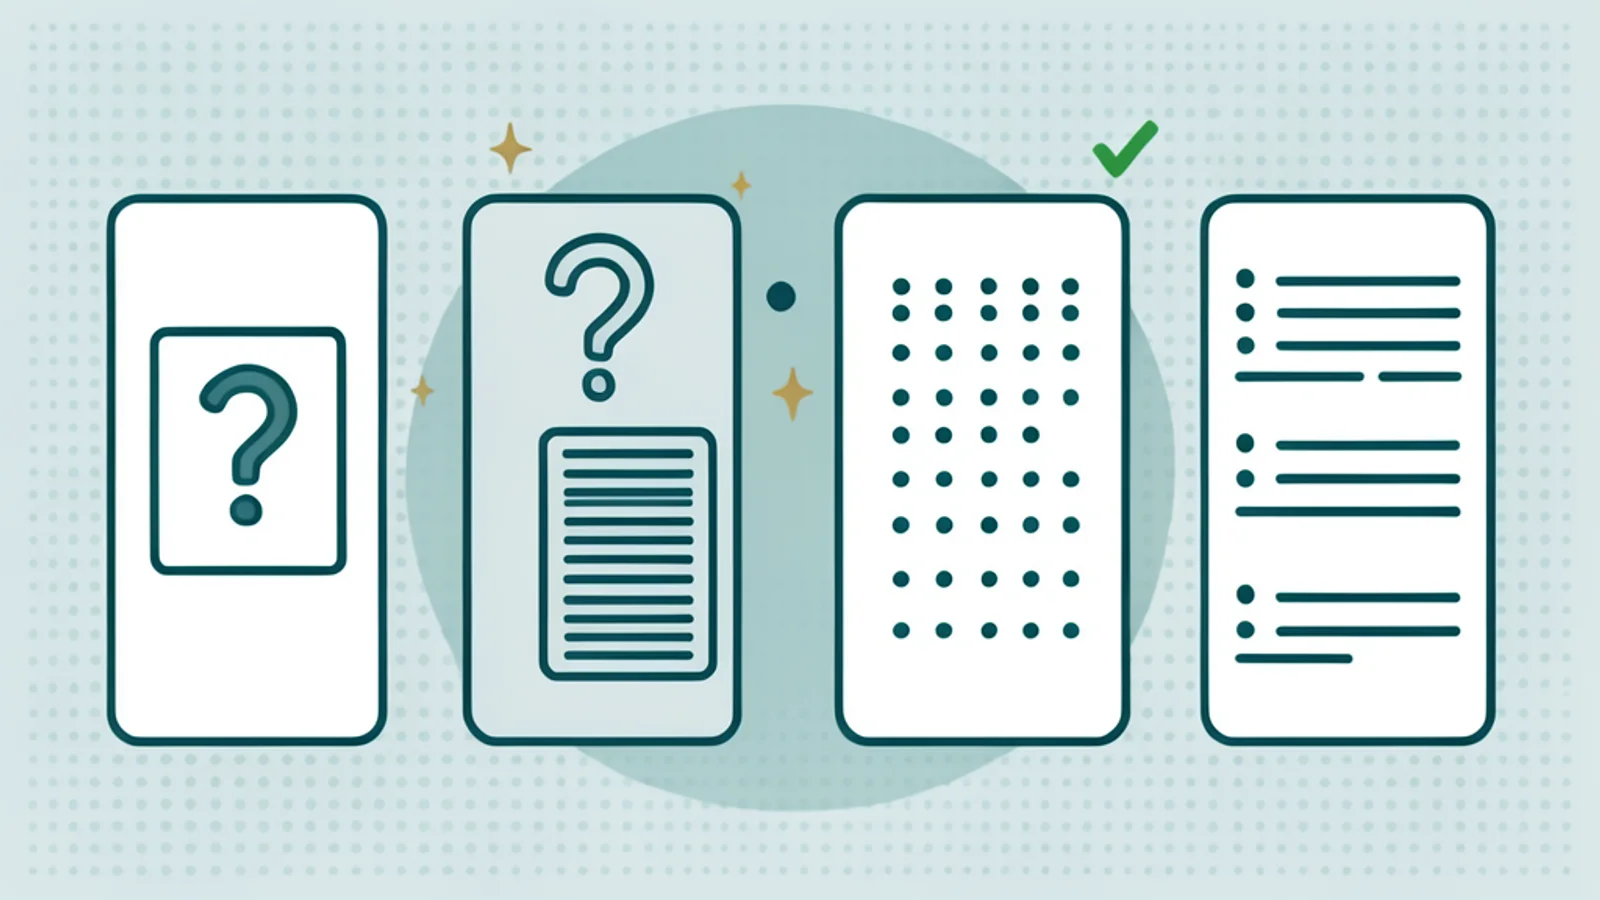
A Jina Reranker v3 a legtisztább listwise példa: egy 0.6B-s modell, amely egyetlen ablakban olvassa a lekérdezést és az összes jelöltet, a Jina szavaival „last but not late interaction”. A 2026 augusztusi v3.5 megtartja a 0.6B paramétert, 131K tokenre bővíti a kontextust, és a v3-nál akár 1,56-szor gyorsabb újrarangsorolást jelent (Jina). A listwise modellek egymáshoz viszonyítva látják a jelölteket, ami a közel azonos találatoknál segít, de az egész listának bele kell férnie a kontextusba.
A 2026-os kínálat
2026 októberében a hosztolt sorozatok a Cohere Rerank 4, amely 2025 decemberében jelent meg rerank-v4.0-pro és rerank-v4.0-fast változatban 32k kontextussal, valamint a 2026. szeptember 30-án kiadott Voyage rerank-3 és rerank-3-lite, szintén 32k-val. A Voyage szerint a rerank-3 95 adathalmazon 2,72 százalékkal jobb a Cohere Rerank 4 Prónál (Voyage); ez gyártói állítás gyártói tesztsoron, nem független eredmény. A nyílt modellek licence megengedi a kereskedelmi saját üzemeltetést.
| Modell (2026. okt.) | Architektúra | Méret / kontextus | Hosztolt ár | Licenc / megjegyzés |
|---|---|---|---|---|
| Cohere Rerank 4 Pro | cross-encoder | 32k | 2,50 $ / 1000 keresés | API, többnyelvű |
| Cohere Rerank 4 Fast | cross-encoder | 32k | 2,00 $ / 1000 keresés | API, alacsony késleltetés |
| Voyage rerank-3 | cross-encoder | 32k | 0,05 $ / 1M token | API, 2026 szept. óta |
| Voyage rerank-3-lite | cross-encoder | 32k | 0,02 $ / 1M token | API, olcsóbb szint |
| bge-reranker-v2-m3 | cross-encoder | 0.6B / 8k | saját üzemeltetés | Apache-2.0 |
| Qwen3-Reranker-8B | LLM-alapú cross-encoder | 8B | saját üzemeltetés | Apache-2.0 |
| Jina Reranker v3.5 | listwise | 0.6B / 131K | API vagy saját | licenc és ár ellenőrzendő |
| mxbai-rerank-large-v2 | cross-encoder | 1.5B | saját üzemeltetés | Apache-2.0, 100+ nyelv |
| ColBERTv2 | késői interakció | tokenvektorok | saját üzemeltetés | tárhelyigényes index |
| RRF | rangfúzió | nincs modell | ingyenes | az Elasticsearchbe építve |
A BAAI/bge-reranker-v2-m3 az elterjedt nyílt alapválasztás: 0.6B-s többnyelvű cross-encoder XLM-RoBERTa alapon, Apache-2.0 licenccel, az elmúlt hónapban több mint 15 millió letöltéssel (Hugging Face). A Qwen3-Reranker-8B a Qwen3 Embedding sorozat nehézsúlyú nyílt változata, a mixedbread mxbai-rerank-large-v2 modellje pedig 1,54B paraméterrel, FP16-ban nagyjából 3,09 GB-tal a kettő között áll, több mint 100 nyelvvel (mixedbread).
Két gyakorlati különbség többet számít egy nDCG-pontnál. A kontextushossz dönti el, hogy egy hosszú termékadatlap vagy szerződéses záradék egyetlen dokumentumként belefér-e, vagy fel kell darabolni; a Cohere v4-es modelljei 32 764 tokennél darabolják a dokumentumokat, és a legmagasabb darabpontszámot tartják meg. A nyelvi lefedettség dönti el, hogy a német és magyar lekérdezések ugyanolyan jól működnek-e, mint az angolok, ezért európai tartalomhoz általában a többnyelvű bge, mxbai és Cohere modellek a jelöltek.
Árak: keresésenként, tokenenként vagy a saját CPU-n
A hosztolt rerankereket két különböző egységben árazzák, ezért nehéz első ránézésre összevetni őket. A Cohere keresésenként számláz: 1000 keresésenként 2,00 dollár a Rerank 4 Fast és 2,50 a Rerank 4 Pro, ahol egy keresés egy lekérdezés legfeljebb 100 dokumentummal, az 500 tokennél hosszabb dokumentumok pedig többnek számítanak (Cohere árak). A Voyage tokenenként számláz: millió tokenenként 0,05 dollár a rerank-3 és 0,02 a rerank-3-lite (Voyage árak).
Választás előtt hozza közös nevezőre a kettőt. 100, egyenként körülbelül 300 tokenes jelöltnél egy lekérdezés nagyjából 30 000 token: kb. 0,0015 dollár a rerank-3-mal és 0,0025 a Rerank 4 Próval. Hosszabb daraboknál megfordul az arány, mert a Cohere dokumentumonként, a Voyage tokenenként számol. A Cohere hasznos korlátokat is dokumentál: lekérdezésenként legfeljebb 2048 token, és azt ajánlja, hogy kérésenként ne küldjön 1000-nél több dokumentumot (Cohere).
Saját üzemeltetésnél az ár számítási kapacitássá alakul. CPU-n a méret a gyakorlati korlát: a FastEmbed ONNX rerankerei a ms-marco-MiniLM-L-6-v2 0,08 GB-jától a jina-reranker-v2-base-multilingual 1,11 GB-jáig terjednek, utóbbi csak nem kereskedelmi célra licencelt (FastEmbed). Páronkénti CPU-késleltetésre nem találtam elsődleges benchmarkot, ezért elköteleződés előtt mérjen a saját hardverén, a saját darabhosszával. A saját Nuxt-oldalamon, ahol LLM-funkciókat futtatok, az ilyen feladatra az olcsó út a hibrid visszakeresés és egy kis ONNX-modell a szerveren, nem lekérdezésenként egy LLM-hívás.
A késői interakció mint alternatíva
A késői interakció más kompromisszum, nem jobb cross-encoder. A ColBERTv2 tokenenként egy vektort tart, reziduális tömörítéssel hat-tízszeresére csökkenti a késői interakciós modellek tárigényét, és lekérdezéskor olcsó MaxSim-mel pontoz (ColBERTv2). Lekérdezési késleltetés helyett indexmérettel fizet, ami nagy k-hoz és nagy lekérdezésszámhoz illik. Oldalképekhez ugyanez az ötlet hajtja a ColPalit, lásd multimodális RAG ColPalival. A rerankers könyvtár egy felület mögé csomagolja a cross-encodereket, az API-kat és a késői interakciós modelleket, így egy kiértékelésben könnyű cserélgetni őket (rerankers).
LLM-rerankerek, és mikor elég önmagában az RRF
Egy általános LLM is tud újrarangsorolni, de ritkán ez a legolcsóbb út. A RankGPT megmutatta, hogy egy jól instruált GPT-4 az IR-benchmarkokon felveheti a versenyt a felügyelt rerankerekkel, sőt jobb is lehet náluk, és hogy egy desztillált 440M-es modell legyőzött egy felügyelt 3B-s modellt a BEIR-en (RankGPT). A Voyage saját tanulmánya a másik oldalt képviseli: szerinte a célra épített rerankerek akár 60-szor olcsóbbak és 48-szor gyorsabbak az LLM-eknél (Voyage); mindkét forrás érdekelt, ezért a saját adatain teszteljen.
A reciprocal rank fusion a legolcsóbb lépés, és gyakran ez az első, amit érdemes hozzáadni. Több visszakereső rangsorát kizárólag a pozíciók alapján fésüli össze; az Elasticsearch egy alapértelmezésben 60-as rank_constant és egy rank_window_size paraméterrel valósítja meg (Elastic). Az RRF elég, ha a BM25 és a vektoros keresés más-más jó találatokat hoz, és az összefésült lista eleje már rendben van. Akkor tegyen rá modellt, ha a megfelelő dokumentum rendszeresen az összefésült top 50-ben van, de nem a top 5-ben.
k és a modell kiválasztása egy kis kiértékeléssel
Induljon egy ismert alapértékről, és hagyja, hogy egy kis címkézett készlet mozdítsa el. Az Azure AI Search szemantikus rangsorolója csak a top 50 találatot viszi tovább, dokumentumonként legfeljebb 2000 tokennel, egy BM25- vagy RRF-alapú eredményhalmazból kiindulva (Azure). Ez észszerű kezdő k. Ezután címkézzen fel 50 valódi lekérdezést azokkal a dokumentumokkal, amelyeknek meg kell válaszolniuk őket, és mérje a 10-es recallt újrarangsorolás előtt és után 25-ös, 50-es és 100-as k mellett.
# A small reranker eval: 50 labelled queries, recall@k before and after reranking
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")

def recall_at(ranked_ids, relevant_ids, n):
    return len(set(ranked_ids[:n]) & relevant_ids) / len(relevant_ids)

for k in (25, 50, 100):
    before, after = [], []
    for q in labelled_queries:                       # [{"text": ..., "relevant": {...}}]
        hits = first_stage(q["text"], k=k)           # your hybrid search: [(id, text), ...]
        scores = reranker.predict([(q["text"], t) for _, t in hits])
        reranked = [i for (i, _), _ in sorted(zip(hits, scores), key=lambda p: -p[1])]
        before.append(recall_at([i for i, _ in hits], q["relevant"], 10))
        after.append(recall_at(reranked, q["relevant"], 10))
    print(k, sum(before) / len(before), sum(after) / len(after))
Ne növelje tovább k-t, ha a 10-es recall már nem javul, és ezt mérje össze a mért késleltetéssel. Futtassa ugyanazt a szkriptet két-három modellel, és tartsa meg a legolcsóbbat, amely legfeljebb egy ponttal marad el a legjobbtól. Minden beágyazómodell-csere után futtassa újra, mert az első lépcső dönti el, mit lát a reranker. Hogy az ilyen kiértékelések hogyan illeszthetők egy kiadási folyamatba, azt az LLM-kiértékelések termékfunkciókhoz című cikk írja le.
Mikor ne használjon rerankert, és egy ellenőrzőlista
Hagyja ki a rerankert, ha az első lépcső már az első néhány találat közé teszi a jó választ, ha a lekérdezésekben a pontos azonosítók dominálnak, és a BM25 megtalálja őket, vagy ha a késleltetési keret nem bír el k további futást. Ilyenkor a jobb darabolás, a metaadat-szűrők vagy az RRF kevesebbért többet ad. Akkor vegyen fel egyet, ha a kiértékelés szerint a releváns dokumentumok közvetlenül a vágási határ alatt vannak.
- Mérje az első lépcső recallját k mellett, mielőtt rerankert választ.
- Fésülje össze RRF-fel a BM25- és vektoros találatokat, mielőtt modellt tesz rá.
- Kezdjen 50-es k-val, és adjon vissza 5–20 találatot.
- Számolja át a hosztolt árakat lekérdezésenkénti költségre a saját darabhosszán.
- Saját üzemeltetés előtt ellenőrizze a licencet; egyes rerankerek nem kereskedelmi célúak.
- A többletkésleltetést a saját hardverén mérje, ne publikált számokból vegye át.
- Futtassa újra az 50 lekérdezéses kiértékelést minden modell- vagy darabolásváltás után.
Ha egy RAG-rendszer vagy termékkeresés visszakeresését hangolja, és számokkal szeretné alátámasztani a reranker-döntést, nézze meg a MI-mérnöki munkámat. Az alatta lévő vektortár választását a Qdrant-ismertető tárgyalja.
Források
- Sentence-BERT (arXiv 1908.10084)
- Sentence Transformers: retrieve and re-rank
- BAAI/bge-reranker-v2-m3 model card
- Cohere docs: reranking best practices
- Cohere pricing
- Voyage AI blog: rerank-3 (30 Sep 2026)
- Voyage AI docs: pricing
- Jina AI: Reranker v3.5 (3 Aug 2026)
- ColBERTv2 (arXiv 2112.01488)
- Elasticsearch docs: reciprocal rank fusion
- Azure AI Search: semantic ranking overview
- RankGPT (arXiv 2304.09542)
Gyakori kérdések
Mit csinál a reranker egy RAG-rendszerben?
Átveszi egy gyors első lépcsős visszakereső legjobb jelöltjeit, mindegyiket a lekérdezéssel együtt pontozza, és újrarendezi őket, hogy a legrelevánsabb darabok jussanak a modellhez. Mivel együtt olvassa a lekérdezést és a dokumentumot, pontosabb a beágyazási hasonlóságnál, de túl lassú a teljes korpuszhoz.
Melyik rerankert érdemes használni 2026-ban?
Hosztolt API-ként 2026 októberében a Cohere Rerank 4 és a Voyage rerank-3 az aktuális sorozatok. Saját üzemeltetésre a bge-reranker-v2-m3 (0.6B, Apache-2.0) elterjedt többnyelvű alapválasztás, alternatívaként a Qwen3-Reranker, a Jina Reranker v3.5 és az mxbai-rerank-v2 jöhet szóba. Egy kis kiértékeléssel döntsön a saját lekérdezésein.
Mennyibe kerül az újrarangsorolás?
A Cohere 1000 keresésenként 2,00 dollárt kér a Rerank 4 Fastért és 2,50-et a Rerank 4 Próért, ahol egy keresés egy lekérdezés legfeljebb 100 dokumentummal. A Voyage millió tokenenként 0,05 dollárt kér a rerank-3-ért és 0,02-t a rerank-3-lite-ért. Saját üzemeltetésnél lekérdezésenként k pár pontozásának számítási költsége jelentkezik.
Hány dokumentumot rangsoroljak újra?
Kezdjen 50–100 jelölttel, és adjon vissza 5–20-at. Az Azure AI Search alapból a top 50-et rangsorolja újra. A késleltetés lineárisan nő a párok számával, ezért mérje a recallt a választott k mellett és a többletkésleltetést, és ne növelje tovább k-t, ha a recall már nem javul.
Kiváltja a reciprocal rank fusion a rerankert?
Általában nem. Az RRF modell nélkül, rangaritmetikával fésüli össze több visszakereső rangsorát, olcsón és robusztusan. A reranker elolvassa a szöveget, és javítani tudja a sorrendet az összefésült listán belül. Sok rendszer RRF-fel egyesíti a BM25- és vektoros találatokat, majd a lista elejét rerankerrel rendezi.