Blog/LLMOps és értékelés
Strukturált kimenet JSON Schemával: mit fed le a garancia, és mit nem
Hogyan működik a strukturált kimenet és a korlátozott dekódolás az OpenAI, Claude, Gemini és vLLM esetén, mely sémaszabályok számítanak, és mit validálj.
Balázs Csorba··9 perc olvasás
- Structured outputs
- JSON Schema
- Constrained decoding
- LLM APIs
- Validation
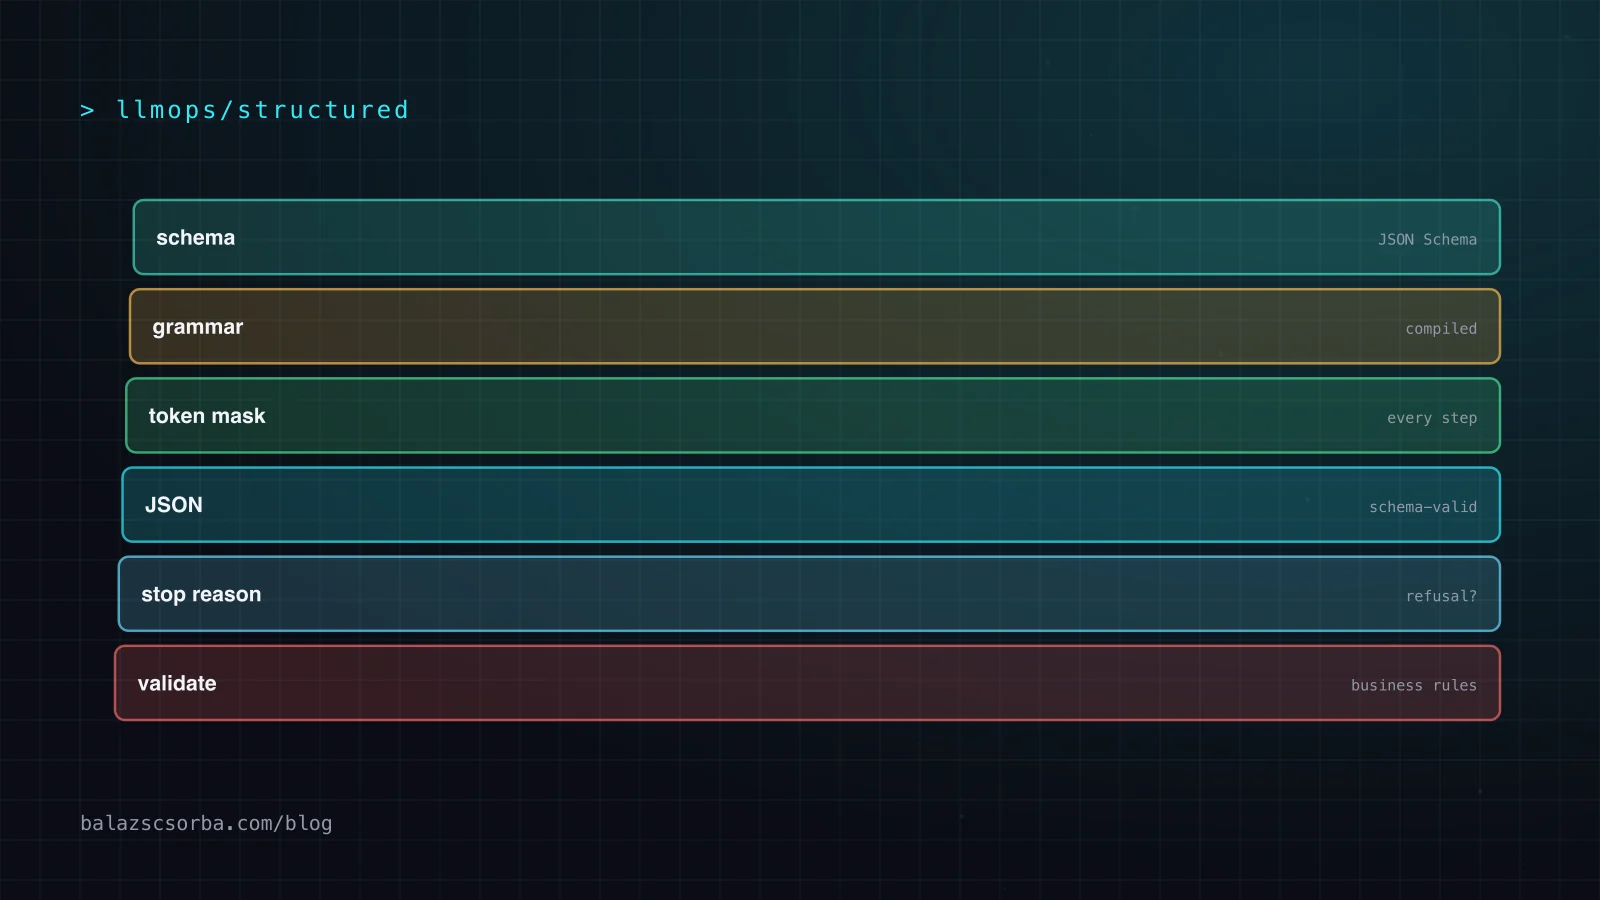
A lényeg röviden
- A strukturált kimenet a JSON Schemádat nyelvtanná fordítja és kimaszkolja az érvénytelen tokeneket, így a válasz eleve parse-olható és megfelel a sémának.
- A JSON mód csak érvényes JSON-t garantál; a strukturált kimenet a formát is, a szigorú eszközök pedig ugyanezt az eszközargumentumokra alkalmazzák.
- Az OpenAI, a Claude és a Gemini a JSON Schema más-más részhalmazát támogatja; a metszetre tervezz kötelező mezőkkel, nullal és additionalProperties: false beállítással.
- Az elutasítás, a max_tokens miatti csonkolás, az enum írásmódja és az elutasított séma dokumentált kivételek, saját kódággal.
- Egy sémának megfelelő objektum is lehet hibás, ezért a hivatkozásokat és a hihetőséget kódban ellenőrizd, a minőséget pedig mérd sémával és séma nélkül.
Ha megkérsz egy modellt, hogy "JSON-ban válaszoljon", az addig működik, amíg egyszer nem: egy megjegyzés a végén, egy hiányzó mező, egy string ott, ahol a kódod számot vár. A strukturált kimenetek (structured outputs) ennek a problémának a szintaktikai felét oldják meg. A szolgáltató a JSON Schemádat nyelvtanná fordítja, és a modell csak olyan tokeneket adhat ki, amelyekkel a kimenet érvényes marad, így a válasz eleve parse-olható és megfelel a sémának. Az OpenAI, az Anthropic, a Google és a nyílt forráskódú inferenciaszerverek mind kínálnak már ilyet.
A másik fele továbbra is a te dolgod. Egy sémának megfelelő objektumban is lehet rossz ügyfél, kitalált dátum vagy egy elutasítás. Ez az útmutató bemutatja, hogyan működik a korlátozott dekódolás (constrained decoding), miben különbözik a három nagy API, mely sémaszabályokon csúsznak el a legtöbben, mely hibaeseteket nem fed le a garancia, és milyen validációs rétegnek kell mögötte állnia.
JSON mód, strukturált kimenetek és szigorú eszközök
Három szint létezik, és könnyű összekeverni őket. A csak promptban kért JSON egy utasítás, semmi több. A JSON mód szintaktikailag érvényes JSON-t garantál, de a te szerkezetedet nem: az OpenAI útmutatója szerint mindkét mód érvényes JSON-t ad, de "csak a Structured Outputs biztosítja a séma betartását". A JSON módnak saját csapdája is van: ha a prompt nem említi a JSON-t, a modell végtelen szóközfolyamot generálhat, ezért az OpenAI API elutasítja a JSON módú kérést, ha a "JSON" szó sehol sem szerepel a kontextusban.
A strukturált kimenet a végső választ köti sémához. A szigorú eszközhasználat ugyanezt a garanciát az eszközök argumentumaira alkalmazza: állítsd be a strict: true mezőt az eszköz definíciójában, és a modell által küldött argumentumok megfelelnek az eszköz bemeneti sémájának. Az elsőt akkor használd, amikor a modell a kódodnak válaszol, a másodikat, amikor a modell hívja meg a kódodat. Az Anthropic API-ban a kettő egy kérésben is kombinálható.
Hogyan működik a korlátozott dekódolás
Minden generálási lépésben a modell valószínűséget rendel a szókincse minden tokenjéhez. A korlátozott dekódolás egy, a sémádból levezetett állapotgépet követ, és kimaszkol minden olyan tokent, amely az adott ponton érvénytelenné tenné a kimenetet. Egy nyitó kapcsos zárójel és egy kötelező kulcs után a záró zárójel egyszerűen nem választható. A tartalmat továbbra is a modell választja; a nyelvtan csak azokat a lehetőségeket veszi el, amelyek nem vezethetnek érvényes kimenethez.
A nyelvtan lefordítása időbe kerül. Az Anthropic dokumentációja szerint egy új sémával küldött első kérés extra késleltetéssel jár, amíg a nyelvtan lefordul, a lefordított nyelvtanokat pedig az utolsó használattól számítva 24 órán át gyorsítótárazzák. A séma szerkezetének vagy az eszközök körének módosítása érvényteleníti a gyorsítótárat; ha csak egy name vagy description mezőt változtatsz, az nem. Az OpenAI hasonló első kérés körüli késést csak finomhangolt modelleknél említ. A gyakorlatban: tartsd a sémákat stabilan és verziózva, és deploy után melegítsd be őket, ha nem az első felhasználónak kell kifizetnie a fordítást.
OpenAI, Claude, Gemini és vLLM összehasonlítva
Mind a négy elfogad JSON Schemát, mind a négy csak egy részhalmazát támogatja, és a részhalmazok eltérnek. A jelenlegi dokumentációk szerint:
| Bekapcsolás | Fontos sémaszabályok | Dokumentált korlátok | |
|---|---|---|---|
| tagchildren | text.format a type: "json_schema" és strict: true értékekkel (Responses API) | Minden mező kötelező (opcionális mező null unióval utánozható); additionalProperties false; nincs allOf, not, if/then/else; a kulcsok sémasorrendben jönnek | Legfeljebb 5000 objektumtulajdonság, 10 beágyazási szint, 1000 enum érték |
| tagchildren | output_config.format; eszközöknél strict: true | Az additionalProperties értéke csak false lehet; nincs szám- vagy hosszkorlát; a minItems csak 0 vagy 1; a kötelező mezők az opcionálisak előtt jönnek | Kérésenként 20 szigorú eszköz, 24 opcionális paraméter, 16 unió típusú paraméter |
| tagchildren | response_format a mime_type: application/json és schema mezőkkel | Támogatja: enum, format, minimum/maximum, minItems/maxItems, prefixItems; null típustömbbel | "A nagyon nagy vagy mélyen beágyazott sémákat elutasíthatja" |
| tagchildren | structured_outputs (json, regex, choice, grammar) | Backendek: xgrammar vagy guidance; a régi guided_json mezőket a v0.12.0 eltávolította | Backendtől és modelltől függ |
A táblázat két részlete okozza a legtöbb meglepetést. Először: eltérnek a sorrendszabályok. Az OpenAI sémasorrendben adja ki a kulcsokat, a Claude előre teszi a kötelező mezőket, utánuk az opcionálisakat. Ha számítasz a sorrendre (például részobjektumokat streamelsz egy felületre), tegyél minden mezőt kötelezővé. Másodszor: a Claude korlátai egy kérés összes szigorú sémájára együtt számítanak, így négy szigorú eszköz, egyenként hat opcionális paraméterrel, már eléri a 24-es határt. Ha az összesített nyelvtan túl nagy, 400-as hibát kapsz "Schema is too complex for compilation" üzenettel.
Sématervezési szabályok, amelyek minden szolgáltatónál működnek
Ha egy sémának több szolgáltatónál is futnia kell, a metszetükre tervezd. Ezeket a szabályokat használom:
- Minden mező legyen kötelező, az "ismeretlen" pedig null. A
["string", "null"]típus egyértelmű, és mindenhol működik; egy hiányzó kulcs kétértelmű. A Claude-nál az unió típusok beleszámítanak a 16 paraméteres korlátba, ezért csak ott használd, ahol a null valódi válasz. - Minden objektumon legyen additionalProperties: false. A Claude és az OpenAI szigorú módja megköveteli, és megakadályozza, hogy a modell olyan mezőket találjon ki, amelyeket a kódod csendben figyelmen kívül hagy.
- Ahol elágazol, ott enum legyen, ne szabad szöveg. Státusz, kategória, szándék. Az enum értékeket ettől függetlenül kis- és nagybetűtől függetlenül hasonlítsd össze: a Claude dokumentációja figyelmeztet, hogy az enum és const értékek írásmódja nem garantált.
- A szabályok a leírásba kerüljenek, ne korlátokba. A Claude nem támogatja a minLength, maximum és hasonló kulcsszavakat; írd a leírásba, hogy "ISO 4217 kód, három betű", és ellenőrizd kódban.
- Legyen lapos és kicsi. A beágyazás, az uniók és az opcionális paraméterek megsokszorozzák a nyelvtan méretét. Két egyszerű hívás gyakran jobb, mint egy séma, amely mindent egyszerre akar lefedni.
- Építs be egy kifejezett kiutat. Egy olyan mező, mint a
"confidence": "low" | "high"vagy a"not_found": true, érvényes módot ad a modellnek arra, hogy jelezze: nem tudja a választ. Enélkül a séma kikényszerít egy választ.
Típusos kinyerés TypeScriptben
Az SDK-k elrejtik a séma körüli munkát. Az Anthropic TypeScript SDK-ban a Zod sémát zodOutputFormat() hívásba csomagolod, és meghívod a client.messages.parse() metódust, amely output_config.format mezőként küldi el, és típusos parsed_output értéket ad vissza. Az OpenAI megfelelője a responses.parse() a zodTextFormat() segítségével. Amit az SDK nem tud elvégezni helyetted, az a leállási ok ellenőrzése és az utána következő üzleti szabály:
import Anthropic from "@anthropic-ai/sdk";
import { zodOutputFormat } from "@anthropic-ai/sdk/helpers/zod";
import { z } from "zod";

const OrderLine = z.object({
  sku: z.string().describe("Article number exactly as written in the email"),
  quantity: z.number().int().describe("Ordered quantity, a positive integer"),
  unit: z.enum(["piece", "box", "pallet"]),
  delivery_date: z.string().nullable().describe("ISO date, or null if none given"),
});
const Order = z.object({ lines: z.array(OrderLine), not_an_order: z.boolean() });

const client = new Anthropic();
const res = await client.messages.parse({
  model: "claude-opus-5-5",
  max_tokens: 4096,
  messages: [{ role: "user", content: `Extract the order lines:\n\n${email}` }],
  output_config: { format: zodOutputFormat(Order) },
});

if (res.stop_reason === "refusal" || res.stop_reason === "max_tokens") {
  throw new Error(`no usable output: ${res.stop_reason}`);   // schema not guaranteed here
}
const order = res.parsed_output!;
for (const line of order.lines) {
  if (line.quantity <= 0 || !(await skuExists(line.sku))) {   // business rules: your job
    await queueForHumanReview(email, order);
    break;
  }
}
A Zod-megkötések (.int(), a leírások) így is segítenek: a leírás útmutatásként eljut a modellhez, és a Order.parse() hívást magad is lefuttathatod, ha egy második, helyi ellenőrzést szeretnél azokra a korlátokra, amelyeket a szolgáltató nem kényszerít ki.
Amikor a garancia nem érvényes
A "garantált sémamegfelelésnek" vannak dokumentált kivételei, és mindegyikhez kell egy kódág:
- Elutasítás. A Claude HTTP 200 mellett
stop_reason: "refusal"értéket ad vissza, és a kimenet ilyenkor nem feltétlenül felel meg a sémának. Az OpenAI különrefusalmezőt tesz a válaszba. Az Anthropic arra is figyelmeztet, hogy egy olyan mező, amely a modell lépésenkénti gondolatmenetét kéri, gondolatmenet-kinyerés miatti elutasítást válthat ki; kérj inkább rövid indoklást. - Csonkolás. Ha a válasz eléri a
max_tokens(Claude) vagy amax_output_tokens(OpenAI,incompletestátusz) korlátot, a JSON félbeszakad. Emeld a korlátot, vagy csökkentsd a kimenetet; soha ne parse-old optimistán. - Enum írásmód. Lásd fent: kis- és nagybetűtől függetlenül hasonlíts.
- Elutasított séma. A nem támogatott kulcsszavak vagy a túl nagy összetettség még a generálás előtt 400-as hibát adnak. Minden sémát a CI-ban tesztelj, ne élesben először.
- Funkcióütközés. A Claude-nál a hivatkozások (citations) és a strukturált kimenet nem kombinálhatók (400), ahogy az előre kitöltött válasz (prefill) sem. Ha forrásolt válasz és JSON is kell, csináld két lépésben.
Rontja-e a formátumkényszer a válasz minőségét?
Ez a legtöbbet vitatott kérdés, és a bizonyítékok mindkét irányba mutatnak. A "Let Me Speak Freely?" (Tam és tsai., 2024) "az érvelési képesség jelentős romlásáról" számolt be formátumkényszer mellett, és minél szigorúbb volt a kényszer, annál nagyobb volt a romlás. A JSONSchemaBench (Geng és tsai., 2025) javított prompttal három feladatot újrafuttatott, és ennek az ellenkezőjét találta: minden korlátozott dekódolású keretrendszer elérte vagy meghaladta a kényszer nélküli alapszintet, a Guidance például 83,8%-ot ért el a GSM8K-n a modell önmagában mért 80,1%-ával szemben.
Az én olvasatom: a prompt és a séma kialakítása többet számít, mint maga a mechanizmus. Az árt, ha a modellnek egy válaszmezőben el kell köteleznie magát, mielőtt végiggondolta volna a feladatot. Két megoldás működik. Érvelő modelleknél a gondolkodás a thinking blokkokban történik: a Claude nyelvtana ott nem érvényes, a modell szabadon gondolkodik, és csak a végső válasz kötött. Más modelleknél tegyél egy rövid explanation mezőt az answer mező elé (az OpenAI sémasorrendben adja ki a kulcsokat). És mérd meg a saját feladatodon, egy kis eval készlettel, sémával és séma nélkül is.
A séma mögötti validációs réteg
Kezeld a modell kimenetét úgy, mint egy nem megbízható kliens bemenetét: parse-olás, validálás, csak utána cselekvés. A séma megszüntet egy hibaosztályt (szintaxis és forma), így a többi ellenőrzés egyszerűbb lesz, de nem válik elhagyhatóvá. Ezt teszem minden strukturált hívás mögé:
- Leállási ok kapu. Minden, ami nem normál befejezés, hibaágra megy.
- Hivatkozási ellenőrzések. Az azonosítókat, cikkszámokat, ügyfélszámokat és dátumokat a saját adataidban keresd vissza. Itt bukkan fel a legtöbb valódi hiba, és itt a megalapozás (grounding) fontosabb, mint a formátum.
- Hihetőségi szabályok. Küszöb feletti mennyiségek, múltbeli dátumok, végösszegek, amelyek nem jönnek ki.
- Egy javítási kísérlet, utána ember. A validációs hibát egyszer küldd vissza; ha továbbra is hibás, az eset kerüljön ellenőrzési sorba, ne ciklusba.
- Naplózd a séma verzióját. Ha módosítasz egy sémát, a régi trace-eknek értelmezhetőnek kell maradniuk, az evaloknak pedig az éles verzió ellen kell futniuk.
Az olyan könyvtárak, mint a Pydantic AI és a Guardrails AI, ennek a ciklusnak egyes részeit csomagolják. Útválasztási és osztályozási döntésekhez, ahol azt is tudnod kell, mennyire biztos a modell, lásd a kalibrált bizonyosságú típusos döntésekről szóló cikket.
Strukturált kimenet saját üzemeltetésű modelleken
A vLLM xgrammar vagy guidance backenddel támogatja a strukturált kimenetet, az OpenAI-kompatibilis szerverén keresztül (response_format JSON Schemával) vagy a structured_outputs paraméterrel, amely reguláris kifejezést, rögzített választási listát vagy környezetfüggetlen nyelvtant is elfogad. Ha régebbi vLLM-ről frissítesz: a guided_json, guided_regex és a rokon mezőket a v0.12.0 eltávolította. A vLLM a strukturált kimenetet érvelési parserekkel is kombinálja, így egy érvelő modell szabadon gondolkodhat, és mégis kötött JSON-t ad vissza.
Itt a JSONSchemaBench a hasznos viszonyítási pont: 10 000 valós sémán tesztelte a Guidance, az Outlines, a llama.cpp, az XGrammar, az OpenAI és a Gemini hatékonyságát, lefedettségét és minőségét, és azt találta, hogy egyik motor sem volt minden esetben a legjobb. Ha saját magad üzemeltetsz, futtasd át a saját sémáidat a választott backenden, mielőtt elköteleződsz mellette.
Ellenőrzőlista
- Válaszokhoz strukturált kimenetet (ne JSON módot), eszközargumentumokhoz szigorú eszközöket használj.
- A metszetre tervezz: minden mező kötelező, ismeretlenre null, additionalProperties false, enum mindenhez, amin elágazol.
- Minden sémát ellenőrizz a CI-ban az egyes szolgáltatók korlátai ellen.
- Az elutasítást és a csonkolást a parse-olás előtt kezeld.
- Az enumokat kis- és nagybetűtől függetlenül hasonlítsd össze.
- A hivatkozásokat és a hihetőséget kódban ellenőrizd; egy javítási kísérlet, utána ember.
- Verziózd a sémákat, naplózd a verziót minden trace-szel, és deploy után melegítsd be az új sémákat.
- Mérd a minőséget sémával és séma nélkül a saját eval készleteden.
Ha mindezt egy Nuxt frontendbe építed, a Nuxt LLM-funkciókról szóló útmutató bemutatja a streamelési oldalt. Kinyerési pipeline-ok tervezéséhez lásd az AI engineering oldalt.
Források
- OpenAI API docs: Structured model outputs
- Claude API docs: Structured outputs
- Gemini API docs: Structured outputs
- vLLM docs: Structured Outputs
- Tam et al.: Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of LLMs (2024)
- Geng et al.: JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models (2025)
Gyakori kérdések
Mi a különbség a JSON mód és a strukturált kimenet között?
A JSON mód szintaktikailag érvényes JSON-t garantál, de azt nem, hogy a szükséges mezők és típusok benne lesznek. A strukturált kimenet a generálást a JSON Schemádhoz köti, így a válasz megfelel a sémának, kivéve a dokumentált eseteket, például elutasításnál vagy csonkolásnál. Használd mindig, amikor a szolgáltató és a modell támogatja.
Rontja-e a strukturált kimenet az LLM válaszait?
A bizonyítékok vegyesek. Egy 2024-es tanulmány gyengébb érvelést mért szigorú formátumkényszer mellett, a 2025-ös JSONSchemaBench viszont javított prompttal a kényszer nélküli alapszinttel egyező vagy jobb eredményt talált. Hagyd, hogy a modell végiggondolja a feladatot, mielőtt egy válaszmezőben elkötelezi magát, akár thinking blokkokban, akár egy elöl álló indoklásmezőben, és mérd meg a saját feladatodon.
Szigorú módban is validálnom kell a kimenetet?
Igen. A séma a formát garantálja, nem az igazságot. Ellenőrizd a leállás okát, keresd vissza az azonosítókat és cikkszámokat a saját adataidban, alkalmazz hihetőségi szabályokat, a hibás eseteket pedig küldd egy javítási kísérletre, majd emberhez.
Miért ad 400-as hibát a JSON sémám?
Általában azért, mert olyan kulcsszót használ, amelyet a szolgáltató nem támogat, például allOf az OpenAI-nál vagy minLength a Claude-nál, vagy mert túl nagy az összesített összetettség. A Claude a 20 szigorú eszközös, 24 opcionális paraméteres és 16 unió típusú paraméteres korlátját egy kérés összes sémájára együtt számolja.
Hogyan tehetek opcionálissá egy mezőt az OpenAI szigorú módjában?
A szigorú mód megköveteli, hogy minden mező szerepeljen a required listában. Az opcionális mezőt egy nullt tartalmazó unióval utánozhatod, például string vagy null típussal, és a kódodban a nullt ismeretlenként kezeled.