Eszközök/LLMOps és értékelés
DeepEval bemutató: pytest az LLM-kimenetekhez, és a bíró számlája
A DeepEval LLM-ellenőrzéseket futtat pytest-szerű tesztként, beépített bírómetrikákkal. Ingyenes könyvtár; a bíróhívások és az adatáramlás a valódi költség.
- Típus
- Evaluation framework
- Ár
- Apache-2.0 · free; Confident AI from $0, Starter $200 a month
Balázs Csorba··8 perc olvasás
- LLM evaluation
- pytest
- LLM-as-a-judge
- Red teaming
- Open source
A lényeg röviden
- A DeepEval Apache-2.0 licencű Python-keretrendszer, amely az LLM-ellenőrzéseket egységtesztként futtatja, és a könyvtár fiók nélkül is működik.
- A legtöbb beépített metrika egy másik modellt használ bíróként, ezért minden futás költhet tokeneket, és eltérő pontszámot adhat.
- Az alapbeállításban a bíró az OpenAI, így a tesztesetek elhagyják a hálózatodat. Egy helyi bíró, például az Ollama, bent tartja őket, de a minőségét neked kell mérned.
- A Confident AI felhője ingyenes csomagot kínál, a Starter havi $200, a Team havi $2000, minden ügyfélnek adatfeldolgozási szerződéssel, és minden csomagban EU-régióval.
- Válaszd a Ragas-t, a Promptfoo-t vagy a Braintrust-ot, ha Apache-2.0 metrikakészletet, deklaratív CLI-t red teaminggel vagy saját díjszabású, hosztolt felületet akarsz.
A DeepEval egy nyílt forrású Python-keretrendszer, amely az LLM-ellenőrzéseket egységtesztként futtatja, több mint harminc beépített metrikával és egy opcionális felhőplatformmal, a Confident AI-val. Az ítélet előre: vedd, ha a mérnökeid Pythonban írnak, már futtatnak teszteket a CI-ben, és minden pull requestnél ellenőrizni akarod a modell viselkedését. Hagyd ki, ha az alapértelmezett OpenAI-bíró nem fogadható el az adataidhoz, vagy ha a nem mérnökök előbb egy hosztolt munkaterületet várnak.
A DeepEval a Ragas, a Promptfoo és a Braintrust mellett áll, amelyeket külön is bemutattam. A tesztek körüli folyamatról, a kézi trace-olvasástól a CI-kapuig, lásd: LLM-értékelések termékfunkciókhoz.
Mi ez
A DeepEval az Apache-2.0 könyvtár a Confident AI mögött, amely magát vállalati AI-értékelési és megfigyelhetőségi platformként írja le. A könyvtár a saját gépeden fut, és nem kell hozzá fiók. A PyPI-n az aktuális kiadás a 4.2.8, amelyet 2026. október 2-án adtak ki, és Python 3.9-es vagy újabb verzió kell hozzá. Telepítés: pip install -U deepeval.
- Metrikák. Több mint harminc nevesített metrika kilenc csoportban, a G-Eval-tól és az ágens-metrikáktól a visszakeresésen, a többfordulós beszélgetéseken, a biztonságon és a képeken át.
- Bírók. Szinte minden beépített metrika LLM-et használ bíróként, és OpenAI, Azure OpenAI, Anthropic, Gemini, Ollama vagy LiteLLM bírót állíthatsz be.
- Red teaming. Külön Apache-2.0 csomag, a DeepTeam fedi a támadásokat és a sebezhetőségeket.
Hogyan működik
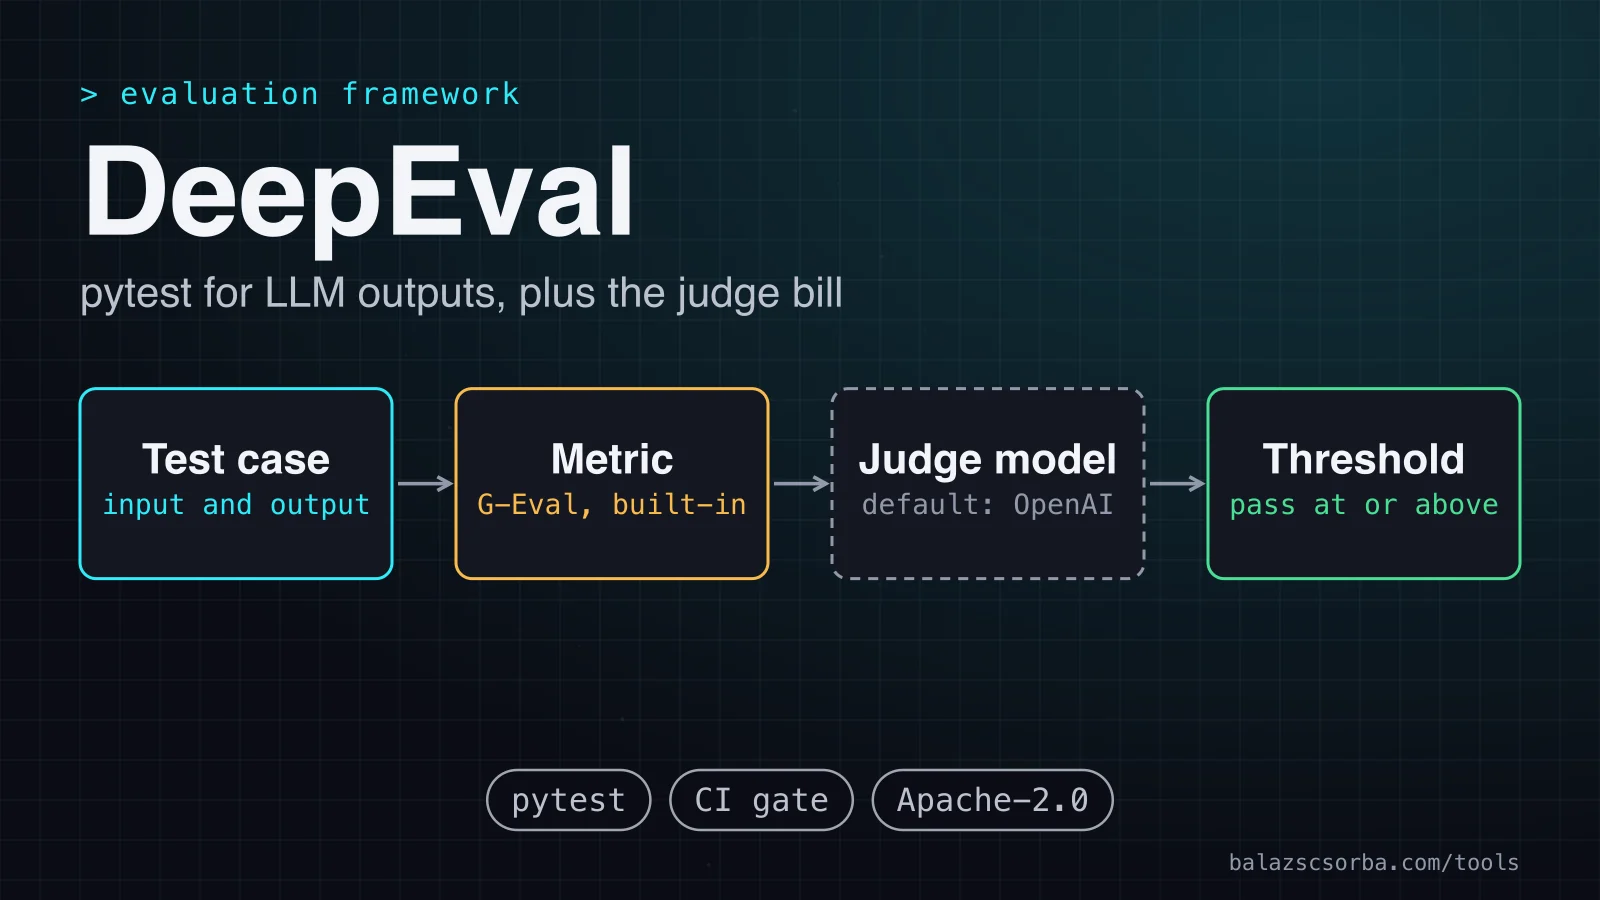
A teszt sima Python. Minden metrika egy tesztesetet kap, amely tartalmazza a bemenetet, a tényleges kimenetet és a metrikától függően a várt kimenetet, a visszakeresési kontextust vagy az ágens által hívott eszközöket. Bíró-alapú metrikánál a tesztesetet és a kritériumokat a bírómodell kapja, amely 0 és 1 közötti pontszámot és indoklást ad vissza. A küszöbérték dönt átmenetről vagy elbukásról, az assert_test pedig elbuktatja a tesztet, ha a pontszám alatta marad.
A bíró az, ami a költséget és a megbízhatóságot meghatározza. A metrikaoldal szerint szinte minden beépített metrika LLM-et használ bíróként, és bármely bíró használható, köztük az OpenAI, az Azure OpenAI, az Ollama, az Anthropic, a Gemini és a LiteLLM. A saját modelledet is becsomagolhatod a DeepEvalBaseLLM leszármaztatásával. A GYIK szerint a bíró alapértelmezetten az OpenAI, ha nem adsz meg modellt.
Első lépések
Állíts be egy OpenAI-kulcsot a bírónak, telepítsd a csomagot, és írd meg a tesztet egy olyan fájlban, mint a test_example.py. A példa egy választ ellenőriz G-Eval-lal, ahol a kritériumokat közérthetően írod le, és a DeepEval ebből generálja az értékelési lépéseket. Futtasd így: deepeval test run test_example.py. A teszt elbukik, ha a helyességi pontszám 0,5 alatt van.
# test_example.py
from deepeval import assert_test
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCase, SingleTurnParams


def test_refund_answer():
    correctness = GEval(
        name='Correctness',
        criteria='Is the actual output a correct answer to the input, consistent with the expected output?',
        evaluation_params=[
            SingleTurnParams.INPUT,
            SingleTurnParams.ACTUAL_OUTPUT,
            SingleTurnParams.EXPECTED_OUTPUT,
        ],
        threshold=0.5,
    )
    test_case = LLMTestCase(
        input='Can I return shoes after 30 days?',
        actual_output='You can return them within 30 days of delivery, if they are unworn.',
        expected_output='Returns are accepted within 30 days of delivery if the item is unworn.',
    )
    assert_test(test_case, [correctness])
Metrikák, és mibe kerül a bíró
A metrika megválasztása dönt a számláról. A Faithfulness kinyeri a válasz állításait, mindegyiket ellenőrzi a visszakeresési kontextus ellen, és az állításoknak azt a hányadát pontozza, amely nem mond ellent a kontextusnak, az alapértelmezett küszöb 0,5. A bíró többet olvas, ha egy válasz sok állítást tesz, ezért a költség a válasz hosszával nő. Az evaluate() gyorsítótárazást, párhuzamosítást, költségkövetést és hibakezelést ad, a különálló measure()-hívás viszont ezeket az optimalizálásokat elveszíti. A dokumentáció arra is figyelmeztet, hogy sok metrikahívás egyszerre rate-limit hibát okozhat, ezért a párhuzamosságot igazítsd a szolgáltatód korlátjához.
| Csoport | Nevesített metrikák |
|---|---|
| Egyedi | G-Eval, DAG, Arena G-Eval, JevEval, és saját kódmetrikák, például BLEU vagy ROUGE |
| Ágensek, pályák | Task Completion, Step Efficiency, Plan Adherence, Plan Quality |
| Ágensek, komponensek | Tool Correctness, Argument Correctness |
| Visszakeresés | Contextual Relevancy, Contextual Precision, Contextual Recall |
| Generátor | Answer Relevancy, Faithfulness |
| Többfordulós csevegők | Knowledge Retention, Role Adherence, Conversation Completeness, Conversation Relevancy |
| Biztonság | Bias, Toxicity, Non-Advice, Misuse, PIILeakage, Role Violation |
| Kép | Image Coherence, Image Helpfulness, Image Reference, Text-to-Image, Image-Editing |
| Egyéb | Hallucination, JSON Correctness, Summarization, Ragas |
Goldenek, red teaming és CI
A kézzel írt tesztesetek gyorsan elfogynak, ezért a DeepEval generálhat is. A generate_goldens_from_docs dokumentumelérési utak listáját kapja, beolvassa a .txt, .docx, .pdf és Markdown fájlokat, a darabokat chromadb-ben tárolja, és egy kritikusmodell 0 és 1 közötti pontszámmal értékeli minden darabot. Alapértelmezés szerint minden goldenhez tartozik elvárt kimenet is. OpenAI-kulcs nélkül saját beágyazó modellt és saját LLM-et kell megadnod, mert az alapértelmezett beágyazó a text-embedding-3-small. A dokumentáció nem ír le felülvizsgálati lépést, ezért kérj meg valakit, hogy olvasson el egy mintát, mielőtt a generált készlet regressziós csomaggá válik.
A red teaming külön csomag. A DeepTeam egy Apache-2.0 keretrendszer LLM-ek és KI-ágensek red teaming-tesztelésére, több mint 50 kész sebezhetőséggel és több mint 20 kutatásalapú támadási módszerrel, egy- és többfordulós formában. Bíró-alapú metrikái helyben futnak, és indoklással együtt átmenet vagy elbukás eredményt adnak. Ellenőrzéseit az OWASP Top 10 for LLMs 2025, az OWASP Top 10 for Agents 2026, a NIST AI RMF és a MITRE ATLAS szerint sorolja be, telepítése: pip install -U deepteam. A platform AI red teaming modulja az árazási oldal szerint az Enterprise ++ csomagban van.
A dokumentáció CI-mintája rövid. A bíró kulcsát OPENAI_API_KEY néven tárold a titkos adatok között, a CONFIDENT_API_KEY-t csak akkor add hozzá, ha az eredményeknek a platformra kell kerülniük, és futtasd a deepeval test run parancsot. Kulcs nélkül ugyanezek a tesztek helyben is lefutnak. A --official (vagy -o) kapcsolóval egy futtatást hivatalos alapvonalként jelölhetsz a Confident AI-n.
- name: Run LLM tests
  env:
    OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
    CONFIDENT_API_KEY: ${{ secrets.CONFIDENT_API_KEY }}
  run: poetry run deepeval test run test_llm_app.py
Költség és üzemeltetés
A könyvtár a bíró mellett nem kerül semmibe. A platformnak négy csomagja van, havonta, szervezetenként számlázva, és az árazási oldalon nincs dátum, ezért tervezés előtt ellenőrizd újra.
| Csomag | Ár | Tartalmazza | Mit ad hozzá |
|---|---|---|---|
| Free | $0 | 2 férőhely, 1 projekt, 1 GB-hónap nyomkövetési adat | heti 5 tesztfuttatás |
| Starter | havi $200 | Korlátlan férőhely, 5 projekt, 5 GB-hónap, utána GB-hónaponként $1 | Online értékelések, annotációs sorok, valós idejű riasztás |
| Team | havi $2000 | Korlátlan férőhely és projekt, 75 GB-hónap, utána GB-hónaponként $1 | SOC 2, SSO, saját szerepkörök, egyedi szerződések és SLA-k |
| Enterprise | Egyedi | Korlátlan használat | On-prem, egyedi adatrezidencia, 24x7 támogatás, red teaming modul (Enterprise ++) |
Összehasonlításként: a Braintrust Starter szintje ingyenes, 14 napos megőrzéssel, a Pro csomagja havi $249, a feldolgozott adat GB-onként $3, a pontszámok pedig 1000-enként $1,50, a benne foglalt mennyiségen felül. A Confident AI Starter csomagja fix havi $200, férőhelydíj nélkül, és tartalmazza az online értékeléseket és az annotációs sorokat.
Három külön adatáramlás van, és más-más kérdésre válaszolnak. A bíró megkapja a tesztesetet, tehát modell beállítása nélkül ez a tartalom az OpenAI-hoz megy, a laptopodról vagy a CI-futtatóról. A Confident AI csak akkor kap eredményeket, ha a CONFIDENT_API_KEY be van állítva, és a GitHub README szerint a felhőplatform használatakor minden tesztesetet automatikusan naplóz a rendszer. A harmadik a telemetria: alapértelmezés szerint a DeepEval alapvető, nem azonosító számokat küld, például hány értékelés futott és mely metrikákat használták, az adatvédelmi oldal pedig a PostHogot nevezi meg az egyetlen célnak. A DEEPEVAL_TELEMETRY_OPT_OUT=1 beállítással kikapcsolhatod.
A platformon a GYIK szerint az adatokat egy privát AWS-felhőben tárolják, amelyhez csak a szervezeted fér hozzá. Az alapértelmezett régió az Egyesült Államok, az EU pedig minden csomagban elérhető. Bejelentkezéskor vagy regisztrációkor válaszd ki, vagy futtasd a deepeval set-confident-region EU parancsot, amely csak a DeepEvalt állítja be. A régióoldal hozzáteszi, hogy az API-kulcs önmagában nem dönti el, hová kerülnek az adatok, ezért a két végpontot is állítsd be.
deepeval set-confident-region EU
export CONFIDENT_BASE_URL=https://eu.api.confident-ai.com
export CONFIDENT_OTEL_ENDPOINT=https://eu.otel.confident-ai.com/v1/traces
A szerződéshez: az alvállalkozói lista, amelyet utoljára 2026. február 18-án módosítottak, azt mondja, hogy minden ügyfél adatfeldolgozási szerződést kap. A személyes adatok a kiválasztott régióban maradnak, hacsak a teljesítmény vagy a rendelkezésre állás miatt, vagy megállapodás alapján nem kell őket áthelyezni. A lista az OpenAI-t az AI-modellek futtatásához említi, csak az USA-ban, az AWS-t, a ClickHouse-t, a Supabase-t és a PostHogot pedig az USA-ban és Európában. A felhő megőrzési idejét nem találtam meg egyetlen megnyitott oldalon sem, ezért kérd írásban, mielőtt éles adat kerül be. Az önálló üzemeltetés vállalati opció, a helyi telepítés pedig ugyanezt a két változót a saját hosztjaidra állítja.
Hol gyenge
Három gyengeség a legfontosabb. Először: a pontszámok nem ismételhetők meg. A G-Eval dokumentáció szerint a metrika nem determinisztikus, ezért a küszöb közeli pontszám néha átbillen, és a bíró korlátozza mindent, amit vele mérsz. Másodszor: a felület nagy. A metrikalista hosszú, a generált goldenek dokumentumútvonalához chromadb és több LangChain-csomag kell, a dokumentáció pedig a Python-parancs mellett TypeScript-parancsot is mutat, bár ehhez a bemutatóhoz minden általam ellenőrzött példa Python volt. Harmadszor: a platform árlépcsői durvák. Az ingyenes csomag heti öt tesztfuttatása nem bír el egy forgalmas pipeline-t, és a havi $200-ról $2000-re ugrás nagy egy olyan csapatnak, amelyik csak közös előzményt akar.
Ítélet
A DeepEval az alapértelmezett jó választás olyan Python-csapatnak, amely LLM-viselkedési teszteket szeretne ugyanabban a futtatóban és ugyanabban a pull requestben, mint a többi tesztjét. A könyvtár és a DeepTeam is Apache-2.0 licencű, a metrikalista ágenseket, visszakeresést, beszélgetéseket és biztonságot fed le saját bírók írása nélkül, a helyi mód pedig fiók nélkül működik. Nem javaslom ott, ahol a tesztadatok nem érhetnek el olyan bírót, amelyben megbízol, vagy ahol a nem mérnököknek az első naptól hosztolt munkaterület kell. Ezekben az esetekben válassz alternatívát.
- Ragas, ha Apache-2.0 eszköztárat szeretnél előre elkészített metrikákkal és teszt-adatgenerálással, és nincs szükséged a Confident AI platformjára.
- Promptfoo, ha deklaratív konfigurációt szeretnél, amely promptokat és modelleket hasonlít össze a parancssorban és a CI-ben, a red teaminggel ugyanabban az eszközben. A MIT-licencelt tároló szerint a Promptfoo ma már az OpenAI része, ezt mérlegeld a szállítói szabályaiddal.
- Braintrust, ha hosztolt felületet és a Pro csomagban kattintásos adatfeldolgozási szerződést szeretnél, és elfogadod a mérésüket, ahol a benne foglalt adatokon és pontszámokon felüli használat a havi $249 mellé számlázódik.
Források
- DeepEval-dokumentáció: első lépések
- GitHub: confident-ai/deepeval, a README és a licenc
- PyPI: deepeval, a legújabb kiadás és a Python-követelmény
- DeepEval-dokumentáció: metrikák áttekintése
- DeepEval-dokumentáció: G-Eval
- DeepEval-dokumentáció: Faithfulness
- DeepEval-dokumentáció: Tool Correctness
- DeepEval-dokumentáció: goldenek generálása dokumentumokból
- DeepEval-dokumentáció: egységtesztelés CI/CD-ben
- DeepEval GYIK
- DeepEval-dokumentáció: adatvédelem
- GitHub: confident-ai/deepteam, a red teaming keretrendszer
- Confident AI árazás
- Confident AI-dokumentáció: adatrezidencia
- Confident AI alvállalkozói lista
- GitHub: explodinggradients/ragas, README
- GitHub: promptfoo/promptfoo, README
- Braintrust árazás
Gyakori kérdések
Küld a DeepEval bárhova az adataimat?
Igen, a beállított bírómodellnek. Modell megadása nélkül a GYIK szerint a bíró alapértelmezetten az OpenAI. Az eredmények csak akkor jutnak el a Confident AI-hoz, ha kulcsot állítasz be, az alapértelmezett tárolási régió az Egyesült Államok, az EU pedig minden csomagban elérhető.
Mennyibe kerül a DeepEval?
A könyvtár Apache-2.0 licenc alatt ingyenes. A Confident AI-nak van ingyenes csomagja két férőhellyel és heti öt tesztfuttatással, a Starter havi $200, a Team havi $2000, havonta, szervezetenként számlázva. A bírói hívások ezen felül jönnek, és a választott modelltől függenek.
Megismételhetők a pontszámok?
Nem pontosan. A G-Eval dokumentáció szerint a metrika nem determinisztikus, ezért hagyj tartalékot a küszöbök körül, és futtasd újra a hibás esetet, mielőtt regressziónak tekintenéd. A Tool Correctness más, mert a magpontszáma determinisztikus.
Használhatok helyi modellt bíróként?
Igen. A metrikaoldal az Ollamát is felsorolja a bírók között, bármely más modellt pedig a DeepEvalBaseLLM osztály leszármaztatásával köthetsz be. Ellenőrizd a bírót olyan eseteken, amelyeket magad címkéztél, mert egy gyengébb bíró minden pontszámot elmozdít.