Eszközök/LLMOps és értékelés
DSPy-kritika: promptok metrikához igazítva, nem kézzel
A DSPy aláírásokból, metrikából és példákból állítja elő a promptokat. Mennyibe kerül az optimalizálás modellhívásokban, és mikor éri meg a kézi prompt helyett.
- Típus
- Prompt optimisation framework
- Ár
- MIT · free, you pay the model API
Balázs Csorba··8 perc olvasás
- Prompt optimisation
- LLM programs
- MIPROv2
- GEPA
- Python
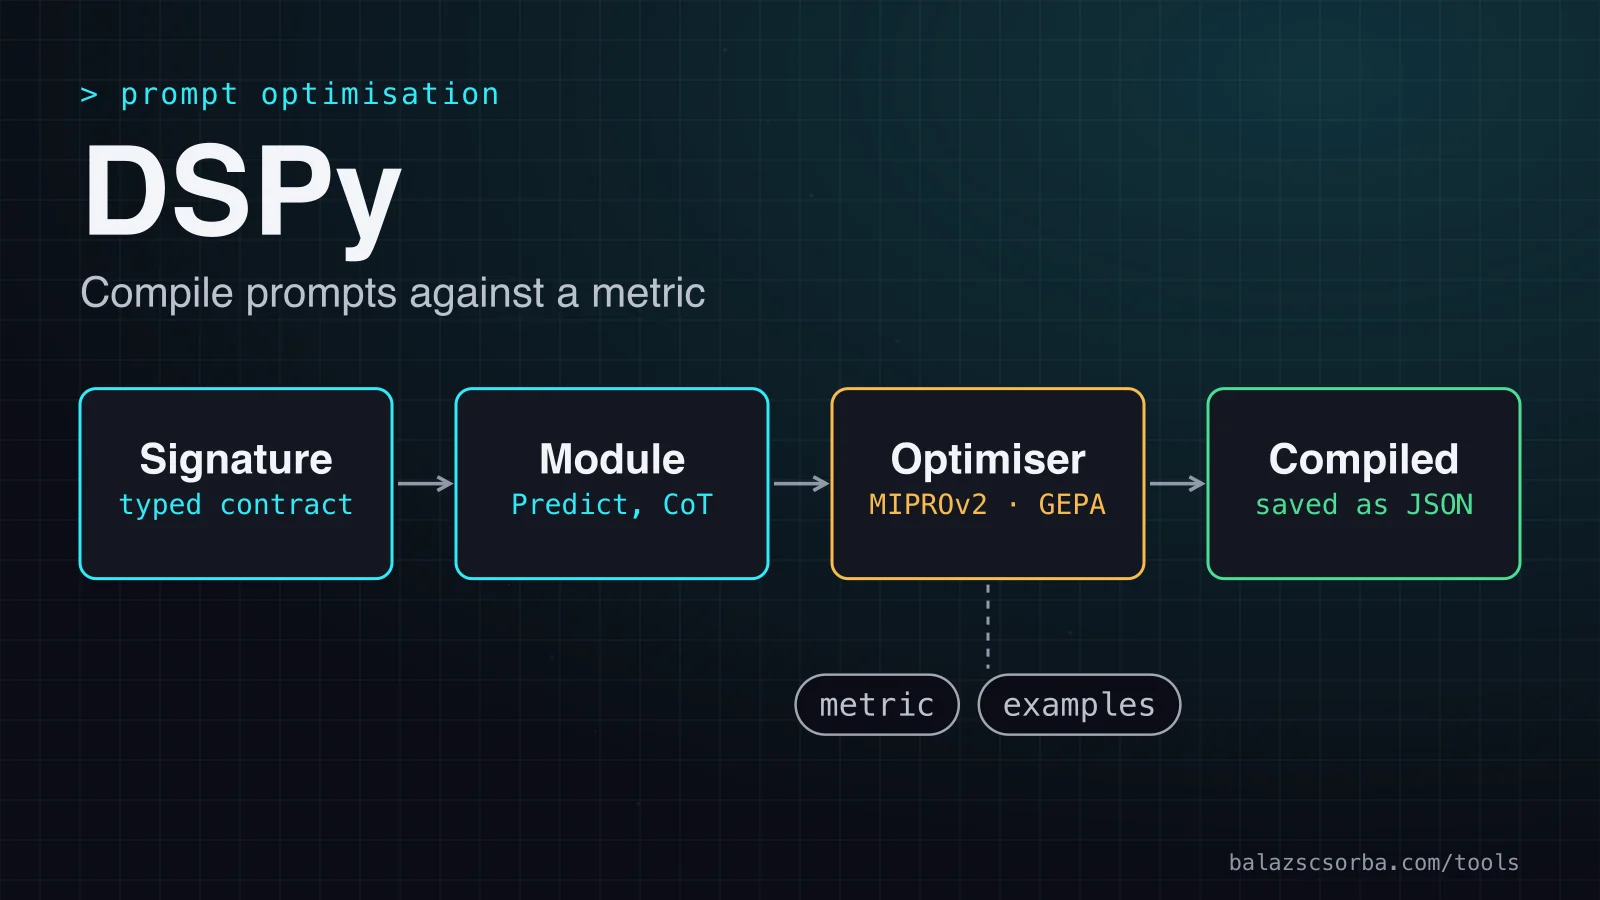
A lényeg röviden
- A DSPy aláírásokkal, modulokkal és optimalizálókkal váltja ki a kézzel írt promptokat. Az optimalizálók a te metrikád alapján keresnek jobb promptokat.
- Egy optimalizálási futás modellhívásokban fizet meg. A MIPROv2 light beállításán egy prediktoros program körülbelül 750 hívást indít a bootstrapping előtt.
- Írd meg először a metrikát. Az optimalizáló csak azt tudja javítani, amit a metrika mér, és a munka java éppen ebben a függvényben van.
- A lefordított program JSON-fájl az utasításokkal és demonstrációkkal, ezért verziókezelés kell hozzá, a demonstrációi pedig a tanítóadataid.
- Egy prompthoz, stabil modellen, egy átnézett prompt és egy eval-csomag egyszerűbb. A DSPy a változó, többlépcsős pipeline-okban éri meg.
A DSPy egy nyílt forráskódú Python-keretrendszer, amely az LLM-pipeline-t kódként kezeli. Deklarálod a bemeneteket és kimeneteket, választasz egy modult, és egy optimalizáló keresi meg azokat az utasításokat és példákat, amelyek a te metrikádon a legjobbak. Az ítélet előre: olyan többhívásos pipeline-hoz érdemes, amelyet mérni tudsz és várhatóan változni fog. Egy prompthoz, stabil modellen – egy átnézett prompt és egy eval-csomag egyszerűbb.
Mi ez
A DSPy a saját magát nyelvi modellek programozására szolgáló keretrendszerként írja le, nem a promptolásra. Az aláírások határozzák meg, mi megy be és mi jön ki. A modulok döntik el, hogyan kérdezzük a modellt, az egyszerű előrejelzéstől a lépésenkénti indoklásig vagy egy eszközhívási ciklusig. Az optimalizálók a metrikához igazítják a programot, az utasítások és a few-shot példák változtatásával. A promptolás és a finomhangolás között helyezkedik el: a prompt olyan műtárgy lesz, amelyet az optimalizáló ír meg. A szélesebb döntéshez olvasd el a promptolás, a keresés és a finomhangolás döntési útmutatóm.
- MIT-licenc, ingyenesen használható. Telepítése:
pip install dspy, Python 3.10 vagy újabb kell hozzá. - A legutóbbi kiadás a 3.4.0, szeptember 25-én jelent meg. A tárolón a megnézéskor 38.6k csillag állt.
- 14 optimalizáló az API-referenciában, a BootstrapFewShot-tól a MIPROv2-n, GEPA-n és BootstrapFinetune-on át.
- Nincs általam talált hosztolt szolgáltatás. A saját folyamatodban fut, és az általad beállított szolgáltatót hívja.
Hogyan működik
Egy modul egy aláírásból épül fel. Futáskor az adapter az aláírásból rendszerüzenetet készít, a modell válaszol, és a DSPy a válaszból kiolvassa a kimeneti mezőket. Optimalizáló nélkül a program csak annyira jó, mint a megfogalmazása. Az optimalizáló egy metrikát kap hozzá, vagyis egy Python-függvényt, amely egy előrejelzést pontoz, általában 0.0 és 1.0 közötti számmal, valamint bemeneti példákat. Lefuttatja a programot a példákon, új utasításokat és demonstrációkat javasol, megtartja a legjobb kombinációt, és egy lefordított programot ad vissza.
Első lépések
import os
import dspy

lm = dspy.LM("openai/gpt-5-nano", api_key=os.environ["OPENAI_API_KEY"])
dspy.configure(lm=lm)


class ExtractIntent(dspy.Signature):
    """Classify the customer's intent in one short email."""

    email: str = dspy.InputField()
    intent: str = dspy.OutputField(desc="one of: order, return, invoice, other")


extract = dspy.ChainOfThought(ExtractIntent)


def intent_metric(example, prediction, trace=None):
    return float(prediction.intent.strip().lower() == example.intent.strip().lower())


trainset = [
    dspy.Example(email="Where is my parcel 4411?", intent="order").with_inputs("email"),
    dspy.Example(email="I want my money back for the shoes.", intent="return").with_inputs("email"),
    # more labelled emails from your own inbox
]

optimizer = dspy.MIPROv2(metric=intent_metric, auto="light")
compiled = optimizer.compile(extract, trainset=trainset)
compiled.save("intent_v1.json")
A metrika a megjósolt és a címkézett szándékot hasonlítja össze, ezért ehhez a példához címkék kellenek. A fordítás hívásánál keletkezik a költség: a light sok száz modellhívást indít, ezért először egy kis halmazon futtasd, nézd meg a mentett fájlt, és csak utána skálázz.
Aláírások és modulok
Az aláírás a szerződés. A string forma, például question -> answer, rövidítés. Az osztályforma egy docstringet ad hozzá, amely az utasítássá lesz, és típusos mezőket. A sorrend számít: a bemenetek vagy kimenetek átrendezése megváltoztatja a promptot. Minden aláírás-módosítást promptmódosításnak tekints, és teszteld.
- dspy.Predict bemenetekből kimeneteket állít elő nyelvi modellel. A kulcsszavas argumentumai a modellhez mennek.
- dspy.ChainOfThought lépésenként indokol, mielőtt válaszol. Egy indoklási mezőt ad hozzá, amelyet testre szabhatsz.
- dspy.ReAct gondolkodás-cselekvés ciklust futtat eszközökkel. A max_iters alapértéke 20.
A kezdőlap így foglalja össze: „ugyanaz az interfész, más stratégia“. A stratégia a számlát is meghatározza: az indoklási mezők minden hívásnál kimeneti tokeneket adnak hozzá, és a ReAct minden lépése újabb modellhívás.
Optimalizálók és mire van szükségük
A DSPy 14 optimalizálót kínál, a BootstrapFewShot-tól, amely demonstrációkat gyűjt, a GEPA-ig, amely a metrika visszajelzéséből írja át az utasításokat. Mindegyikhez kell metrika. A FAQ egy feladatot, egy metrikát és néhány bemeneti példát kér, címkét csak ott, ahol a metrika igényli. A táblázat a négy legalaposabban vizsgált optimalizálót hasonlítja össze.
| Optimalizáló | Mit változtat | Mire van szüksége | Fő költség |
|---|---|---|---|
| BootstrapFewShot | Few-shot demonstrációk | Metrika és tanítópéldák | Programfutások, egy próbálkozás példánként |
| MIPROv2 | Utasítások és demonstrációk | Metrika és tanítókészlet | 35 példás próbák, plusz teljes validációs körök |
| GEPA | Utasítások, egy reflexiós modell írja át | Visszajelzést adó metrika és reflexiós modell | Költségkeret a validációs méret és a prediktorok száma szerint |
| BootstrapFinetune | Finomhangolt modell prediktoronként | Nyomvonalak és egy finomhangolható modell | Egy feladat modellenként, vagy prediktoronként |
A MIPROv2 a szokásos kiindulópont, ezért érdemes ismerni a számolását. Az auto beállítás rögzíti a keresés méretét. Egy prediktoros, few-shot programnál a light nagyjából tíz próbát futtat, és legfeljebb 100 példán validál. A medium 18 próbát 300 példán, a heavy 27 próbát 1000 példán. Minden próba egy 35 példás minibatch-et pontoz, a teljes validációs kör pedig minden hatodik próbánál fut, az utolsónál és a nem optimalizált programra is.
- light: körülbelül 750 futás, 350 a próbákra és 400 a teljes körökre.
- medium: körülbelül 2100 futás, 630 a próbákra és 1500 a teljes körökre.
- heavy: körülbelül 7900 futás, 945 a próbákra és 7000 a teljes körökre.
A tokenek a hívásokat követik. A FAQ, amelyet a DSPy 2.5 és 2.6 verziójára írtak, és amelyről jelezték, hogy elavulhatott, körülbelül hat percet, 3200 hívást, 2,7 millió bemeneti és 156 000 kimeneti tokent említ, ami az akkori OpenAI-árakon nagyjából 3 dollár volt. Ez hívásonként körülbelül 850 bemeneti és 50 kimeneti token, így a light futás 750 hívása nagyjából 0,6 millió bemeneti és 40 000 kimeneti tokent jelent. A kezdőlap aktuális példája: GEPA auto=medium beállítással, 200 példán, gpt-5.4-mini modellel, 2,18 dollár.
A GEPA másként bánik a költségvetéssel. A metrikája pontszámot és szöveges visszajelzést ad, és egy reflexiós modell olvassa a példákat és pontszámaikat, majd átírt utasításokat javasol. Az útmutató nagyobb reflexiós modellt ajánl, mint amelyet optimalizálsz, és a konstruktor egyet igényel, kivéve, ha saját javaslótervezőt adsz meg. A light körülbelül hat jelölt-promptot céloz, a kód pedig ebből metrikahívás-keretet számol, amelyben több teljes validációs kör is benne van.
A közlemények adják az erősebb érvet, és mindegyik a szerzők saját feladatain mér. A DSPy-cikk szerint a pipeline-ok általában több mint 25%-kal, illetve 65%-kal verik a sima few-shot promptot, a GPT-3.5, illetve a llama2-13b-chat esetében. A MIPROv2-cikk hét többlépcsős programból ötön ért el javulást, akár 13%-os pontossággal. A GEPA-cikk átlagosan 6%-os előnyt állít a GRPO nevű megerősítéses tanulási alapvonal fölött, legfeljebb 35-ször kevesebb rolloutttal.
Költség, üzemeltetés és adatok
| Tétel | Ár | Mit fed le |
|---|---|---|
| DSPy-könyvtár | MIT · ingyenes | pip-pel telepítve, a saját folyamatodban fut |
| Modellhívások futásidőben | A szolgáltatód díja | A program minden hívása, tokenenként számlázva |
| Optimalizálási futás, a gyártó példája | 2,18 $ | GEPA, auto medium, 200 példa, gpt-5.4-mini |
| Régebbi FAQ-futás | körülbelül 3 $ | 3200 hívás, 2,7 millió bemeneti és 156 000 kimeneti token |
A lefordított programot build-artefaktumként kezeld. Mentsd JSON-ként, amit a dokumentáció biztonságosabbnak és olvashatóbbnak nevez, az aláírások mellé ugyanabba a tárolóba, verziószámmal a fájlnévben és rögzített DSPy-verzióval. A fájl tartalmazza az aláírást, a demonstrációkat és prediktoronként a modellt. Betöltéshez előbb ugyanazt a programot kell felépíteni a kódban.
A modellváltás újrafordítást von maga után, mert a fordító a programot az új modell új promptjaira képezi le. Tartsd meg a régi fájlt, futtasd mindkettőn a metrikát, és csak akkor éleszd az újat, ha nyer. A verziót is rögzítsd: a LM-oldal leír egy auto motort, amely az újabb backendet részesíti előnyben, így egy frissítés megváltoztathatja a viselkedést.
Az adatút az, amelyet te állítasz be, ezért a feldolgozó és a régió kérdései ugyanazok, mint bármely modell-API esetén. Három dolog is tart meg az adataidból másolatot. Az LM-gyorsítótár alapértelmezetten be van kapcsolva, memóriában és lemezen egyaránt. A mentett program a tanítóadataidból származó demonstrációkat hordoz, így a JSON-fájl személyes adatot is tartalmazhat. A GEPA reflexiós modellje a példáidat és pontszámaikat olvassa, így az második feldolgozó. Az EU-s lehetőségekről a GDPR-cikkemben az EU-s adatrezidenciáról olvashatsz.
Hol marad alul
A legtöbb feladathoz nem kell optimalizáló. A FAQ elismeri, hogy rendkívül egyszerű esetekben egy sima prompt is elég lehet, és a tool-okat, újrapróbálásokat és feldolgozást továbbra is te írod meg. Ha nem tudsz olyan metrikát írni, amely megfelel annak, amit a felhasználó helyesnek hívna, az optimalizáló azt javítja, amit mértél, és ez nem ugyanaz.
A kézzel írt promptok felett leginkább akkor nyer, ha több hívás függ egymástól, a modell gyakran változik, és a kimenet pontozható. A finomhangolással szemben a legtöbb csapatnak olcsóbb és könnyebben visszacsinálható opció. A BootstrapFinetune a programot finomhangolási feladatokká fordítja, de ekkor finomhangolt modelleket kell kiszolgálnod és verziókezelned, modellenként vagy prediktoronként egyet.
A számla és a metrika a másik gyenge pont. Egy light futás száz hívást indít, a heavy futások ezreket, és a validációs halmaz viszi a költség nagy részét. A gyártói állítás, hogy egy kicsi, olcsó modell gyakran képes felérni vagy túlszárnyalni egy kézzel promptolt csúcsmodellt, a te adataidon ellenőrzendő hipotézis.
Az API még mozog. A 3.4.0 kiadási jegyzetei törést okozó változást jeleznek a rlm(...) hívásnál, és eltávolítják a régi dspy.LMRequest és dspy.LMResponse exportokat, ezért minden frissítés előtt olvasd el őket.
Ítélet
Vezesd be a DSPy-t, ha a pipeline többlépcsős, mérhető és változó. Egy promptnál, amelyet nem változtatott modellen, egy átnézett prompt és egy regressziós csomag elég. Ha nem tudod megírni a metrikát, ne fordíts még semmit.
- Vezesd be, ha több modellhívásnak egyeznie kell, és a kimenetük automatikusan pontozható.
- Vezesd be, ha a modell vagy az adat gyakran változik, mert az újrafordítás olcsóbb, mint a promptok újraírása.
- Ne vezesd be, ha a feladat egy prompt stabil modellen.
- Ne vezesd be, ha senki nem írja meg és nem tartja karban a metrikát.
Három alternatíva fedi le a maradékot. Ha a promptokat a kódban akarod tartani, és a változtatásokat eval-ok kapuzzák, a Promptfoo a közelebbi választás. Ha explicit állapotról és vezérlési folyamatról van szó, nézd meg a LangGraph-ot, és ha mindkettő kell, kombináld. Ha a modellnek formátumot vagy stílust kell megtanulnia, a finomhangolás a megoldás, ahogy a döntési útmutató is leírja.
Források
- DSPy-kezdőlap és költségpélda
- DSPy-telepítés
- DSPy: program, ne prompt
- DSPy-aláírások
- DSPy-metrikák
- DSPy Example API
- DSPy Predict API
- DSPy ChainOfThought API
- DSPy ReAct API
- DSPy-optimalizálók
- DSPy MIPROv2 API
- MIPROv2 forráskód
- DSPy BootstrapFewShot API
- DSPy BootstrapFinetune API
- DSPy GEPA-útmutató
- GEPA forráskód
- DSPy-programok mentése
- DSPy-gyorsítótár
- DSPy LM API
- DSPy GYIK
- DSPy GitHub-tároló
- DSPy 3.4.0 kiadás
- DSPy-cikk, arXiv
- MIPRO-cikk, arXiv
- GEPA-cikk, arXiv
Gyakori kérdések
Ingyenes a DSPy?
A könyvtár MIT-licencű és ingyenes. Minden modellhívást fizetsz, az optimalizáló keresés közbeni hívásait is. A dokumentáció példafutásai néhány dollárba kerültek.
Hány példa kell a DSPy-hoz?
A dokumentációban nem találtam rögzített minimumot. A FAQ néhány bemenetet kér, címkét csak akkor, ha a metrika igényli. A MIPROv2 light beállítása legfeljebb 100 példát használ validációra.
Helyi modellre irányíthatom a DSPy-t?
A dspy.LM LiteLLM-stílusú szolgáltató- és modellneveket fogad, így egy helyi végpont működhet, ha a LiteLLM el tudja érni. Ehhez a kritikához nem teszteltem egyet sem, ezért először a saját környezetedben ellenőrizd.
Újra kell optimalizálnom, ha modellt váltok?
Igen. A FAQ a célmodell cseréjét nevezi meg újrafordítási okként, mert a fordító új promptokra képezi le a programot. Tartsd meg a korábbi lefordított fájlt, hogy összehasonlíthass és visszaállhass.