Eszközök/LLMOps és értékelés
llama.cpp-teszt: a helyi motor az Ollama és az LM Studio alatt
A llama.cpp tiszta C/C++ motor nyílt modellekhez, Metal, CUDA, Vulkan vagy CPU alatt. A GGUF-kvantálásokról, a llama-serverről és a korlátokról írok.
- Típus
- Local inference runtime
- Ár
- MIT · free
Balázs Csorba··8 perc olvasás
- llama.cpp
- GGUF
- Quantisation
- Local inference
- llama-server
A lényeg röviden
- A llama.cpp az MIT-licencű motor az Ollama és az LM Studio alatt. Közvetlenül akkor használd, ha a modellfájlt, a kvantálást és minden szerverkapcsolót te akarod irányítani.
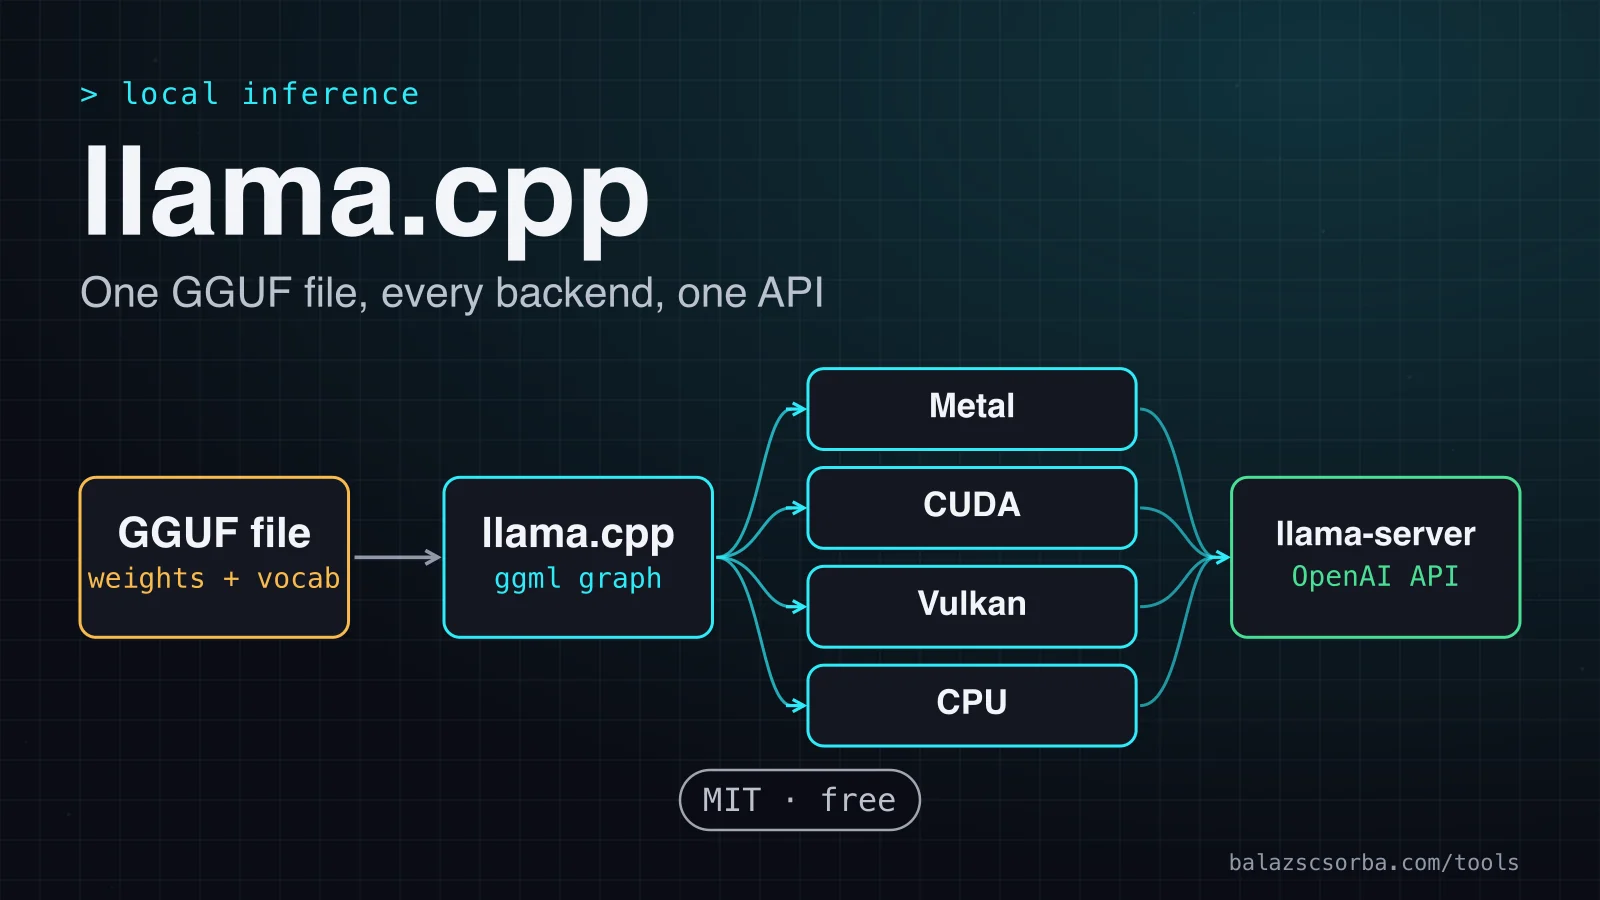
- A GGUF-fájl tartalmazza a súlyokat, a tokenizálót és a metaadatokat. A build-kapcsolók döntik el a háttérmotort, így ugyanaz a fájl fut Metalon, CUDA-n, Vulkanon vagy CPU-n.
- A Q4_K_M jó kiindulópont, de a kvantálási táblázat csak a méretet és a sebességet méri, a minőségellenőrzést neked kell elvégezned.
- Apple-chipeken a sebesség a memóriasávszélességet követi, de nem egyenesen. Egy csúcskategóriás chip több tucat tokent generál másodpercenként egy 7B-s modellen, egy adatközponti GPU ugyanilyen típusú tesztben nagyjából háromszor gyorsabb.
- A helyi következtetés a promptokat a saját hardveredén tartja, ami kivesz egy adatfeldolgozót a következtetési lépésből, de a naplókra, a hozzáférésre és a megőrzésre vonatkozó GDPR-kötelezettségeid megmaradnak.
A llama.cpp az a C- és C++-motor, amely nyílt súlyú nyelvi modelleket futtat olyan hardveren, amelyet te irányítasz. Több barátságosabb helyi eszköz épül rá, köztük az Ollama és az LM Studio. Az ítélet előre: közvetlenül akkor használd, ha te akarod kiválasztani a modellfájlt, a kvantálást és minden szerverkapcsolót, laptopon vagy a saját szervereden. Ne használd, ha egyetlen paranccsal akarsz modelleket letölteni és kezelni, és ne használd egy forgalmas, sok felhasználós GPU-szolgáltatás kiszolgáló rétegeként sem, ahhoz a vLLM a jobb választás.
Mi ez
A projekt célként az LLM- és VLM-következtetést jelöli meg minimális beállítással és korszerű teljesítménnyel, széles hardverskálán. Tiszta C- és C++-megvalósítás, külső függőségek nélkül, a ggml tenzorkönyvtárra épül. A kiadási oldalon látható legújabb build a b11541, amelyet 2026. október 10-én tettek közzé.
- MIT-licenc az egész projektre, így licencdíj nélkül használhatod és szállíthatod.
- Háttérmotorok Apple Metalhoz, NVIDIA CUDA-hoz, AMD HIP-hez, Vulkanhoz, OpenCL-hez, SYCL-hez és WebGPU-hoz, valamint x86- és ARM-CPU-s kódútvonalak.
- llama-server, OpenAI-kompatibilis HTTP-szerver beépített webes felülettel.
- Kvantálás 1,5 és 8 bit között, GGUF modellformátummal.
- Hugging Face-támogatás a -hf kapcsolón keresztül, valamint olyan konvertáló szkriptek, mint a convert_hf_to_gguf.py.
Hogyan működik
A GGUF-fájl végzi a munka nagy részét. A specifikáció úgy írja le a GGUF-ot, mint fájlformátumot modellek tárolására, a GGML-lel és a GGML-re épülő futtatókörnyezetekkel történő következtetéshez, gyors betöltésre és mentésre tervezve. Minden fájl tartalmaz fejlécet a tenzorok és a metaadatok számlálóival, típusos kulcs-érték metaadatokat, minden tenzor leírását (név, alak, típus és eltolás), valamint a tenzoradatokat, amelyeket igazítási határra töltenek ki. A specifikáció a memóriatérkép-kompatibilitást célként nevezi meg, így az operációs rendszer a súlyokat leképezheti, ahelyett hogy másolná őket. A tokenizáló is a fájlban van, a tokenizer.ggml kulcsok alatt. A specifikáció figyelmeztet, hogy a beágyazott szótár pontatlanabb lehet az eredeti tokenizálónál, ezért konvertálás után ellenőrizd a kimenet minőségét.
Első lépések
A build-dokumentáció macOS-en alapértelmezetten bekapcsolja a Metalt, így egy sima build a Macen már tartalmazza az Apple-háttérmotort. A többi háttérmotorhoz konfiguráláskor kapcsoló kell, ahogy a táblázat mutatja.
| Háttérmotor | Hardver | Bekapcsolás |
|---|---|---|
| Metal | Apple Silicon | macOS-en alapértelmezetten be |
| CUDA | NVIDIA GPU-k | -DGGML_CUDA=ON |
| Vulkan | Vulkan-illesztőprogrammal rendelkező GPU-k | -DGGML_VULKAN=ON |
| CPU | x86 (AVX2, AVX512, AMX) és ARM (NEON) | Az alapértelmezett buildben benne van |
# macOS includes Metal by default; for NVIDIA GPUs use cmake -B build -DGGML_CUDA=ON
cmake -B build
cmake --build build --config Release
./build/bin/llama-server -m models/Llama-3.1-8B-Instruct-Q4_K_M.gguf -c 8192 -np 4 --host 127.0.0.1 --port 8080
Három kapcsoló dönt a legtöbbet. A -m megnevezi a GGUF-fájlt, a -c a kontextusméretet adja meg tokenben (0 a modellben tárolt értéket jelenti), a -np pedig a párhuzamos slotok számát. A szerver alapértelmezetten a 127.0.0.1 címen figyel, így más gépek addig nem érik el, amíg meg nem változtatod a --host kapcsolót.
Kvantálás és sebesség
A kvantálás azt jelenti, hány bitet kap minden súly, és ezt a fájlmérettel és a minőséggel szemben mérlegeled. A _K jelölés a K-kvantokat jelöli, az IQ típusok pedig az I-kvantok, amelyek körülbelül 2 bit/súlyig mennek; az IQ1_S a README táblázatában 2,00 bit. A README példaparancsa naiv Q4_K_M-kvantálás alapbeállításokkal, ezért a Q4_K_M ésszerű kiindulópont.
| Kvantálás | Bit súlyonként | Méret (GiB) | Generálás (token/s) |
|---|---|---|---|
| Q2_K | 3,16 | 2,95 | 79,85 |
| Q4_K_M | 4,89 | 4,58 | 71,93 |
| Q5_K_M | 5,70 | 5,33 | 67,23 |
| Q6_K | 6,56 | 6,14 | 58,67 |
| Q8_0 | 8,50 | 7,95 | 50,93 |
| F16 | 16,00 | 14,96 | 29,17 |
A táblázatot kompromisszumként olvasd. A méret a bitszámmal csökken, a generálás pedig gyorsabb lesz, ahogy a fájl kisebb lesz, mert minden tokennek újra be kell olvasnia a súlyokat. Az F16 másodpercenként 29,17 tokent generál, szemben a Q4_K_M 71,93-mal, és több mint háromszor annyi memóriát igényel. A README a Llama 3.1 8B modellt méri, de nem írja le, melyik gép adta a számokat, ezért relatív értékekként kezeld őket. A táblázatban nincs minőségoszlop: a README sem perplexitást, sem KL-divergenciát nem közöl. Választás előtt szerintem minden jelöltre ugyanazt az értékelő halmazt kell lefuttatni, ahogy a LLM-értékelések termékfunkciókhoz című cikkemben leírtam.
Apple-chipeken a sebesség a memóriasávszélességet követi. Az Apple Silicon-szálban a LLaMA 7B Q4_0 kvantálással az M4 Max másodpercenként 83,06 tokent generál, 546 GB/s memóriasávszélességgel, az M1 Pro pedig 36,41-et, 200 GB/s-mal. Az M2 Ultra 94,27-et ér el 800 GB/s-mal. Az összefüggés nem egyenes: az M1 Pro az M2 Ultra sávszélességének negyedével rendelkezik, és annak kevesebb mint felével fut.
A CUDA-szál a Llama 2 7B Q4_0 kvantálásán mért llama-bench-eredményeket gyűjti: az RTX 4090 másodpercenként 186,21 tokent, a 80 GB-os H100 267,81-et, az RTX 5090 pedig 290,02-t ad. Tervezéshez ez azt jelenti, hogy egy csúcskategóriás Apple-chipen egy felhasználó több tucat tokent kap másodpercenként egy 7B-s modellen, egy adatközponti GPU pedig ugyanilyen típusú tesztben nagyjából háromszor gyorsabb. A modellek és a buildek szálanként eltérnek, ezért nagyságrendekben gondolkodj. Egyik szál sem tesztel szervert egyidejű terhelés alatt, pedig a GPU-szerver ára éppen ott térül meg.
llama-server: API, slotok és strukturált kimenet
A llama-server az a pont, ahol a legtöbb alkalmazás találkozik a llama.cpp-vel. OpenAI-kompatibilis útvonalai a /v1 alatt vannak: chat completions, completions, responses, models és embeddings. A natív útvonalak a tokenizálást, a sablonrenderelést, a slotok állapotát és az állapotellenőrzést fedik le. Létezik Prometheus-kompatibilis metrikavégpont is, de ki van kapcsolva, amíg meg nem adod a --metrics kapcsolót, ami fontos tudni, mielőtt portot tennél közzé.
A párhuzamos slotok így működnek. Ha a -np az alapértelmezett auto értéken van, a slotok egyetlen KV-gyorsítótár-pufferen osztoznak, és a README ezt az üzemmódot alapból bekapcsolja. Így egy hosszú kérés olyan memóriát is használhat, amelyet egy tétlen slot egyébként lefoglalna. A folytonos kötegelés szintén alapból be van kapcsolva. A README dokumentálja a kapcsolót (--kv-unified) és a slotonkénti korlátot (--kv-unified-per-slot), de nem részletezi, hogyan oszlik meg a keret, ha kézzel állítod be a slotok számát. Ezért mérd meg a memóriát, mielőtt több felhasználós szervert méretezel.
A strukturált kimenetnek két útja van. A --json-schema JSON-sémára korlátozza a generálást, a --grammar pedig BNF-szerű nyelvtant fogad el; a README mindkettőt a generálás korlátozásának módjaként írja le. A chat-végpont elfogad json_schema típusú response_format mezőt is, ahogy ez a kérés mutatja.
curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages": [{"role": "user", "content": "Extract the author from: Written by Balázs Csorba."}], "response_format": {"type": "json_schema", "schema": {"type": "object", "properties": {"author": {"type": "string"}}, "required": ["author"]}}}'
Költség és üzemeltetés
| Költségtétel | Amit fizetsz | Megjegyzés |
|---|---|---|
| llama.cpp | Semmit | MIT-licenc, nincs használati díj |
| Saját hardver | Beszerzés és áram | A memória határozza meg a legnagyobb betölthető modellt és kvantálást |
| Bérelt GPU-szerver | A szolgáltató díja | Válassz EU-régiót, és köss adatfeldolgozási szerződést |
| Modellsúlyok | Az adott modell saját feltételei | A modellkártya tünteti fel a licencet |
Az adatvédelem a helyi következtetés legerősebb érve. Ha a modell a saját hardveredén fut, a promptok, a lekért dokumentumok és a válaszok azon a gépen maradnak, és egyetlen modellszolgáltató sem kapja meg őket, így a következtetési lépésnek nincs adatfeldolgozója. A GDPR 28. cikke szerint az adatfeldolgozó által végzett adatkezelést kötelező erejű szerződésnek kell szabályoznia, amely dokumentált utasításokhoz köti a feldolgozót. Egy bérelt GPU-host, amely helyetted kezel személyes adatokat, adatfeldolgozó, függetlenül attól, hogy hol található, és szüksége van erre a szerződésre.
A helyi nem jelent automatikusan megfelelőséget. A 32. cikk az adatkezelőktől és adatfeldolgozóktól megfelelő technikai és szervezési intézkedéseket kér, példaként a titkosítást és az álnevesítést említi. Egy llama.cpp-szervernél ezek a beállítások számítanak: a kötési cím (127.0.0.1, kivéve, ha módosítod a --host kapcsolót), az API-kulcs (a --api-key egy vagy több kulcsot fogad el), a metrikavégpont (kikapcsolva, kivéve, ha megadod a --metrics kapcsolót), és a saját naplóid, amelyekre ugyanaz a megőrzési szabály vonatkozik, mint bármely promptarchívumra. A GDPR és az LLM-adatrezidencia cikk lefedi a checklista többi részét.
Hol szorul ki
- Futtatókörnyezet, nem platform. Te választod ki a fájlt, a kvantálást, a kontextusméretet és a kapcsolókat, a binárist pedig te frissíted. A tempó is ide tartozik: a kiadási oldalon 2026. október 9-én és 10-én négy build jelent meg.
- Nincs modellkezelés. A GGUF-fájlt magad töltöd le. A -hf kapcsoló letölt egy Hugging Face-tárolót, és alapból Q4_K_M-et vesz, vagy a tár első fájlját, ha ez a kvantálás hiányzik.
- Nincs minőségmérés. A kvantálási táblázat csak a méretet és a sebességet adja, a minőségellenőrzés tehát rád marad.
- A párhuzamosság memóriakérdés. Vannak slotok és folytonos kötegelés, de a benchmark-szálak nem tesztelnek szervert egyidejű terhelés alatt, a README pedig nem részletezi a memória-felosztást kézzel beállított slotszám mellett.
- A GGUF a vLLM-ben még nem kész kiszolgálási út. A vLLM a GGUF-támogatását erősen kísérletinek és nem eléggé optimalizáltnak nevezi, és azt írja, hogy a GGUF egyelőre főleg a memórialábnyom csökkentésére jó.
Ítélet
Válaszd a llama.cpp-t, ha magát a motort akarod, a fájl, a kvantálás és a kapcsolók a te irányításod alatt állnak, és ha az adatok soha nem hagyhatják el a gépet. Saját eszközökhöz és egy kis privát szerverhez jó alap. Annak, aki egyetlen paranccsal akar modellt letölteni és futtatni, nem az első eszköz, és egy forgalmas GPU-szolgáltatás kiszolgáló rétegeként sem jó. Ha a helyi lehetőségek között választasz: az LM Studio Mac-en, Windowson és Linuxon llama.cpp-vel futtat modelleket, Apple Silicon-on pedig az MLX-et is támogatja. Így azoknak való, akik grafikus alkalmazást szeretnének.
- Válaszd, ha te akarod kiválasztani a GGUF-fájlt, a kvantálást és minden kapcsolót a saját hardveredén.
- Válaszd, ha olyan szervert akarsz, amelyet soronként át tudsz látni, és minden beállítás látszik a saját parancsodban.
- Ne válaszd, ha egyetlen paranccsal akarsz modelleket letölteni és kezelni. Ehhez az Ollama való, amely a llama.cpp-t a támogatott háttérmotorjai között sorolja fel.
- Ne válaszd közös GPU-szolgáltatásra sok felhasználóval egyszerre. Előbb a vLLM-et mérd meg, mert a magja a PagedAttention és a folytonos kötegelés.
Források
- llama.cpp-tároló: célok, háttérmotorok, licenc
- llama.cpp-kiadások: a b11538–b11541 buildek
- llama.cpp build-dokumentáció: CMake-kapcsolók
- llama.cpp szerver-README: végpontok, slotok és grammatikák
- llama.cpp kvantálási README: bitek, méret és sebesség
- GGUF-specifikáció a ggml-tárolóban
- A llama.cpp teljesítménye Apple Silicon M-sorozaton
- A llama.cpp teljesítménye Nvidia CUDA-n
- Ollama README: támogatott háttérmotorok és REST API
- LM Studio dokumentáció: az alkalmazás áttekintése
- vLLM README: funkciók, hardver és licenc
- vLLM dokumentáció: GGUF-támogatás
- GDPR 28. cikk: adatfeldolgozó
- GDPR 32. cikk: az adatkezelés biztonsága
Gyakori kérdések
Ingyenesen használható a llama.cpp kereskedelmi célra?
A projekt MIT-licencű, így licencdíj nélkül használhatod és szállíthatod. A betöltött modellsúlyok saját licencükkel rendelkeznek, amelyek korlátozhatják a kereskedelmi használatot, ezért minden modellkártyát ellenőrizz, mielőtt terméket építesz rá.
Mi a különbség a llama.cpp és az Ollama között?
Az Ollama a támogatott háttérmotorjai között sorolja fel a llama.cppet, és REST API-t ad a modellek futtatásához és kezeléséhez. A llama.cpp maga a motor: te választod ki a GGUF-fájlt, a kvantálást és minden kapcsolót, a binárist pedig te frissíted.
Melyik GGUF-kvantálással érdemes kezdeni?
A Q4_K_M-mel. A kvantálási README egy naiv Q4_K_M-kvantálást mutat példaként. Lépj feljebb Q5_K_M-re vagy Q6_K-ra, ha a saját értékeléseid minőségi hiányosságot mutatnak, mert a sebességi táblázat a minőségről semmit sem mond.
Segít a helyi llama.cpp-szerver a GDPR-megfelelésben?
Segít, mert egyetlen modellszolgáltató sem kapja meg a promptokat, így ez az adatfeldolgozó kiesik a láncból. A hozzáférés-szabályozást, a naplók megőrzését és a jogalapot továbbra is neked kell rendezned. Egy bérelt GPU-host, amely személyes adatokat kezel helyetted, adatfeldolgozó, és a 28. cikk szerinti szerződésre van szüksége.