Blog/KI-Agenten
Browser-Agenten für E2E-Tests: Agenten Playwright-Tests schreiben lassen, nicht ausführen
Wo KI-Agenten bei E2E-Tests helfen: Playwright Planner, Generator und Healer, MCP oder CLI und die Leitplanken, die geheilte Tests ehrlich halten.
Balázs Csorba··7 Min. Lesezeit
- Playwright
- E2E testing
- Coding agents
- MCP
- Test automation
Das Wichtigste in Kürze
- Agenten deterministische Playwright-Tests schreiben und pflegen lassen; die CI sollte normale Testdateien ausführen, kein LLM, das entscheidet, was bestanden ist.
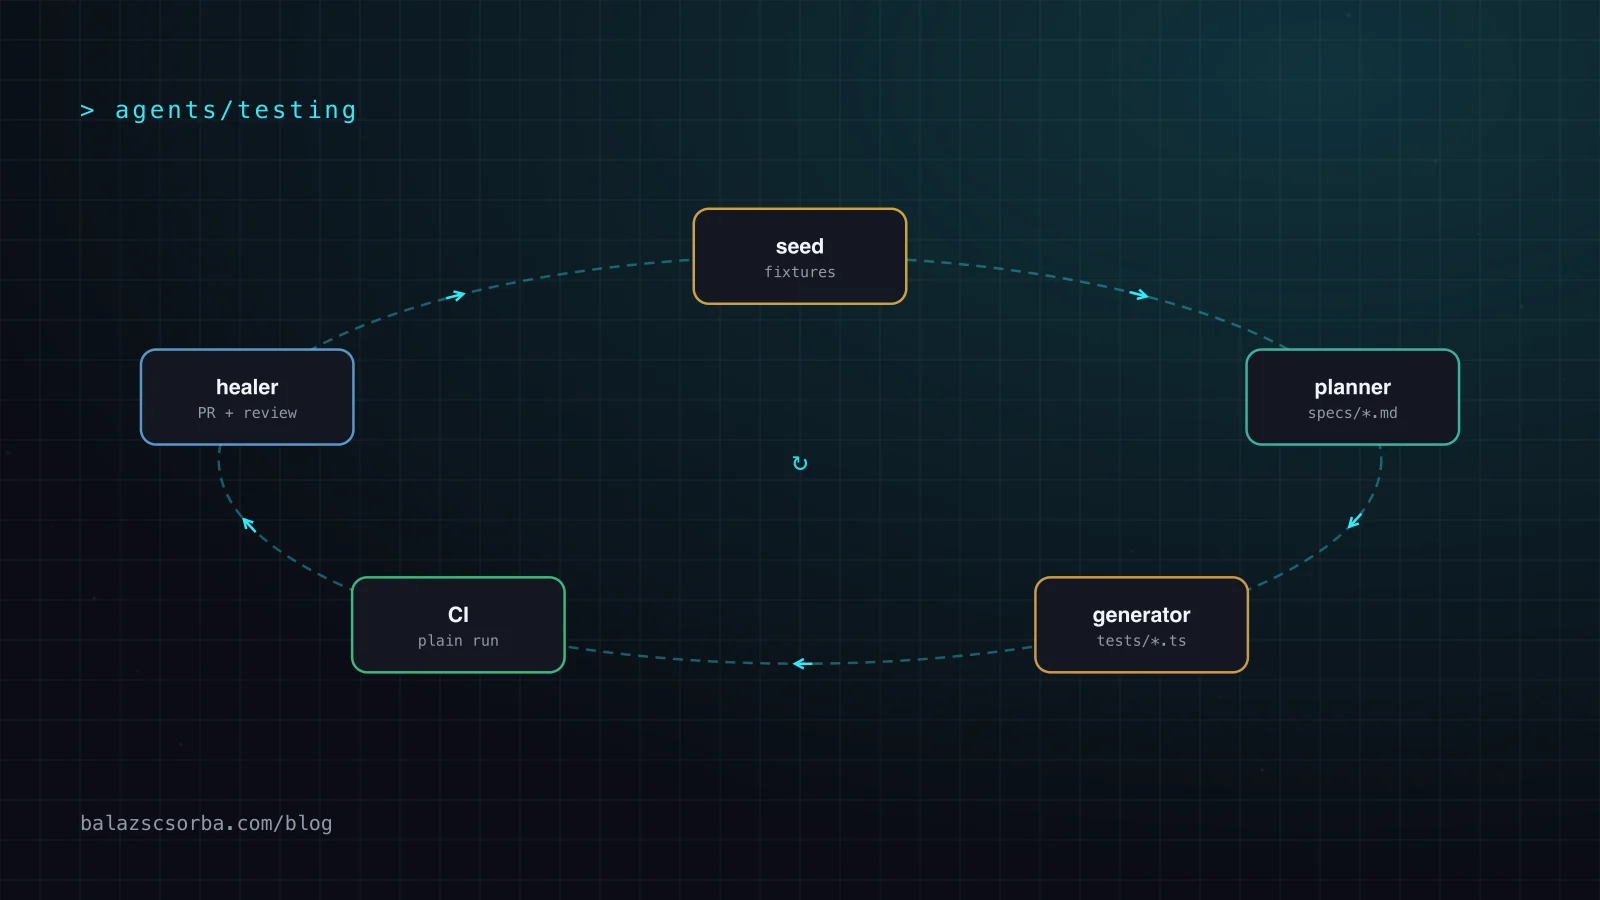
- Playwright liefert Planner-, Generator- und Healer-Agenten, die aus einem Seed-Test und einer Anfrage einen Markdown-Plan und dann Testdateien machen.
- Für Coding-Agenten verweist Playwrights eigene Dokumentation inzwischen auf das CLI mit Skills als tokensparender als den MCP-Server.
- Ein Healer darf Locators und Wartezeiten selbst anpassen; jede Änderung an einer Assertion oder ein übersprungener Test braucht ein menschliches Review.
- Barrierefreies Markup ist der Vertrag: Rollenbasierte Locators sind das, worauf Agenten und robuste Tests gleichermaßen bauen.
Browser-Agenten können heute eine App öffnen, die Seite lesen, sich durch einen Checkout klicken und sagen, ob es funktioniert hat. Es ist verlockend, daraus die Testsuite zu machen: Abläufe in normaler Sprache beschreiben und ein Modell sie bei jedem Pull Request prüfen lassen. Ich halte das für den falschen Platz für das Modell. Die bessere Aufteilung: Agenten übernehmen die teure menschliche Arbeit, die App erkunden, Tests schreiben und kaputte Locators reparieren, und die CI führt normale Playwright-Tests aus, die jedes Mal dieselbe Antwort geben.
Dieser Artikel vergleicht die drei Arten, wie Agenten und E2E-Tests zusammenkommen, geht Playwrights eigene Test-Agenten durch, behandelt MCP gegenüber CLI für Coding-Agenten und legt die Leitplanken fest, die ich nutze, damit ein selbstheilender Test keinen echten Bug still wegheilen kann.
Welche drei Wege gibt es, Agenten bei E2E-Tests einzusetzen?
| Ansatz | Was der Agent tut | Läuft in der CI? | Hauptrisiko |
|---|---|---|---|
| Agent schreibt Tests | Erkundet die App, schreibt Plan und Playwright-Testdateien | Nein, die Tests | Tests, die das Falsche prüfen |
| Agent repariert Tests | Führt fehlschlagende Tests aus, untersucht die UI, passt Locators und Wartezeiten an | Optional, als eigener Job | Eine echte Regression wegheilen |
| Agent ist der Test | Folgt Schritten in natürlicher Sprache im Live-Browser und bewertet das Ergebnis | Ja | Langsam, teuer, nicht deterministische Urteile |
Ein Test ist nützlich, weil er ein festes Orakel ist: derselbe Code, dieselben Daten und dieselbe Assertion ergeben dasselbe Ergebnis. Ein Modell, das einen Screenshot bewertet, ist eine zweite Meinung, kein Orakel. Für die Erkundung ist das wertvoll, aber ein roter Build sollte bedeuten, dass sich das Produkt geändert hat, nicht die Meinung des Modells.
Wie funktionieren die Test-Agenten von Playwright?
Playwright liefert drei Test-Agenten als Agentendefinitionen, die man mit npx playwright init-agents ins Repository holt, mit Varianten für VS Code, Claude Code, Codex und OpenCode. Laut Dokumentation sollte man sie nach jedem Playwright-Update neu erzeugen, damit sie neue Tools und Anweisungen bekommen.
- Planner: bekommt eine Anfrage wie „Plane den Gast-Checkout“, einen Seed-Test, der Fixtures und Login vorbereitet, und optional ein Anforderungsdokument. Er führt den Seed-Test aus, erkundet die App und schreibt einen Markdown-Plan nach
specs/. - Generator: macht aus dem Plan Playwright-Tests unter
tests/und prüft Selektoren und Assertions live, während er die Szenarien durchspielt. Laut Dokumentation können generierte Tests anfangs Fehler enthalten. - Healer: Bei einem fehlschlagenden Test spielt er die Schritte nach, sucht in der aktuellen UI gleichwertige Elemente, schlägt einen Patch vor, etwa einen neuen Locator, eine angepasste Wartezeit oder korrigierte Daten, und wiederholt, bis der Test besteht oder Leitplanken ihn stoppen. Das Ergebnis ist ein bestandener Test oder ein übersprungener, wenn er die Funktion für kaputt hält.
# Add the agent definitions for your coding agent (regenerate after Playwright upgrades)
npx playwright init-agents --loop=claude

# tests/seed.spec.ts: everything the agents need to reach a logged-in state
import { test, expect } from './fixtures'
test('seed', async ({ page }) => {
  await page.goto('/')
  await expect(page.getByRole('navigation')).toBeVisible()
})
Sollten Coding-Agenten Playwright MCP oder das CLI nutzen?
Playwright MCP lässt ein Modell einen Browser über strukturierte Accessibility-Snapshots statt Screenshots steuern, braucht also kein Vision-Modell und vermeidet die Mehrdeutigkeit von Klicks auf Pixel. Die eigene README zieht inzwischen aber eine Grenze: Für Coding-Agenten empfiehlt sie das Playwright-CLI mit Skills, weil CLI-Aufrufe keine großen Tool-Schemata und ausführlichen Accessibility-Bäume in den Kontext laden. MCP bleibt die bessere Wahl für Schleifen, die von einer dauerhaften Browser-Sitzung profitieren, etwa explorative Automatisierung und selbstheilende Tests.
Das entspricht dem allgemeinen Abwägen in AGENTS.md, Skills, MCP oder CLI: Jedes dauerhaft geladene Tool-Schema und jeder Seiten-Snapshot kostet in jeder Runde Kontext. Braucht eine Testsitzung nur wenige Seitenabrufe, ist das CLI günstiger; die Techniken aus Coding-Agent-Tokens sparen gelten auch hier.
Warum ist barrierefreies Markup der Vertrag für Agenten und Tests?
Playwrights Best Practices empfehlen nutzerseitige Locators wie getByRole('button', { name: 'Submit' }) statt CSS-Klassen und XPath, weil sich die DOM-Struktur öfter ändert als das, was Nutzer sehen. Playwright MCP liest denselben Accessibility-Baum. Die Arbeit, die eine Website mit Screenreader benutzbar macht, erleichtert also auch Agenten die Erkundung und erzeugt Tests, die Redesigns überstehen. Ein Button, der ein gestyltes div ohne Rolle ist, ist für alle drei unsichtbar.
Für Shops in der EU ist das ohnehin keine Kür; siehe European Accessibility Act für B2B-Shops. Rollen und Labels zu korrigieren zahlt gleichzeitig auf Compliance, Agenten und Teststabilität ein.
Wie hält man selbstheilende Tests ehrlich?
In der Aufgabenbeschreibung des Healers steckt das Risiko: Er wiederholt, bis der Test besteht, und hält er das Feature für kaputt, markiert er den Test als übersprungen. Beides ist in Ordnung, wenn ein Button umbenannt wurde. Beides ist schlecht, wenn der Button wegen eines echten Bugs verschwunden ist. Meine Regel ist einfach: Der Healer darf ändern, wie ein Test Dinge findet, nie, was ein Test prüft.
#!/usr/bin/env bash
# CI gate for agent-made test changes: locator and wait edits pass, assertion edits need review
set -euo pipefail
changed=$(git diff --unified=0 origin/main -- 'tests/**/*.spec.ts' | grep -E '^[-+][^-+]' || true)
if echo "$changed" | grep -Eq 'expect\(|test\.(skip|fixme)\(|\.toHave|\.toBe'; then
  echo "Assertions or skips changed in tests/: needs a human reviewer (label: test-assertions)"
  exit 1
fi
Dasselbe gilt für Tests, die ein Agent für einen Bugfix schreibt. Ein Regressionstest ist nur etwas wert, wenn er scheitert, sobald der Fix zurückgenommen wird; das prüfe ich in jedem Bugfix-PR, wie in der Agentenschleife und meinem Workflow vom Bug zum PR beschrieben.
Wann ergibt ein Browser-Agent zur Laufzeit trotzdem Sinn?
Es gibt Fälle, in denen feste Selektoren das falsche Werkzeug sind. Exploratives Testen vor einem Release, bei dem ein Agent ungewöhnliche Wege ausprobiert und meldet, was falsch aussah. Smoke-Checks auf Seiten Dritter, die man nicht kontrolliert, etwa die Weiterleitung eines Zahlungsanbieters. Interne Backoffice-Abläufe, die sich wöchentlich ändern. Dafür kombinieren Bibliotheken wie Stagehand Aufrufe in natürlicher Sprache wie act, extract und observe mit Seiten- und Locator-APIs im Playwright-Stil, sodass ein Skript größtenteils deterministisch mit wenigen flexiblen Schritten sein kann. Genauer vergleiche ich das im Stagehand-Test.
Diese Läufe aus dem Merge-Gate heraushalten. Ihre Funde als Issues oder neue deterministische Tests melden und die Entscheidung über Bestehen oder Scheitern bei Code lassen, den man lesen kann.
Wie sieht ein praktisches Setup aus?
- Ein Seed-Test mit Fixtures für Login und Testdaten, damit Agenten von einem bekannten Zustand aus starten.
- Pläne in
specs/wie Anforderungen reviewen: Ein falscher Plan erzeugt korrekt aussehende Tests für falsches Verhalten. - Generierte Tests nutzen nur rollenbasierte Locators; CSS-Selektoren scheitern am Lint.
- Die CI führt reines
npx playwright testmit Traces bei Fehlern aus; kein Modell im Merge-Gate. - Der Healer läuft als eigener Job, der einen PR öffnet; Assertion-Änderungen und Skips werden fürs Review blockiert.
Das ist Harness Engineering, angewandt aufs Testen: Der Agent bekommt Guides (Seed-Test, Pläne, Locator-Regeln) und Sensoren (Testlauf, Assertion-Gate), und das menschliche Review sitzt dort, wo die Entscheidungen fallen, nicht auf jeder Zeile.
Quellen
Häufige Fragen
Kann ein KI-Agent meine E2E-Testsuite ersetzen?
Nicht als das, was in der CI läuft. Ein Agent, der zur Testzeit durch die App klickt, ist langsamer, kostet bei jedem Lauf Tokens und kann dasselbe Ergebnis zweimal unterschiedlich bewerten. Agenten zum Schreiben, Erweitern und Reparieren einer normalen Playwright-Suite nutzen und diese deterministisch laufen lassen.
Was sind die Playwright Test Agents?
Playwright liefert drei Agentendefinitionen: einen Planner, der die App erkundet und einen Testplan in Markdown schreibt, einen Generator, der den Plan in Playwright-Testdateien übersetzt und dabei Selektoren live prüft, und einen Healer, der fehlschlagende Tests ausführt und Patches vorschlägt. Man fügt sie mit npx playwright init-agents für VS Code, Claude Code, Codex oder OpenCode hinzu.
Playwright MCP oder Playwright CLI?
Für Coding-Agenten in einem Repository empfiehlt die README von Playwright MCP das CLI mit Skills, weil es keine großen Tool-Schemata und Accessibility-Bäume in den Kontext lädt. MCP passt zu lang laufenden explorativen oder selbstheilenden Schleifen, die von einer dauerhaften Browser-Sitzung profitieren.
Sind selbstheilende Tests sicher?
Nur mit Grenzen. Einen Locator für einen umbenannten Button zu korrigieren ist in Ordnung. Zu ändern, was ein Test prüft, oder ihn zu überspringen, weil das Feature kaputt wirkt, kann eine echte Regression verstecken. Den Healer Locators und Wartezeiten ändern lassen und Assertion-Änderungen und Skips ins Review schicken.
Wann lohnt sich ein Browser-Agent zur Laufzeit?
Für exploratives Testen, schnelle Smoke-Checks auf Seiten, die man nicht kontrolliert, und Aufgaben, bei denen sich die Oberfläche zu oft für feste Selektoren ändert. Tools wie Stagehand mischen dafür Aktionen in natürlicher Sprache mit Code im Playwright-Stil.