Blog/KI-Agenten
Top 20 Wege, Tokens bei Coding-Agents zu sparen: rtk, lean-ctx, Serena und mehr, nach Belegen gerankt
rtk, lean-ctx, context-mode, Serena und 16 weitere Token-Sparer für Coding-Agents, nach Belegen gerankt, mit eigenen Messungen an einer echten Nuxt-Codebasis.
Balázs Csorba··17 Min. Lesezeit
- Claude Code
- token usage
- context engineering
- developer tools
Das Wichtigste in Kürze
- Die meisten Prozentangaben von Token-Sparern messen weniger Ausgabe bei den Befehlen, die ein Tool am besten kann, nicht eine kleinere Rechnung. Sie sind Obergrenzen.
- Zuerst kommen die kostenlosen Bordmittel: mit /usage und ccusage messen, zwischen Aufgaben /clear, das gecachte Präfix stabil halten, MCP-Server ausmisten und den Effort senken.
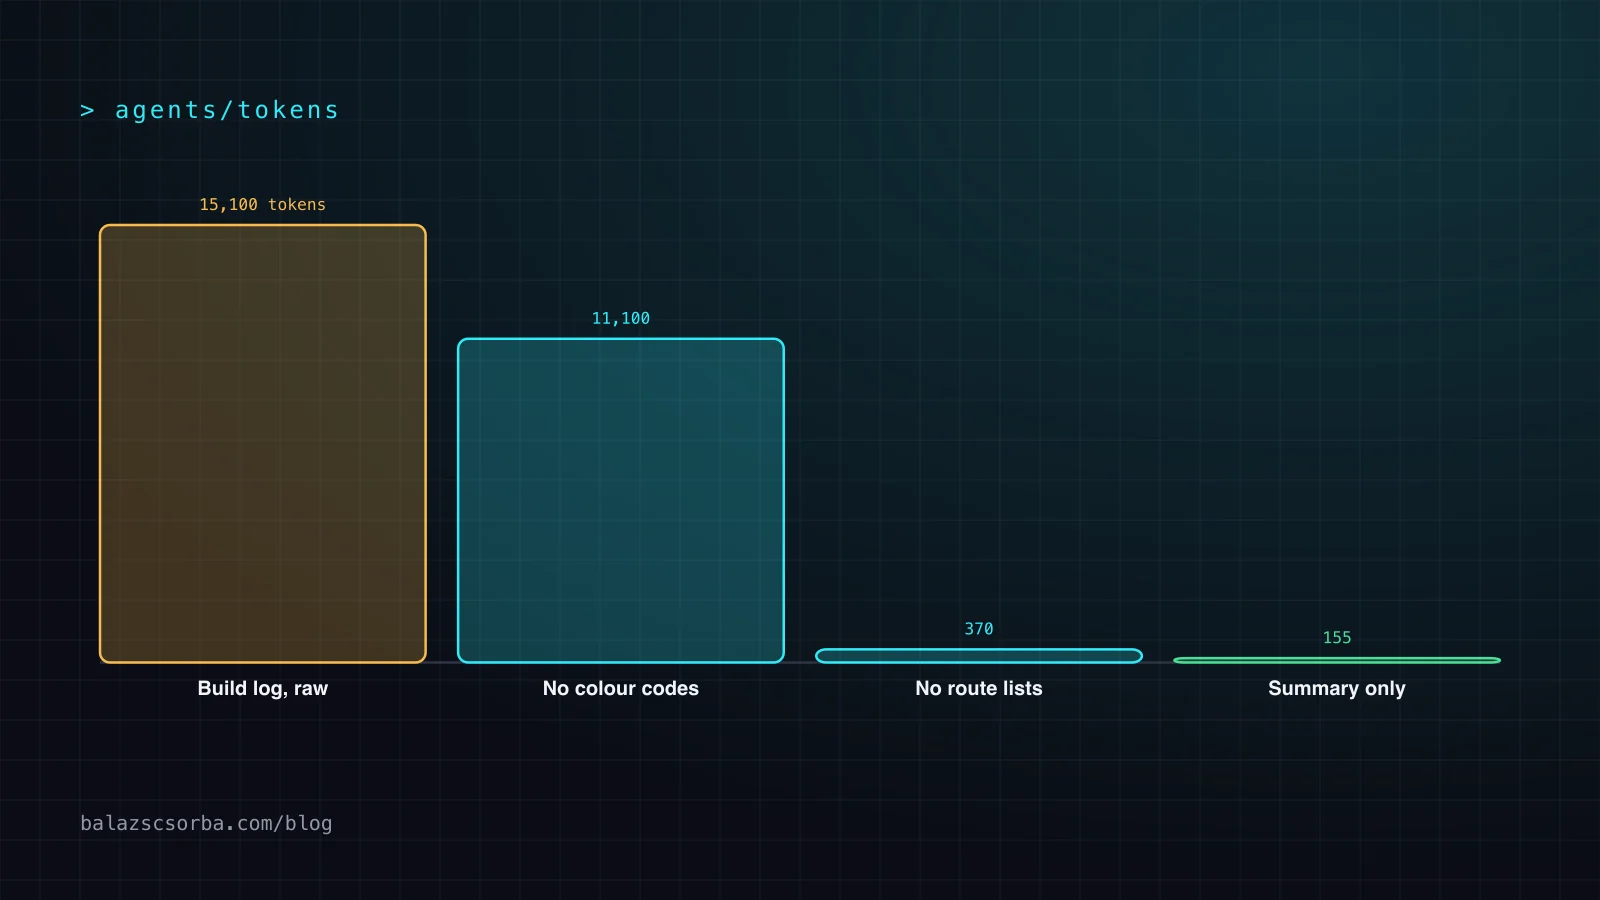
- Shell-Ausgabe war das größte Leck, das ich gemessen habe: Ein Build-Log mit 15.100 Tokens schrumpfte auf etwa 370, ohne eine nützliche Zeile zu verlieren, nur durch das Entfernen von Farbcodes, Warnungen und Routenlisten.
- Auf der Leseseite schlägt Symbolnavigation (Code-Intelligence-Plugins, Serena, lean-ctx) das Lesen ganzer Dateien. Repomix --compress kürzte TypeScript in meinem Lauf um 79 %, machte Vue-Dateien aber 30 % größer.
- Der einzige unabhängige Direktvergleich, den ich gefunden habe, sieht token-savior, claude-token-efficient und caveman mit 38–43 % vorn, gemessen an einem einzigen Repository.
Die meisten Tipps zum Sparen bei Coding-Agents laufen auf einen Screenshot mit einem Zähler hinaus, auf dem 90 % gespart steht. Ich wollte wissen, welche dieser Tools halten, was sie versprechen. Also habe ich die READMEs und Benchmarks von mehr als zwanzig Token-Sparern durchgearbeitet, sie mit dem einzigen unabhängigen Direktvergleich abgeglichen, den ich finden konnte, und zwei der Ideen an der Codebasis dieser Website selbst gemessen. Herausgekommen ist dieses Ranking.
Das Ranking ist für Claude Code geschrieben, weil ich damit arbeite und die offizielle Dokumentation dort am konkretesten ist. Die meisten Tools auf der Liste lassen sich aber auch in Cursor, Codex, OpenCode oder jeden anderen Agent einbinden, der MCP spricht oder Shell-Hooks ausführt. Warum die Kontextgröße Kosten und Qualität zugleich bestimmt, erklären Context Engineering für Coding-Agents und Prompt Caching und Model Routing.
Woher die Tokens eines Agent-Turns kommen
Jede Anfrage eines Agents enthält vier Arten von Tokens, und jedes Tool auf dieser Liste setzt bei einer davon an. Das Präfix sind System-Prompt, Tool-Definitionen und CLAUDE.md. Lesen umfasst die Dateien und Suchtreffer, die der Agent lädt, um den Code zu verstehen. Tool-Ausgabe ist alles, was Shell-Befehle, Testrunner und MCP-Server zurückgeben. Modellausgabe sind Thinking und Antwort. Alle vier sammeln sich im Verlauf, und der wird mit jedem Turn erneut gesendet.
Die Preise sind nicht symmetrisch, und das entscheidet, wo Sparen etwas bringt. Bei Claude Opus 5.5 kostet laut der Prompt-Caching-Dokumentation ein gecachter Input-Token 0,20 $ pro Million, ein frischer 4 $ und ein Output-Token 20 $. Ein stabiles, gecachtes Präfix ist nach der ersten Anfrage also fast kostenlos. Geld kostet neuer Inhalt: frisch gelesene Dateien, frische Tool-Ausgabe und alles, was das Modell schreibt, Thinking eingeschlossen. Der Kostenleitfaden von Claude Code nennt im Schnitt etwa 13 $ pro Entwickler und aktivem Tag, bei 90 % der Nutzer unter 30 $. Das Problem ist also selten eine große Rechnung, sondern ein stetiges Leck über viele Turns.
Was ich an dieser Website gemessen habe
Zwei der Versprechen ließen sich hier mit wenig Aufwand prüfen. Diese Website ist eine Nuxt-4-App mit etwa 110 Vue-, TypeScript- und Skriptdateien, und ihr Build gibt eine Menge aus. Ich habe Repomix 1.18.1 mit dem Standard-Tokenizer o200k_base über den Quellcode laufen lassen, einmal normal und einmal mit --compress. Diese Option behält mit tree-sitter die Signaturen und wirft die Funktionskörper weg. Das README nennt etwa 70 % Ersparnis.
Bei den TypeScript- und Skriptdateien hält das Versprechen und übertrifft es sogar: Aus 133.146 Tokens wurden 28.402, 79 % weniger. Bei den Vue-Single-File-Components ging es in die andere Richtung: Aus 72.298 Tokens wurden 94.096, also 30 % mehr, und 46 der 49 Dateien wurden größer. Ein Blick in die Ausgabe zeigt, warum: Die komprimierten Vue-Dateien enthielten das vollständige Template und danach Teile davon noch einmal als zusätzliche Abschnitte zwischen ⋮-----Markern. Über die ganze Codebasis waren es 40 % Ersparnis, nicht 70.
Der zweite Test war der Anwendungsfall hinter rtk und allen anderen Ausgabefiltern auf dieser Liste: ein lauter Befehl. Ein vollständiges npm run generate dieser Website schreibt 501 Zeilen. Ich habe das Log schrittweise ausgedünnt und die Tokens als Bytes geteilt durch vier geschätzt, dieselbe grobe Faustregel, die rtk verwendet.
| Stufe | Bytes | Tokens (Bytes/4) | Zeilen |
|---|---|---|---|
| Rohes Log, wie in die Datei geschrieben | 60.311 | ~15.100 | 501 |
| Ohne ANSI-Farbcodes | 44.426 | ~11.100 | 501 |
| Ohne Node-Warnungen zu experimentellen Features | 42.144 | ~10.500 | 481 |
| Ohne die Listen aller Routen und Chunks | 1.479 | ~370 | 46 |
| Nur Zusammenfassungs- und Fehlerzeilen | 620 | ~155 | 12 |
Allein die Farbcodes machten ein Viertel des Logs aus, obwohl die Ausgabe in eine Datei umgeleitet war. Die Listen der vorgerenderten Routen und gebauten Chunks waren 96 % des Rests, und bei einem grünen Build sagt nichts davon einem Modell irgendetwas. Wer diese drei Dinge weglässt, behält jede Zeile, auf die ein Mensch reagieren würde, und spart 97,5 % der Tokens. Bei einem roten Build braucht man die Fehlerzeilen und ein paar Zeilen drumherum, und genau die behält ein guter Filter.
Die Top 20 im Ranking
Ich habe nach vier Kriterien gerankt, in dieser Reihenfolge: ob die Ersparnis durch mehr belegt ist als den Benchmark des Autors, wie viel einer echten Session sie betrifft, wie lange die Einrichtung dauert und was sie riskiert, von verlustbehafteter Ausgabe bis zu einer einschränkenden Lizenz. Bordmittel kommen zuerst, weil sie kostenlos und dokumentiert sind; danach folgen die Tools von Drittanbietern, sortiert nach Belegen.
| # | Tool oder Gewohnheit | Ebene | Belege | Einrichtung |
|---|---|---|---|---|
| 1 | /usage, /context, ccusage | alle | die Messung selbst | Minuten |
| 2 | /clear und ein gezieltes /compact | Verlauf | offizielle Doku | keine |
| 3 | Stabiles Präfix fürs Prompt Caching | Präfix | offizielle Preise | keine |
| 4 | Tool Search, weniger MCP-Server, CLIs | Präfix | offiziell: über 85 % der Tool-Definitionen | Minuten |
| 5 | Effort und Modellwahl | Modellausgabe | offizielle Doku | keine |
| 6 | rtk | Tool-Ausgabe | angegeben 60–90 %; gemessen 0–90 % | 5 Minuten |
| 7 | context-mode | Tool-Ausgabe | angegeben bis 98 %; gemessen 20–98 % | 10 Minuten |
| 8 | Eigene Filter-Hooks, MAX_MCP_OUTPUT_TOKENS | Tool-Ausgabe | mein Build-Log: −97,5 % | eine Stunde |
| 9 | lean-ctx | Lesen | angegeben 98 % im Map-Modus | 10 Minuten |
| 10 | Serena | Lesen | Mechanismus; keine neutrale Zahl | 15 Minuten |
| 11 | Code-Intelligence-Plugins | Lesen | offizielle Doku | Minuten |
| 12 | Schlanke CLAUDE.md, Skills für den Rest | Präfix | offiziell: unter 200 Zeilen | eine Stunde |
| 13 | Subagents für ausufernde Arbeit | Verlauf | offizielle Doku | keine |
| 14 | token-savior | Lesen | gemessen −43 % | 15 Minuten |
| 15 | Repo-Maps: Aider, code-review-graph | Lesen | angegeben groß; gemessen −5 % in einem kleinen Repo | unterschiedlich |
| 16 | repomix --compress | Lesen | mein Lauf: −79 % TS, +30 % Vue | Minuten |
| 17 | Context7 | Lesen | Mechanismus; keine Zahl | Minuten |
| 18 | claude-context | Lesen | angegeben etwa 40 %; gemessen 30–60 % in Monorepos | eine Stunde, braucht eine Vektor-DB |
| 19 | Knappe Ausgaberegeln: caveman, claude-token-efficient | Modellausgabe | 4–12 % der Output-Tokens | Minuten |
| 20 | claude-code-router | Preis, nicht Tokens | 3- bis 5-mal günstiger bei umgeleiteten Turns | eine Stunde |
Der einzige unabhängige Direktvergleich, den ich gefunden habe, stammt von ComputingForGeeks aus dem April 2026: ein Repository (sindresorhus/ky), Claude Code 2.1.116 und Sonnet 4.5, gegen eine Basislinie von 284.473 Tokens und 0,27 $. Ein einzelnes Repository ist ein dünner Beleg, deshalb nutze ich den Test zum Entscheiden knapper Fälle, nicht als Urteil.
| Tool | Veränderung der Gesamt-Tokens | Anmerkung |
|---|---|---|
| token-savior | −43 % | Symbolindex und Gedächtnis per MCP |
| claude-token-efficient | −40 % | CLAUDE.md-Regeln |
| caveman | −38 % | Ausgabestil |
| token-optimizer-mcp | −23 % | MCP-Server |
| alexgreensh/token-optimizer | −18 % | Lizenz PolyForm Noncommercial |
| code-review-graph | etwa −5 % | kleines Repo, der Graph-Overhead frisst den Gewinn |
| rtk | 0 % bei sauberer Ausgabe, 60–90 % bei lauten Logs | hängt von den Befehlen ab |
| context-mode | −20 % bis −98 % | hängt von der Arbeit ab |
Plätze 1–5: Bordmittel, die nichts kosten
1. Zuerst messen: /usage, /context und ccusage
/usage zeigt die Tokens der Session und in aktuellen Versionen eine Zeile zum Prompt Cache: den Anteil des Inputs aus dem Cache, die Zahl der Cache-Misses und eine wahrscheinliche Ursache für den letzten. /context zeigt, was das Fenster gerade füllt: System-Prompt, Tools, Memory-Dateien und Nachrichten. Für den Verlauf über mehrere Sessions liest ccusage (npx ccusage@latest, MIT) die lokalen JSONL-Logs und erstellt Berichte nach Tag, Monat, Session und Fünf-Stunden-Block. Ohne Basislinie kannst du ein Tool mit 40 % nicht von einem Placebo unterscheiden.
2. /clear zwischen Aufgaben, /compact mit Anweisungen
Der gesamte Verlauf geht mit jedem Turn mit, veralteter Kontext aus der letzten Aufgabe wird also mit jeder neuen Nachricht erneut bezahlt. /clear fängt frisch an und kostet nichts. /compact Konzentriere dich auf den fehlschlagenden Test und den Diff erhält den Zusammenhang, muss dafür aber das ganze Gespräch lesen, um es zusammenzufassen, und ist damit selbst eine große Anfrage. Mit /rename vor dem Leeren findest du die Session später über /resume wieder.
3. Das Präfix stabil halten, damit Caching greift
Caching ist der größte Rabatt auf dieser Liste und standardmäßig aktiv, deshalb macht man es leicht unbemerkt kaputt. Der Cache folgt der Reihenfolge Tools, System-Prompt, Nachrichten: Ändert sich eine Tool-Definition, wird alles danach neu geschrieben, zum höheren Preis für Cache-Writes. In der Praxis heißt das: MCP-Server nicht mitten in der Session an- und ausschalten und CLAUDE.md nicht mitten in einer langen Aufgabe bearbeiten. Die Lebensdauer des Caches beträgt im Abo eine Stunde und mit API-Key standardmäßig fünf Minuten. Über die API kostet eine Kaffeepause also ein komplettes Neulesen des Kontexts.
4. Weniger MCP-Server, verzögert geladene Tools, CLIs wo vorhanden
Die Dokumentation zu Tool Search von Anthropic nennt eine konkrete Zahl: Fünf gängige Server (GitHub, Slack, Sentry, Grafana und Splunk) belegen etwa 55.000 Tokens an Definitionen, bevor überhaupt gearbeitet wird, und verzögertes Laden senkt das typischerweise um mehr als 85 %. Außerdem wird die Tool-Auswahl ab 30 bis 50 geladenen Tools schlechter. Claude Code lädt MCP-Tools standardmäßig verzögert, doch die MCP-Doku nennt Setups, in denen Tool Search aus ist, darunter ENABLE_TOOL_SEARCH=false und eine eigene ANTHROPIC_BASE_URL. Darüber hinaus: ungenutzte Server in /mcp deaktivieren und gh, aws oder gcloud einem MCP-Wrapper für dieselbe API vorziehen, denn eine CLI fügt gar keine Tool-Liste hinzu.
5. Effort und Modell an die Aufgabe anpassen
Thinking-Tokens werden als Output-Tokens abgerechnet, die teuerste Sorte. /effort senkt das Reasoning-Budget bei adaptiven Modellen, /model wechselt zu einem günstigeren; Subagents laufen mit model: haiku in ihrer Definition auf Haiku. Wie groß der Hebel ist, zeigen die Leaderboard-Zahlen zu Opus 5.5: Mit Effort medium erreichte das Modell den Wert seines Vorgängers mit Effort max, für etwa ein Viertel der Kosten pro Aufgabe.
Plätze 6–8: Tool-Ausgabe filtern, bevor das Modell sie liest
6. rtk
rtk ist eine Rust-CLI, die sich über einen PreToolUse-Hook (rtk init -g) vor Shell-Befehle setzt und die Ausgabe von mehr als hundert Befehlen filtert, gruppiert, kürzt und dedupliziert. Das README nennt etwa 70 % für ls und tree, etwa 80 % für git diff und 90 % für cargo test. Der unabhängige Test fand 0 % bei ohnehin ruhigen Befehlen und 60–90 % bei lauten Logs, was zu meinem Build-Log passt. Zwei Grenzen: Die Zahlen messen weniger Ausgabe, nicht eine kleinere Rechnung, und der Hook sieht nur Shell-Befehle, die eingebauten Read-, Grep- und Glob-Tools von Claude Code laufen also ungefiltert durch. Apache 2.0.
7. context-mode
context-mode geht einen anderen Weg: Tool-Ausgabe landet in einer Sandbox und einem SQLite-FTS5-Index, und der Agent durchsucht sie mit BM25, statt sie ganz zu lesen. Das Projekt nennt 315 KB Ausgabe, die auf 5,4 KB schrumpfen, einen Playwright-Snapshot von 56 KB auf 299 Bytes und ein Access-Log von 45 KB auf 155 Bytes. Außerdem hält es einen Session-Leitfaden von höchstens 2 KB vor, der das Kompaktieren übersteht. Der unabhängige Test maß je nach Arbeit 20–98 %. Die Lizenz ist die Elastic License 2.0, für den eigenen Gebrauch in Ordnung, aber keine OSI-Open-Source-Lizenz.
8. Eigene Filter-Hooks und eine Obergrenze für MCP-Ausgabe
Der offizielle Kostenleitfaden zeigt einen PreToolUse-Hook, der Testbefehle so umschreibt, dass nur Fehlschläge beim Modell ankommen. Dieselbe Idee passt zu jedem Befehl, den man oft ausführt. So würde ich ihn für den Build oben schreiben:
#!/bin/bash
# ~/.claude/hooks/quiet-build.sh: a PreToolUse hook with "matcher": "Bash".
# Rewrites the site build so the model sees summary and error lines, not 500 lines of routes.
input=$(cat)
cmd=$(echo "$input" | jq -r '.tool_input.command')

if [[ "$cmd" =~ ^npm\ run\ generate ]]; then
  quiet="set -o pipefail; $cmd 2>&1 | perl -pe 's/\e\[[0-9;]*m//g' | grep -vE 'ExperimentalWarning|trace-warnings|├─|└─|node_modules/.cache'"
  echo "$input" | jq --arg c "$quiet" \
    '{hookSpecificOutput: {hookEventName: "PreToolUse", permissionDecision: "allow", updatedInput: (.tool_input + {command: $c})}}'
else
  echo "{}"
fi
Gegen das Log aus der Tabelle laufen gelassen, bleiben genau die 46 Zeilen aus der vierten Zeile übrig, und dank pipefail endet ein fehlgeschlagener Build weiterhin mit einem Fehlercode. Registriert wird er in der settings.json unter hooks.PreToolUse mit "matcher": "Bash", wie im offiziellen Beispiel, geprüft mit /hooks. Wie das Beispiel antwortet er mit allow, was für den umgeschriebenen Befehl auch die Berechtigungsabfrage überspringt, also das Muster eng halten. Bei MCP-Servern ist MAX_MCP_OUTPUT_TOKENS der entsprechende Hebel: Claude Code warnt, wenn ein einzelnes Tool-Ergebnis 10.000 Tokens überschreitet, und erlaubt standardmäßig 25.000. Eine niedrigere Grenze verhindert, dass ein geschwätziger Server das Fenster flutet.
Plätze 9–11: Symbole lesen statt ganzer Dateien
9. lean-ctx
lean-ctx ist ein lokales Rust-Binary samt MCP-Server, das dem Agent zehn Arten gibt, eine Datei zu lesen, vom vollen Text über eine Strukturübersicht bis zu reinen Signaturen, dazu Kompressionsmuster für mehr als 95 Shell-Befehle. Im eigenen Repository des Projekts mit 50 Dateien, gezählt mit dem GPT-4o-Tokenizer, wurden aus 533.200 Roh-Tokens im Map-Modus 8.000 und im Signaturmodus 14.000, und das erneute Lesen einer unveränderten Datei aus dem Cache kostet etwa 13 Tokens. Es ist das ambitionierteste Tool hier, und die Zahlen stammen vom Autor selbst, doch die Idee, erst die Struktur und Funktionskörper nur bei Bedarf zu lesen, ist richtig. lean-ctx wrap claude, Apache 2.0.
10. Serena
Serena verpackt Language Server für mehr als 40 Sprachen in MCP-Tools wie find_symbol, find_referencing_symbols und replace_symbol_body. Statt zu greppen und drei Kandidatendateien zu lesen, fragt der Agent nach einem Symbol und bearbeitet es direkt. Einen neutralen Benchmark habe ich nicht gefunden, aber der Mechanismus ist derselbe, den Anthropic im nächsten Punkt empfiehlt, und er funktioniert in jedem MCP-Client. Installation mit uv tool install -p 3.13 serena-agent und serena init; GPL-3.0.
11. Code-Intelligence-Plugins
Die Code-Intelligence-Plugins von Claude Code bringen dieselbe Idee ohne Server von Drittanbietern: Gehe zu Definition und Referenzen finden über einen installierten Language Server. Der Kostenleitfaden sagt es direkt: Eine Definitionssuche ersetzt ein grep mit anschließendem Lesen mehrerer Kandidatendateien, und der Language Server meldet nach Änderungen Typfehler, was einen Compile-Durchlauf spart. Bei TypeScript-, Python-, Go- oder Rust-Projekten ist das die erste Änderung auf der Leseseite, die ich machen würde.
Plätze 12–13: den Hauptkontext klein halten
12. Eine schlanke CLAUDE.md, Skills für den Rest
CLAUDE.md wird in jede Session geladen, jede Zeile darin wird also bei jeder Anfrage bezahlt, gecacht oder nicht. Die offizielle Empfehlung lautet, sie unter 200 Zeilen zu halten und Anweisungen für bestimmte Abläufe, etwa wie ein PR geprüft oder eine Migration ausgeführt wird, in Skills zu verschieben, die erst bei Bedarf geladen werden. Ein kurzer Skill, der die Architektur beschreibt, spart außerdem die Erkundungslektüre, mit der ein Agent jede Aufgabe beginnt.
13. Subagents für ausufernde Arbeit
Ein Subagent führt Tests aus, liest Logs oder holt Dokumentation in seinem eigenen Kontext und liefert eine Zusammenfassung zurück, der ausufernde Teil landet also nie im Hauptverlauf. Er kostet trotzdem Tokens, nur nicht bei jedem späteren Turn erneut, und er kann auf einem kleinen Modell laufen. Die Gegenwarnung steht in derselben Doku: Agent Teams verbrauchen etwa siebenmal so viele Tokens wie eine normale Session, wenn die Teammitglieder im Plan-Modus laufen, weil jedes seinen eigenen vollen Kontext hat.
Plätze 14–18: Indizes, Karten und Dokumentation
14. token-savior
token-savior kombiniert einen Symbolindex per MCP, einen Gedächtnisspeicher und das Verdichten von Bash-Ausgabe. Im unabhängigen Test sparte es am meisten, 43 % der Gesamt-Tokens. Die eigene Schlagzeile des Projekts, 80 % weniger aktive Tokens über 96 Aufgaben mit Opus 4.7, kennzeichnet der Autor als nicht verifiziert, und eine frühere Zahl wurde zurückgezogen. Das lese ich als Zeichen von Ehrlichkeit, nicht als Grund, der größeren Zahl zu trauen. MIT.
15. Repo-Maps: Aider und code-review-graph
Eine Repo-Map gibt dem Agent eine gewichtete Gliederung der Codebasis statt ganzer Dateien. Aiders Repo-Map entsteht mit tree-sitter und einem Graph-Ranking und passt in ein Budget, das --map-tokens festlegt, standardmäßig 1.000 Tokens. code-review-graph speichert einen Aufrufgraphen in SQLite und beantwortet, was eine Änderung alles berührt. Es nennt im Median etwa 63-mal weniger Tokens pro Frage, sagt aber selbst, dass dabei eine Graph-Abfrage mit dem gesamten Korpus verglichen wird, also eine Obergrenze. Im unabhängigen Test an einem kleinen Repository sparte es etwa 5 %, weil der Graph-Overhead den Großteil des Gewinns auffraß. Lohnt sich bei großen Repositories, nicht bei kleinen. MIT.
16. Repomix --compress
Repomix packt ein Repository in eine einzige Datei für ein Modell, mit --token-count-tree, das zeigt, wo die Tokens stecken, dazu --remove-comments und einem MCP-Modus. --compress eignet sich, um einem Modell auf einen Schlag einen Überblick auf Signaturebene über eine TypeScript-, Python- oder Go-Codebasis zu geben, wie mein Lauf gezeigt hat. Bei Template-lastigen Formaten wie Vue lohnt sich ein Blick in die Ausgabe, bevor man sich darauf verlässt. MIT.
17. Context7 für Bibliotheksdokumentation
Context7 holt auf Anfrage aktuelle, versionsgenaue Dokumentation zu einer Bibliothek, entweder über ctx7-CLI-Befehle mit einem Skill oder über einen MCP-Server (npx ctx7 setup). Die Ersparnis ist indirekt, und ich habe keine Zahl dafür: ein gezielter Ausschnitt statt einer ganzen Webseite und weniger Runden, in denen eine API korrigiert wird, die das Modell aus einer älteren Version kannte. MIT.
18. claude-context
claude-context indiziert die Codebasis für eine hybride Suche aus BM25 und Vektoren, damit der Agent nach dem Code fragen kann, der die Authentifizierung erledigt, und die passenden Abschnitte bekommt. Es nennt etwa 40 % weniger Tokens bei gleicher Trefferqualität, und der unabhängige Test sah 30–60 % in Monorepos. Der Preis ist Infrastruktur: ein Embedding-Anbieter (OpenAI, VoyageAI, Gemini oder ein lokales Ollama) und eine Vektordatenbank, Milvus oder Zilliz Cloud. Das lohnt sich bei großen Monorepos und ist darunter zu viel des Guten. MIT.
Plätze 19–20: Ausgabestil und Routing
19. Knappe Ausgaberegeln: caveman und claude-token-efficient
Diese Tools ändern, wie das Modell schreibt, nicht was es liest. caveman ist ein Skill mit den Modi lite, full und ultra für abgehackte Prosa; claude-token-efficient ist eine CLAUDE.md mit acht Regeln. Die sorgfältig gemessenen Zahlen sind klein. Für caveman fand ein JetBrains-Laborlauf über 86 Aufgaben 8,5 % weniger Output-Tokens bei gleicher Qualität, die eigene Auswertung des Projekts zeigt im Median 50 % bei kurzen Fragen und Antworten, und in agentischen Sessions sind es hohe einstellige Werte, während die Regeldatei etwa 1.000 Input-Tokens hinzufügt. claude-token-efficient maß 4 % weniger Output-Tokens bei Haiku, 12 % bei Sonnet und 7 % bei Opus. Die −38 % und −40 % aus dem unabhängigen Test liegen weit darüber, und von einem einzigen Repository würde ich nicht verallgemeinern. Günstig auszuprobieren und am nützlichsten, wenn man für viel Ausgabe bezahlt.
20. claude-code-router
claude-code-router ist ein lokales Gateway, das Anfragen von Claude Code nach Regeln an andere Anbieter und Modelle schickt, etwa DeepSeek, Gemini, Kimi oder OpenRouter. Es senkt keine Tokens, es macht einige davon billiger, und der unabhängige Test meldete drei- bis fünfmal niedrigere Kosten bei den umgeleiteten Turns. Dass es auf dem letzten Platz steht, hat einen Grund: Ein Router bedeutet eine eigene ANTHROPIC_BASE_URL, und das ist eines der Setups, in denen Claude Code MCP Tool Search abschaltet. Außerdem beginnt jeder Wechsel zu einem anderen Modell dessen Cache bei null. Miss die ganze Session, nicht nur die umgeleiteten Turns. MIT.
Was ich weglassen oder vorsichtig einsetzen würde
- LLMLingua und andere Prompt-Kompressoren. LLMLingua lässt Tokens weg, die ein kleines Modell für unwichtig hält, und nennt bis zu 20-fache Kompression bei geringem Verlust für Fließtext, Retrieval und Reasoning-Prompts. Für Code, den ein Agent exakt bearbeiten muss, ist verlustbehaftete Kompression der falsche Tausch.
- Tools, deren Lizenz nicht passt. alexgreensh/token-optimizer sparte im unabhängigen Test 18 %, steht aber unter PolyForm Noncommercial und fällt damit für Kundenprojekte weg.
- Alles ohne Vorher-nachher-Messung. Der unabhängige Test empfahl nadimtuhin/claude-token-optimizer nicht und fand die Wirkung von claude-mem schwankend. Gedächtnis-Tools können das erneute Erklären sparen oder veraltete Notizen in jede Session schleusen.
- Drei Tools auf derselben Ebene. rtk, context-mode und lean-ctx fangen alle Shell-Ausgabe ab. Nimm eines pro Ebene, sonst suchst du am Ende, welcher Hook was umgeschrieben hat.
Ein Starter-Stack für einen Nachmittag
npx ccusage@latest dailyausführen und eine normale Session mit/usageam Ende. Die Zahlen notieren./contextöffnen, MCP-Server abschalten, die du diese Woche nicht genutzt hast, und jene ersetzen, für die es eine CLI gibt (ghstatt eines GitHub-Servers).- CLAUDE.md auf unter 200 Zeilen kürzen und Abläufe in Skills verschieben.
- Das Code-Intelligence-Plugin für deine Hauptsprache installieren, oder Serena, wenn du mehrere Agents nutzt.
- Einen Ausgabefilter ergänzen: rtk, wenn es fertig sein soll, einen Hook mit 15 Zeilen wie den oben, wenn du genau sehen willst, was wegfällt.
- Dieselbe Art von Session wiederholen und vergleichen. Behalten, was die Zahl bewegt hat, den Rest deinstallieren.
Die Überlegung hinter dieser Reihenfolge erklärt Harness Engineering: wie Leitplanken und Sensoren den Kontext eines Agents nützlich halten, nicht nur klein.
Quellen
- rtk: a CLI proxy that filters shell output for coding agents (GitHub)
- lean-ctx: context read modes and shell compression for coding agents (GitHub)
- context-mode: sandboxed tool output with SQLite FTS5 search (GitHub)
- Serena: semantic code retrieval and editing over MCP (GitHub)
- token-savior: symbol index, memory and bash compaction over MCP (GitHub)
- code-review-graph: a code graph for blast-radius reviews (GitHub)
- Aider documentation: repository map
- Repomix: pack a repository into one AI-friendly file (GitHub)
- Context7: up-to-date library documentation for LLMs (GitHub)
- claude-context: hybrid code search MCP (GitHub)
- caveman: terse output modes for coding agents (GitHub)
- claude-token-efficient: an eight-rule CLAUDE.md (GitHub)
- claude-code-router: a local model gateway for coding agents (GitHub)
- ccusage: token and cost reports from local agent logs (GitHub)
- LLMLingua: prompt compression (Microsoft, GitHub)
- ComputingForGeeks: tools that reduce Claude Code token usage, tested (April 2026)
- Claude Code docs: manage costs effectively
- Claude Code docs: MCP, output limits and tool search
- Claude API docs: tool search tool
- Claude API docs: prompt caching
Häufige Fragen
Welches Tool senkt den Token-Verbrauch von Claude Code am stärksten?
Es gibt nicht das eine Tool, weil jedes an einer anderen Stelle eines Turns ansetzt. Fang mit den kostenlosen Bordmitteln an: /clear zwischen Aufgaben, ein stabiles Präfix fürs Caching, weniger MCP-Server und niedrigerer Effort. Danach einen Ausgabefilter wie rtk oder context-mode und ein Werkzeug für die Leseseite wie ein Code-Intelligence-Plugin oder Serena ergänzen und vorher und nachher messen.
Spart rtk wirklich 90 % der Tokens?
Bei lauten Befehlen wie Testläufen und Build-Logs entfernt es 60–90 % der Ausgabe, und ein unabhängiger Test hat diese Spanne bestätigt. Bei Befehlen mit ohnehin kurzer Ausgabe spart es fast nichts, und die eingebauten Read-, Grep- und Glob-Tools von Claude Code erreicht es gar nicht. Auf eine ganze Session wirkt es deshalb deutlich schwächer als die Schlagzeile.
Ist es sicher, den Kontext eines Coding-Agents zu komprimieren?
Methoden, die die Struktur erhalten, sind sicher: Rauschen aus Logs filtern, erst Signaturen und dann Funktionskörper lesen, Symbole über einen Language Server nachschlagen. Verlustbehaftete Prompt-Kompression, die einzelne Tokens weglässt, etwa LLMLingua, passt zu Fließtext und Retrieval, aber nicht zu Code, den der Agent exakt bearbeiten muss.
Wie messe ich meinen Token-Verbrauch in Claude Code?
Mit /usage für die aktuelle Session, inklusive Cache-Trefferquote, und mit /context, um zu sehen, was das Kontextfenster füllt. Für den Verlauf über mehrere Sessions liest ccusage die lokalen Logs und zeigt den Verbrauch nach Tag, Monat, Session oder Fünf-Stunden-Block.