Blog/KI-Agenten
Multi-Agent-Systeme: wann sie einen Agenten schlagen und wann nicht
Orchestrator-Worker, Fan-out, Critic, Handoff: was Multi-Agent-Systeme wirklich bringen, was sie an Tokens kosten, wie sie scheitern, mit Entscheidungstabelle.
Balázs Csorba··12 Min. Lesezeit
- Multi-agent systems
- AI agents
- Orchestrator-worker
- Context engineering
Das Wichtigste in Kürze
- Anthropic hat für einen Agenten etwa das 4-Fache der Tokens eines Chats gemessen, für ein Multi-Agent-System etwa das 15-Fache. Ein Multi-Agent-Design muss diesen Faktor wert sein.
- Der eigentliche Nutzen ist Kontext-Isolation: Ein Worker erkundet in seinem eigenen Fenster und liefert eine Zusammenfassung. Das hält den Lead-Agenten fokussiert und lässt die Breite ein Kontextfenster übersteigen.
- Paralleles Lesen skaliert gut, paralleles Schreiben und eng gekoppelte Schritte nicht. Google Research sah +81 % bei einer parallelisierbaren und 39 bis 70 % Verlust bei einer sequenziellen Aufgabe.
- Die meisten Fehler sind Koordinationsfehler (vage Vorgaben, verlorener Kontext, fehlende Verifikation), keine Modellfehler. Debatten-Setups schlagen oft nicht einmal eine einfache Single-Agent-Baseline.
- Starte mit einem Agenten und einem guten Harness, füge einen Subagenten nur aus gemessenem Grund hinzu, halte Schreibzugriffe single-threaded und miss die Multi-Agent-Variante gegen die Single-Agent-Variante.
Alle paar Monate macht ein neues Framework es trivial, ein Team aus Agenten zu starten: Planer, Rechercheur, Coder, Reviewer. Die Diagramme sehen aus wie ein Organigramm, und man neigt zur Annahme, mehr Agenten bedeuteten mehr Intelligenz. Die veröffentlichte Evidenz sagt etwas Vorsichtigeres: Multi-Agent-Systeme sind hervorragend für eine enge Klasse von Problemen, überall teuer und bei erstaunlich vielen Aufgaben leise schlechter als ein einzelner Agent.
Dieser Beitrag ordnet die Muster, beziffert die Kosten, listet die Fehlermodi, die Forschung und Hersteller dokumentiert haben, und endet mit einem Entscheidungsrahmen für deinen eigenen Anwendungsfall. Meine Position vorweg: Starte mit einem Agenten und behandle jeden weiteren Agenten als Anschaffung, die du begründen musst. Die stärkste Begründung ist nicht „Spezialisierung“ oder „Teamarbeit“. Es ist Kontext-Isolation.
Wenn du zuerst die Grundlagen eines einzelnen Agenten möchtest, lies die Agent-Loop erklärt. Alles Folgende setzt voraus, dass du bereits einen funktionierenden Agenten hast.
Vier Muster und wofür jedes gut ist
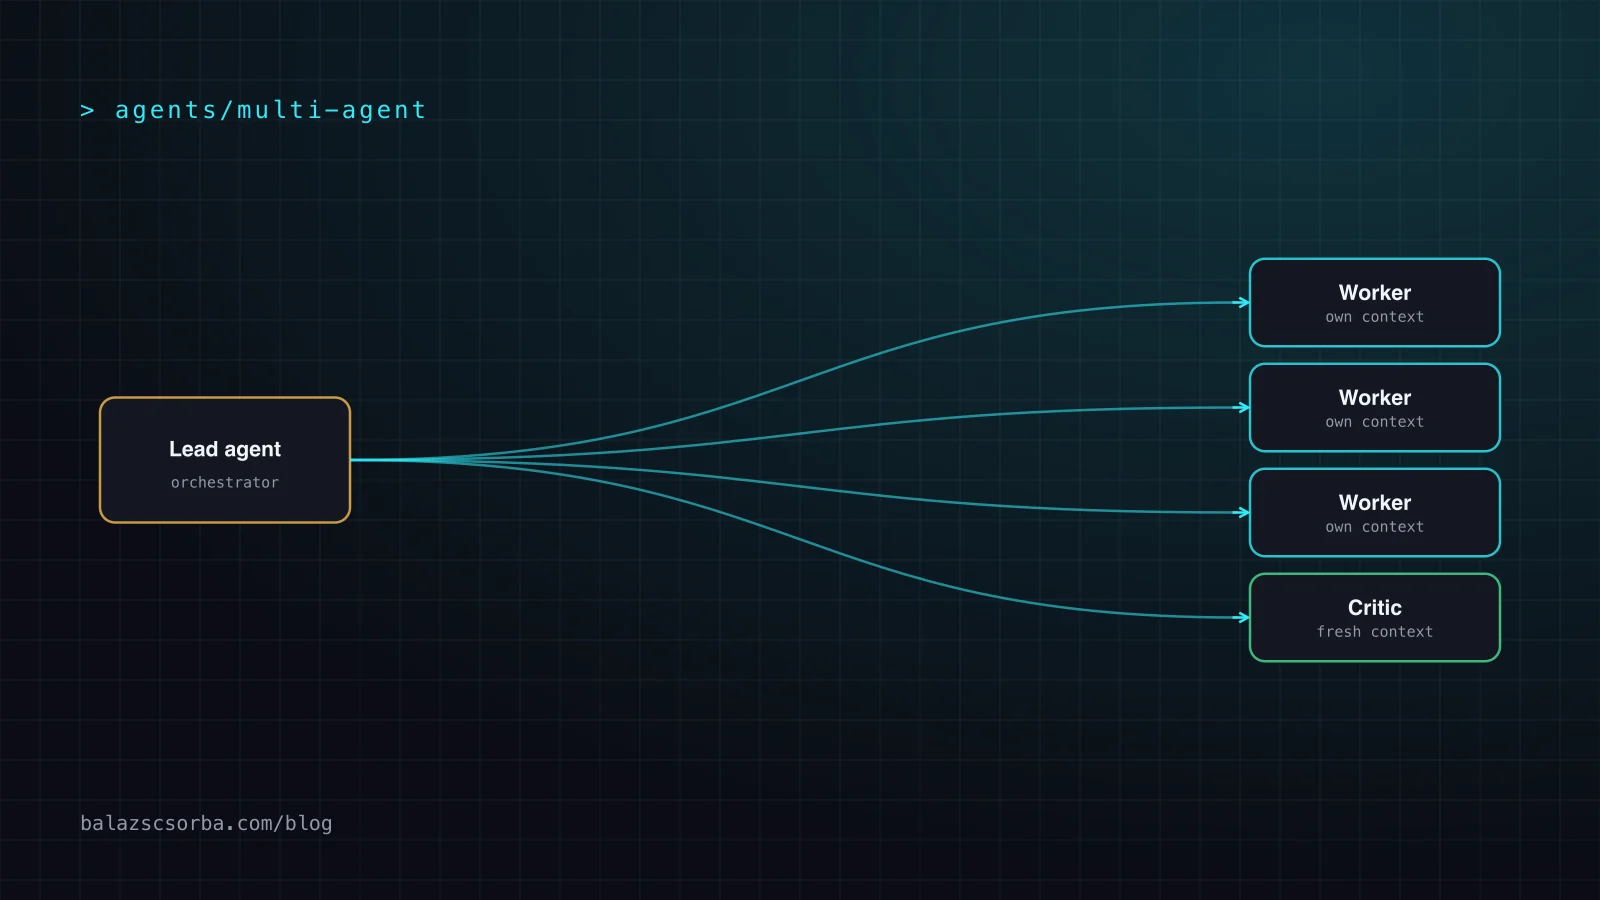
Die meisten Multi-Agent-Designs kombinieren vier Grundformen. Sie unterscheiden sich darin, wer die Kontrolle hält, wer welchen Kontext sieht und wo die Ergebnisse zusammengeführt werden.
Im Detail:
- Orchestrator-Worker. Ein Lead-Agent plant, delegiert an Worker und fasst zusammen. Anthropic beschreibt in Building effective agents ein zentrales LLM, das Aufgaben „dynamisch zerlegt, an Worker-LLMs delegiert und deren Ergebnisse zusammenführt“. Geeignet ist das für Aufgaben, deren Teilschritte du vorab nicht vorhersagen kannst.
- Paralleler Fan-out. Dieselbe Idee mit fester Form: Arbeit in unabhängige Teile zerlegen, gleichzeitig ausführen, zusammenführen. Derselbe Beitrag nennt zwei Varianten: Sectioning (unabhängige Teilaufgaben) und Voting (dieselbe Aufgabe mehrfach für diverse Ergebnisse).
- Writer und Critic (Debate). Ein zweiter Agent prüft die Ausgabe des ersten, oder mehrere Agenten streiten sich zu einer Antwort. Hier ist die Evidenz am gemischtesten, wie der Abschnitt zu den Fehlern zeigt.
- Handoff. Ein Agent übergibt das Gespräch an einen Spezialisten. Im OpenAI Agents SDK wird ein Handoff dem Modell als Tool mit einem Namen wie transfer_to_refund_agent angeboten, und standardmäßig „übernimmt der neue Agent das Gespräch und sieht den gesamten bisherigen Verlauf“. Ein Input-Filter erlaubt, das einzuschränken.
Kontext-Isolation ist der eigentliche Nutzen
Frag dich, was ein zweiter Agent kann, was der erste nicht kann. Er hat kein besseres Modell und denkt nicht härter. Er hat ein leeres Kontextfenster. Ein Worker kann vierzig Suchergebnisse lesen, ein Monorepo durchsuchen oder eine laute Testsuite laufen lassen und zehn Zeilen zurückgeben. Der Lead-Agent trägt dieses Rauschen nie mit sich.
Anthropics eigene Beschreibung des Research-Systems macht das explizit: Subagenten arbeiten parallel mit eigenen Kontextfenstern, so bewältigt das System Informationen, die ein einzelnes Kontextfenster übersteigen. Die Dokumentation von Claude Code sagt dasselbe fürs Coding: Nutze einen Subagenten, wenn eine Nebenaufgabe dein Hauptgespräch „mit Suchergebnissen, Logs oder Dateiinhalten fluten würde, die du nicht mehr brauchst“, denn er erledigt die Arbeit in seinem eigenen Kontext und „gibt nur die Zusammenfassung zurück“.
Die Kehrseite ist genauso wichtig. Ein frischer Subagent erbt weder deinen Gesprächsverlauf noch deine Skills noch die bereits gelesenen Dateien, also muss alles Nötige in seinem Briefing stehen. Die Doku nennt, wann du im Hauptgespräch bleiben solltest: bei häufigem Hin und Her, bei mehreren Phasen mit viel gemeinsamem Kontext wie Planung, Implementierung und Test und bei latenzkritischer Arbeit. Das ist dieselbe Einsicht wie in Harness Engineering für Coding-Agenten: Was du ins Fenster legst und was du draußen hältst, entscheidet das Ergebnis.
Cognition fand einen zweiten, subtileren Nutzen: Ein sauberer Kontext verbessert einen Reviewer. In ihrem Follow-up vom April 2026 berichten sie, dass ihr Review-Agent besser arbeitet, wenn er den Kontext mit dem Coding-Agenten nicht teilt, weil er unabhängig denkt, statt die Annahmen des Autors zu erben. Sie geben an, dass Devin Review im Schnitt 2 Bugs pro Pull Request findet, etwa 58 % davon gravierend. Das ist eine Herstellerangabe, aber der Mechanismus ist plausibel und billig zu testen. Er passt auch zum Review-Engpass aus KI-generierte Pull Requests.
Was es kostet: der Token-Multiplikator
Anthropic ist in seinem Beitrag zum Multi-Agent-Research-System ungewöhnlich offen: Agenten verbrauchen typischerweise etwa 4-mal mehr Tokens als Chat-Interaktionen, Multi-Agent-Systeme etwa 15-mal mehr. Sie folgern, dass solche Systeme Aufgaben brauchen, deren Wert die Kosten rechtfertigt.
Derselbe Beitrag lässt eine unbequeme Lesart zu. In der Analyse des BrowseComp-Benchmarks erklärte die Token-Nutzung allein 80 % der Leistungsvarianz. Ein Teil dessen, was ein Multi-Agent-System kauft, ist schlicht mehr Nachdenken pro Frage. Das ist legitim, heißt aber: Vergleiche mit einem einzelnen Agenten mit demselben Token-Budget, nicht mit einem, der früh aufhört. Ihr Kernergebnis: Ein Claude-Opus-4-Lead mit Claude-Sonnet-4-Subagenten schlug ein einzelnes Claude Opus 4 in der internen Research-Evaluation um 90,2 %, und die Parallelisierung verkürzte die Recherchezeit bei komplexen Anfragen um bis zu 90 %.
Latenz und Geld ziehen in entgegengesetzte Richtungen. Parallele Worker verkürzen die Wanduhrzeit und erhöhen die Rechnung. Der Preis pro Token sinkt durch Caching und Routing, lies also LLM-Kosten, Latenz, Prompt Caching und Routing, bevor du den Multiplikator für unbezahlbar hältst. Günstigere Worker-Modelle, geteilte gecachte Präfixe und harte Obergrenzen für die Zahl der Worker verändern die Ökonomie erheblich.
Anthropic listet auch die Fehlermodi der frühen Versionen: 50 Subagenten für eine einfache Anfrage starten, endlos nach nicht existierenden Quellen suchen und Worker, die wegen vager Aufgabenbeschreibungen die Arbeit der anderen doppeln. Die Lösung waren explizite Skalierungsregeln im Prompt, damit der Aufwand zur Komplexität der Anfrage passt, und deutlich detailliertere Aufgabenbeschreibungen für jeden Worker.
Wie Multi-Agent-Systeme scheitern
Die Forschung ist sich in einem Punkt einig: Die Fehler betreffen meist die Koordination, nicht die Intelligenz der Modelle.
- Verstreute Entscheidungen. Cognitions Beitrag „Don't Build Multi-Agents“ vom Juni 2025 beruht auf zwei Prinzipien: Kontext teilen und „Aktionen tragen implizite Entscheidungen“. Ihr Beispiel ist ein Flappy-Bird-Klon, der in Teilaufgaben zerlegt wird: Ein Subagent baut einen Hintergrund im Super-Mario-Stil, ein anderer einen Vogel, der weder aussieht noch sich verhält wie Flappy Bird, und der letzte Agent muss die Diskrepanz zusammenführen. Ihr Fazit: Mehrere zusammenarbeitende Agenten ergeben nur fragile Systeme.
- Sequenzielle Arbeit wird schlechter. Google Research evaluierte 180 Agentenkonfigurationen. Zentrale Koordination verbesserte eine parallelisierbare Finanzaufgabe um 80,9 % gegenüber einem einzelnen Agenten, während bei einer sequenziellen Planungsaufgabe jede getestete Multi-Agent-Variante die Leistung um 39 bis 70 % verschlechterte. Unabhängige Agenten verstärkten Fehler 17,2-fach, ein zentraler Orchestrator nur 4,4-fach, weil er als Validierungsengpass wirkt. Die Autoren berichten außerdem einen Tool-Koordinations-Trade-off: Der Overhead wächst bei toollastigen Aufgaben überproportional.
- Taxonomie der Zusammenbrüche. Die MAST-Studie (Cemri et al.) analysierte mehr als 1.600 annotierte Traces aus 7 Multi-Agent-Frameworks und ordnete 14 Fehlermodi drei Kategorien zu: Systemdesign, Fehlabstimmung zwischen Agenten und Aufgabenverifikation. Die Autoren halten fest, dass die Leistungsgewinne auf populären Benchmarks oft minimal sind und in mehreren Fällen dasselbe Modell als Single Agent besser abschnitt.
- Debate wird standardmäßig überschätzt. Du et al. (2023) zeigten, dass mehrere debattierende Modellinstanzen Argumentation und Faktentreue verbessern können. Eine Auswertung von 2025 mit 5 Debate-Methoden auf 9 Benchmarks und 4 Modellen fand dann, dass sie Chain-of-Thought und Self-Consistency trotz deutlich mehr Rechenzeit bei der Inferenz oft nicht übertreffen. Geholfen hat Modell-Heterogenität: Debattierende aus verschiedenen Modellen.
- Parallele Schreiber kollidieren. Im April 2026 aktualisierte Cognition seine Sicht: Multi-Agent-Systeme funktionieren heute am besten, wenn Schreibzugriffe single-threaded bleiben und die zusätzlichen Agenten Intelligenz statt Aktionen beitragen; die meisten Schwarm-Ideen finden kaum Verbreitung. Anthropic nennt die meiste Coding-Arbeit ebenfalls einen schlechten Fit, weil sie sich kaum parallelisieren lässt.
Das Muster in diesen Quellen ist eine Trennung zwischen Lesen und Schreiben. Lesen, Suchen, Analysieren und Prüfen lassen sich gut parallelisieren, weil jedes Ergebnis für sich beurteilt werden kann. Code schreiben, geteilten Zustand ändern und Designentscheidungen treffen nicht, weil jede Aktion Entscheidungen trägt, die die anderen Agenten nicht sehen.
Verifikation ist die zweite wiederkehrende Lücke. Prüft niemand das zusammengeführte Ergebnis, pflanzen sich Fehler fort; Googles Zahlen zeigen, wie viel ein zentraler Validierungsschritt eindämmt. Behandle den Merge-Schritt deines Orchestrators als Ort für explizite Prüfungen und miss das Gesamtsystem mit Evals für das Feature, nicht durch das Lesen einiger Traces.
Ein Entscheidungsrahmen
Das ist die Tabelle, die ich im Design-Review verwenden würde. Die Frage lautet nie „Single oder Multi“, sondern welche konkrete Form sich für diese Aufgabe auszahlt.
| Situation | Signal | Muster | Warum |
|---|---|---|---|
| Breite Recherche über viele unabhängige Quellen | Teilaufgaben vorab unbekannt und größer als ein Kontextfenster | Orchestrator-Worker | Isolierte Fenster geben Breite; Anthropic berichtet hier große Gewinne bei etwa dem 15-Fachen der Tokens eines Chats |
| Bekannte Menge unabhängiger Prüfungen oder Abfragen | Dieselbe Operation über N Elemente, keine Abhängigkeiten | Paralleler Fan-out (Sectioning) | Wanduhrzeit sinkt, außer einem Merge keine Koordination nötig |
| Folgenreiche Ausgabe, bei der ein zweiter Blick Fehler findet | Review profitiert davon, die Annahmen des Autors nicht zu teilen | Writer und Critic mit frischem Kontext | Unabhängige Prüfung; idealerweise ein anderes Modell, wie die Debate-Studie nahelegt |
| Mehrere Domänen mit verschiedenen Tools oder Prompts | Routing zwischen Spezialisten, jeweils einer aktiv | Handoff | Jeder Spezialist bekommt einen kurzen Prompt und wenige Tools; entscheide, wie viel Verlauf mitwandert |
| Eine Nebenaufgabe mit lauter Ausgabe | Logs, Suchergebnisse oder Dateiinhalte, die du nicht mehr brauchst | Subagent, der eine Zusammenfassung zurückgibt | Hält den Hauptkontext sauber, Preis ist der Neustart ohne Kontext |
| Mehrschrittige Arbeit, deren Schritte voneinander abhängen | Planung, Refactoring, ein Dokument, geteilter Zustand | Einzelner Agent | Sequenzielle Aufgaben verschlechterten sich in Googles Studie bei Multi-Agent-Varianten um 39 bis 70 % |
| Parallele Änderungen an derselben Codebasis | Widersprüchliche Stil- und Randfall-Entscheidungen | Ein Schreiber, Helfer nur lesend | Cognition: Schreibzugriffe single-threaded halten |
Steht in einer Zeile „einzelner Agent“, ist die übliche Lösung für ein kriselndes System nicht ein weiterer Agent, sondern ein besserer Harness: klarere Anweisungen, bessere Tools, Compaction und Checkpoints. Anthropics eigener Rat in Building effective agents lautet, die einfachste mögliche Lösung zu suchen und die Komplexität nur zu erhöhen, wenn sie die Ergebnisse nachweislich verbessert; außerdem warnt der Beitrag, dass Frameworks Prompts und Antworten verschleiern und das Debugging erschweren können.
Eine Checkliste, bevor du einen Agenten hinzufügst
- Baue zuerst die Single-Agent-Baseline, mit denselben Tools und einem fairen Token-Budget.
- Schreibe das Isolationsargument auf: Was bleibt aus wessen Kontext draußen.
- Ordne die Arbeit als leselastig oder schreiblastig ein. Halte Schreibzugriffe single-threaded.
- Gib jedem Worker ein vollständiges Briefing: Ziel, Ausgabeformat, Tools, Grenzen und Abbruchbedingung, denn er erbt nichts.
- Lege explizite Skalierungsregeln in den Lead-Prompt und eine harte Obergrenze für Worker und Durchläufe.
- Füge einen Verifikationsschritt auf das zusammengeführte Ergebnis hinzu und entscheide, wer „fertig“ sagen darf.
- Evaluiere beide Versionen zunächst an etwa 20 realistischen Anfragen, wie Anthropic vorschlägt, und erweitere dann die Menge. Vergleiche Qualität, Tokens, Latenz und Fehlerrate.
- Protokolliere jede Delegation mit Briefing und Zusammenfassung, um verlorenen Kontext zu debuggen, und plane, wie laufende Agenten ein Deployment überstehen.
Zum letzten Punkt: Anthropic merkt an, dass Agentenprozesse zustandsbehaftet und langlaufend sind, und nutzt deshalb Rainbow Deployments, die den Traffic schrittweise verschieben, statt laufende Durchläufe zu unterbrechen. Kostenkontrolle gehört zur selben Disziplin; die Werkzeuge aus Token-Spar-Tools für Coding-Agenten gelten auch für Worker.
Was ich tun würde
Für einen typischen Unternehmensfall würde ich einen einzelnen Agenten mit starken Tools und gutem Harness ausliefern und genau ein Multi-Agent-Element ergänzen, wo das Isolationsargument stark ist: einen Research-Subagenten, der belegte Zusammenfassungen liefert, oder einen Reviewer mit sauberem Kontext für die Ausgabe. Beide lassen die Schreibzugriffe bei einem Agenten und sind leicht gegen die Baseline zu messen.
Schwärme gleichberechtigter Agenten, offene Debatten zwischen Agenten desselben Modells und parallele Code-Schreiber würde ich meiden, bis sich die Evidenz ändert. Selbst Cognition, der lauteste Kritiker, beschreibt inzwischen eine engere Klasse von Multi-Agent-Designs, die funktionieren. Die jüngeren Herstellerbeiträge, die ich gelesen habe, beschreiben dieselbe Form: ein Orchestrator, der den Kontext besitzt, mit isolierten Helfern, die Zusammenfassungen zurückgeben. Diese Architektur lohnt sich zu lernen, und sie passt gut zu der KI-Engineering-Arbeit, die ich für Kunden mache.
Quellen
- Anthropic Engineering: How we built our multi-agent research system
- Anthropic: Building effective agents
- Cognition: Don't Build Multi-Agents (12 June 2025)
- Cognition: Multi-Agents: What's Actually Working (22 April 2026)
- Google Research: Towards a science of scaling agent systems
- arXiv 2512.08296: Towards a Science of Scaling Agent Systems
- arXiv 2503.13657: Why Do Multi-Agent LLM Systems Fail? (MAST)
- arXiv 2305.14325: Improving Factuality and Reasoning in Language Models through Multiagent Debate
- arXiv 2502.08788: Stop Overvaluing Multi-Agent Debate
- OpenAI Agents SDK: Handoffs
- Claude Code documentation: Subagents
Häufige Fragen
Wann sollte ich ein Multi-Agent-System statt eines einzelnen Agenten einsetzen?
Wenn die Arbeit breit statt tief ist: viele unabhängige Fragen, Quellen jenseits eines Kontextfensters oder Nebenaufgaben, die das Hauptgespräch mit Ausgaben fluten würden. Anthropic nennt breitenorientierte Recherche als Idealfall. Hängen die Schritte voneinander ab oder teilen viel Kontext, ist ein einzelner Agent meist besser.
Wie viele Tokens mehr verbrauchen Multi-Agent-Systeme?
Anthropic berichtete, dass Agenten etwa 4-mal mehr Tokens verbrauchen als Chat-Interaktionen und Multi-Agent-Systeme etwa 15-mal mehr. Die Analyse des BrowseComp-Benchmarks ergab, dass allein die Token-Nutzung etwa 80 % der Leistungsvarianz erklärte. Ein Teil des Gewinns ist also schlicht mehr Rechenaufwand.
Warum scheitern Multi-Agent-LLM-Systeme?
Die MAST-Studie mit mehr als 1.600 annotierten Traces aus 7 Frameworks ordnet 14 Fehlermodi drei Gruppen zu: Systemdesign, Fehlabstimmung zwischen Agenten und Aufgabenverifikation. In der Praxis sind das vage Aufgabenbeschreibungen, Kontext, der den nächsten Agenten nicht erreicht, doppelte Arbeit und niemand, der das Ergebnis prüft.
Lohnt sich Multi-Agent-Debate?
Selten als Standard. Das ursprüngliche Debate-Paper berichtete bessere Argumentation und Faktentreue, doch eine spätere Auswertung von 5 Debate-Methoden auf 9 Benchmarks fand, dass sie Chain-of-Thought oder Self-Consistency trotz mehr Rechenaufwand oft nicht schlagen. Verschiedene Modelle als Debattierende halfen in dieser Studie.
Was ist der Unterschied zwischen Handoff und Subagent?
Ein Handoff übergibt die Kontrolle: Der nächste Agent übernimmt das Gespräch, standardmäßig mit dem vollständigen Verlauf. Ein Subagent bekommt eine Nebenaufgabe in frischem Kontext und liefert nur eine Zusammenfassung zurück, während der Aufrufer die Verantwortung behält. Handoffs eignen sich zum Routing zwischen Spezialisten, Subagenten zur Kontext-Isolation.
Sollten Coding-Agenten Subagenten parallel laufen lassen?
Mit Vorsicht. Cognition argumentiert, dass parallele Schreiber widersprüchliche implizite Entscheidungen zu Stil und Randfällen treffen, und sagt, Multi-Agent-Setups funktionierten heute am besten, wenn Schreibzugriffe single-threaded bleiben. Subagenten für Exploration, Suche und Review sind der sichere Einsatz.